大模型服务的核心战场,正从简单的单轮对话逐步转向检索增强问答(rag)、多文档摘要以及长程agent等更复杂的任务场景。这类新型负载具备一个显著共性:单次请求的prompt通常由数十乃至上百个语义彼此独立的片段拼接而成——包括检索出的文档内容、技能描述、记忆快照、历史交互轮次等,被统一组装为数万甚至数十万token的超长上下文。
在此规模下,预填充(prefill)阶段成为单请求最主要的算力消耗环节,也成为服务商最突出的成本瓶颈;更严峻的是,一旦缓存未命中,尾部首token延迟(TTFT)可能飙升至数十秒,严重破坏用户交互体验。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
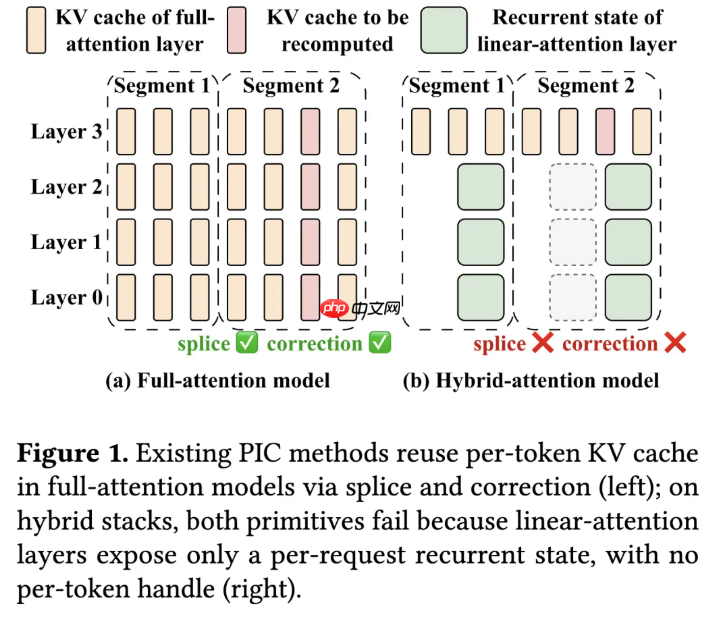
为应对这一挑战,业界主要演化出两条降本路径。其一是位置无关缓存(Position-Independent Caching, PIC),它突破传统前缀缓存对严格连续性的依赖,允许每个语义独立片段仅缓存一次,并可灵活拼接到任意前缀之后,天然契合RAG与Agent中动态组装prompt的范式。其底层机制可抽象为两个核心原语:沿token维度直接拼接的splice,以及通过重算少量token来恢复跨段上下文一致性的correction。另一条路径则是混合注意力架构——用线性注意力替代大部分全注意力层,将注意力计算复杂度从O(n²)压缩至O(n),并将无界的历史信息压缩为固定尺寸的循环状态。近期主流生产模型如MiniMax-M1、Ring-2.5、Qwen3.5、Kimi-Linear等,普遍将75%以上的网络层替换为线性注意力,仅保留少量全注意力层以维持关键建模能力。以Qwen3.5-35B-A3B为例,其40层中即有30层采用线性注意力设计。
矛盾由此而生:当前PIC机制作用于逐token粒度的KV缓存,而线性注意力层对外仅暴露一个per-request级别的循环状态,完全缺失逐token层面的缓存接口,导致splice与correction在绝大多数线性层中无法实施。换言之,混合注意力模型中占据主体的线性层,恰恰处于现有PIC能力覆盖范围之外。此前,尚无任何系统能在混合注意力大模型上真正落地位置无关缓存。
小红书大模型推理团队联合北京大学、上海交通大学共同提出HYPIC,首次在混合注意力大模型上实现了完整的位置无关缓存支持。该系统在4个工业级混合注意力模型、5类典型工作负载上的实测表明:首token延迟平均降低3.25倍;在相同SLO约束下,可持续QPS提升1.66倍;任务质量相较完全重算仅下降1.71分。其技术内核围绕三大协同机制展开:针对线性层的状态高效复用、面向全注意力层的跨段注意力修复,以及面向冷请求的段级并行加速。

在线性层方面,HYPIC引入“转移算子”(Transition Operator)作为缓存单元,实现常数时间的状态组合。一种朴素的PIC设想是:将两段各自的零初值末状态简单相加。该策略在基础线性注意力中成立,但在引入衰减因子、门控机制或delta擦除等增强设计的先进线性注意力模型(如RetNet、Mamba2、GLA、DeltaNet、GDN、KDA等)中会失效。被忽略的关键变量是一段内部累积的转移算子T_C——即该段所有token转移矩阵的连乘结果;真实末状态应满足S(C₁·C₂) = T(C₂)·S(C₁) + S(C₂),而简单相加恰恰遗漏了T(C₂)项,造成结构性偏差。实验显示,在RetNet慢衰减头中,仅256 token长度下误差已达状态范数的22%。HYPIC的关键洞察在于:T_C与零初值末状态S(C|0)均仅由片段内部token决定,与前缀无关。因此,系统在片段首次prefill时同步缓存二元组(T_C, S(C|0)),复用时依组合律左乘T_C再叠加S(C|0),即可在常数时间内高精度还原任意前缀下的末状态,且天然兼容全部线性注意力变体。实测在Qwen3.5-35B-A3B模型第0层上,组合后状态与完全重算结果差异仅为6×10⁻⁵,处于FP16数值噪声范围内。对于含因果卷积或RoPE位置编码的变体,HYPIC分别通过卷积状态热身与状态重旋转两个补丁完成严格对齐。
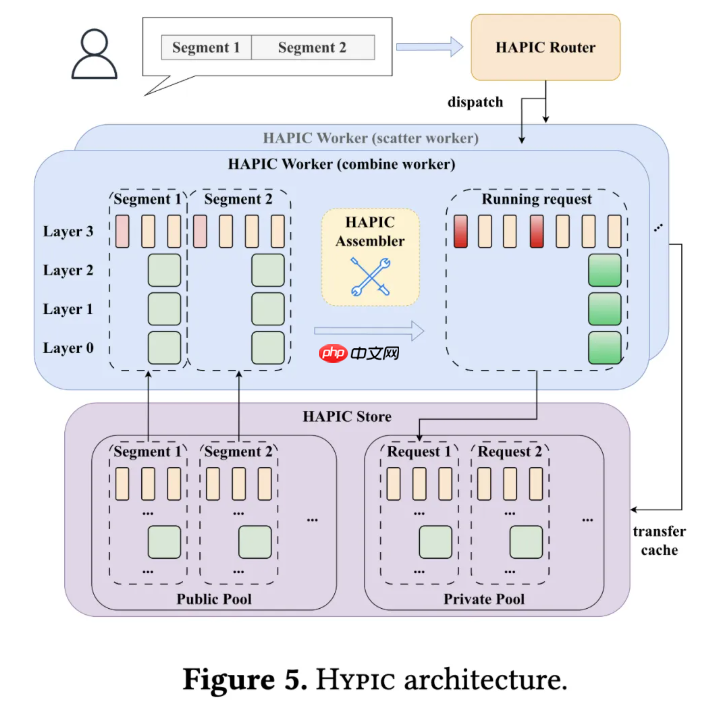
在全注意力层方面,HYPIC采用“缝合窗口”(Seam Window)机制解决跨段注意力失准问题。尽管混合模型中全注意力层数量有限,但其仍需PIC支持;然而传统选择性重算难以迁移——因下方线性层仅保留末状态,中间token信息不可向上穿透。若选择逐token缓存循环状态,或从头重新递推,则分别面临存储爆炸与计算冗余的困境。团队发现:KV拼接后的注意力偏差高度集中于各复用片段起始处,其余区域几乎不受影响,该现象与全注意力模型中的attention sink特性一致,并在混合架构中同样存在。据此,HYPIC为每个内部片段头部w个token构建缝合窗口,默认w=8:缓存时不纳入该窗口,复用时在完整前缀下重算这些token,以精准校正跨段注意力。由于实际片段长度通常远超512 token,缝合窗口占比极小,重算开销可控。为支撑该机制,线性层在复用过程中需实时计算缝合窗口自身的T和S,在推进running state的同时,将每个seam token的逐层输出前传至上层全注意力层。
第三项关键技术是段并行(Segment-level Parallelism),它将“长冷请求”也纳入可加速范畴。缓存未命中不可避免——语料持续演进、低频文档被剔除,而长冷请求正是尾延迟的主要来源。现有系统仍将整条prompt视为单一单元,在单实例上串行执行所有冷片段prefill,TTFT随O(n·|C|)增长;张量并行等实例内优化虽能提升单次前向速度,但扩展性受限——一条100k token请求在TP-8配置下仍需17.7秒。而PIC已赋予每个片段自包含性:其prefill结果仅取决于内部token。HYPIC顺势提出实例间段并行:Router实时探测每段缓存命中状态,将冷片段并行分发至多个scatter worker,再由combine worker聚合各段结果生成完整运行状态,从而将冷prefill复杂度由O(n·|C|)降至O(⌈n/m⌉·|C|+c)。为最大化吞吐,HYPIC采用LPT(最长处理时间优先)贪心策略均衡worker负载,并将每段计算与传输流水线化,避免combine worker被突发同步传输阻塞;段并行与实例内并行(TP/DP/SP)作用于正交维度,可无缝协同。
该系统已在SGLang框架中完整实现,代码总量约14k行(含Python与Triton),部署于8×H20节点集群。评测覆盖4个生产级混合注意力模型(Ring-mini/flash-linear-2.0、Qwen3.5-35B-A3B/122B-A10B)、4个公开基准数据集(HotpotQA、TriviaQA、MultiNews、GovReport)及1条真实RAG生产trace。全量预热后,HYPIC相较Prefix Cache将p50 TTFT平均降低3.25倍(各模型区间为2.77×–4.05×),质量损失微乎其微——16组“模型×数据集”平均仅落后完全重算1.71分,在Qwen3.5-35B上甚至反超0.47分;作为对照,未缓存T_C的朴素相加方案直接导致66.9%分数损失,验证了T_C的关键价值。在生产RAG trace中,同1秒TTFT SLO约束下,HYPIC相较Prefix Cache将可持续QPS提升1.66倍(1.49×–1.85×),峰值单卡吞吐提升约1.3–1.5倍。在纯冷未命中路径下,一条32k token请求的TTFT由单worker的2.83秒降至8worker的0.49秒,实现5.7倍加速,且绝大部分收益来自近似线性扩展的scatter阶段;面对不均匀分片,LPT策略相较Round-Robin将TTFT由1.26秒压至0.84秒(3.6× vs 2.4×)。系统开销亦高度可控:构造(T_C, S(C|0))的一次性开销,在最复杂的稠密转移模型上也仅为prefill主前向的5.2%–6.7%,一次构造、多次复用即可充分摊薄。
HYPIC首次将位置无关缓存成功拓展至混合注意力大模型:以缓存段级累积转移算子实现线性层的常数时间状态组合,以轻量缝合窗口修复全注意力层的跨段对齐,再以段并行将长冷请求转化为可规模化加速的负载。它使RAG与Agent等长上下文服务,在采用高效混合架构的同时,也能充分享受片段级缓存复用带来的性能红利。研发团队表示,后续将重点探索分布式PIC管理与调度、多级缓存分层治理等方向,持续推动大模型推理向更快、更省、更具扩展性的目标演进。