69岁正是“创”的年纪!
强化学习奠基人、2024年图灵奖得主Richard Sutton宣布,自己已与学生Khurram Javed共同离开John Carmack创办的Keen Technologies,正式创立全新AI研究机构——Oak Lab。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
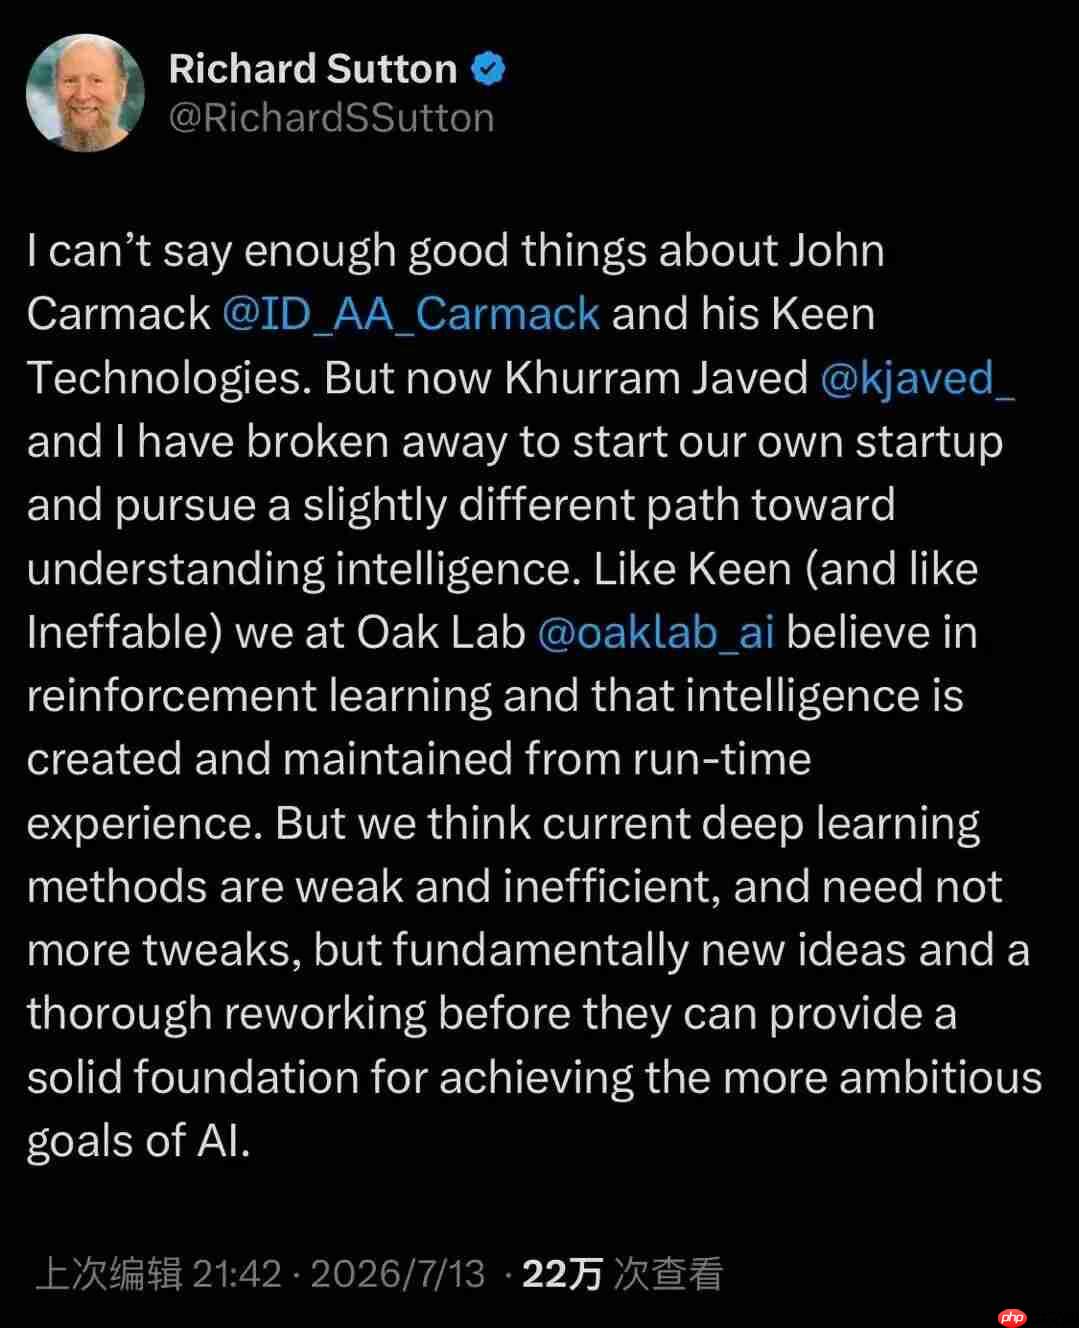
Richard Sutton被公认为现代强化学习体系的奠基者:
本科就读于斯坦福大学心理学系,博士阶段师从强化学习先驱Andrew Barto,早期科研足迹遍及GTE Labs与AT&T Labs;
他首创时序差分(Temporal Difference)学习算法,与Barto合著的经典教材《Reinforcement Learning: An Introduction》(《强化学习导论》)至今仍是全球高校与工业界的标准参考;
自2003年起,他长期执教于加拿大阿尔伯塔大学,创建并领导该校强化学习与人工智能实验室(RLAI);
2017至2023年间,担任DeepMind杰出研究科学家,并主导组建DeepMind位于埃德蒙顿的研究中心。
四十余载耕耘,Sutton培养出大批影响深远的AI领军者:
包括AlphaGo核心架构师David Silver、DeepMind蒙特利尔实验室负责人Doina Precup、博弈智能专家Michael Bowling,以及此次携手创业的青年学者Khurram Javed。
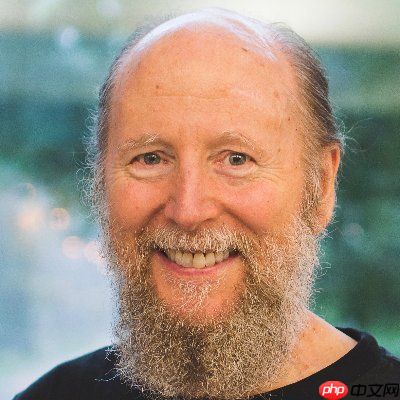
据其公开推文透露,Sutton此次创业的动因极为清晰:
他认为当前主流深度学习范式存在根本性局限——效率低下、泛化脆弱、难以支撑真正意义上的通用智能演进。
这不是局部优化的问题,而是底层思想亟待更迭:必须抛弃渐进式修补,转向基础理论与系统架构的彻底重构。
换言之,Sutton判断:现有技术路径已逼近AGI天花板,无法自然延伸至更高阶的认知能力。
而Oak Lab锚定的终极愿景是:
构建一个参数规模达万亿级、支持运行时实时学习与动态规划、整机功耗严格控制在20瓦以内的自主智能体。
20瓦,正对应人类大脑平均能耗水平。
当整个行业仍在竞相扩建数据中心、堆叠GPU集群之时,这位强化学习的开创者正试图重写“智能”的物理与认知边界。
与卡神分道,但未失敬意
要理解Sutton为何离开,需回溯他出发的地方。
Keen Technologies由传奇游戏编程大师、Oculus前CTO、被誉为“卡神”的John Carmack于2022年创立,聚焦强化学习驱动的AGI探索。
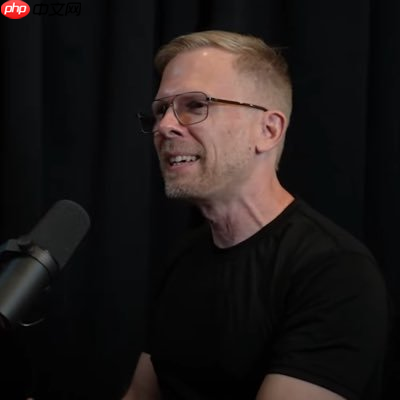
2023年9月,Sutton加入Keen——彼时正值DeepMind关闭其在加拿大埃德蒙顿设立的联合实验室,双方合作被视为理论与工程的“黄金组合”:
一边是操作系统与实时系统领域的传奇工程师,一边是强化学习数学框架的奠基人,共同目标直指2030年前实现具备初步AGI特征的原型系统。
然而不到三年,Sutton选择独立前行。
他在X平台发布的声明中,首句即致敬Carmack:
“关于John Carmack和Keen Technologies,我怎么夸都不为过。”
潜台词明确:离开并非否定对方,而是对“抵达终点的方式”产生了不可调和的理念分歧。
在Sutton看来,当下深度学习的发展逻辑已陷入路径依赖——模型迭代不再指向能力跃迁,而沦为超参数微调与数据管道的重复劳动。整个领域亟需一场范式级的重启。
Oak Lab的核心命题
Sutton此次创业所押注的核心理念,可凝练为一句话:
真正的智能,诞生于运行过程中持续生成的经验流。
当前大语言模型的工作范式,本质是“离线锻造+上线复用”:耗费数月、动用千卡集群,在海量静态文本上完成预训练;一旦部署,模型权重基本冻结,仅能通过有限上下文做浅层响应。
即便每日接收亿万条用户交互,绝大多数信息都无法转化为模型内在能力的实质性更新——它无法像生物体那样,在感知—行动—反馈的闭环中实时重塑自身认知结构。
Oak Lab所构想的智能体则截然不同:
它将始终处于“在线状态”:感知环境、执行动作、接收反馈、即时修正策略;
每一次真实世界的交互,都同步触发一次学习更新;
学习不再是周期性批量任务,而是与生存行为无缝耦合的连续过程。
正如Sutton所强调:
AI运行的每一毫秒,都应是它成长的时刻。
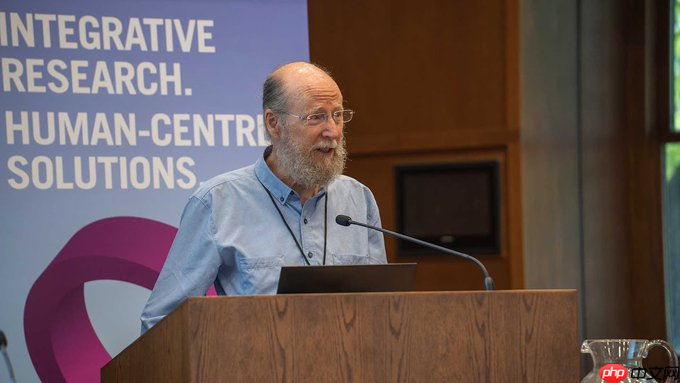
目前,Oak Lab已明确以OaK架构为技术主线推进研发。
OaK即Options and Knowledge(选项与知识),代表一种面向经验自主涌现的认知操作系统。
该架构旨在让智能体从原始交互中自动提炼具有时间延展性的高层抽象结构,并将其固化为可验证、可调度、可组合的“技能单元”。
举例而言:机器人首次前往厨房取水,全程涉及空间识别、路径规划、物体抓取、阀门操作等多重子任务;
传统方法将其视作单一长序列决策问题;
而OaK架构会引导智能体在实操中自主归纳出“导航至厨房”“握持容器”“开启水源”等模块化技能;
未来面对相似目标时,系统可直接调用已有技能库,并依据实时环境变量进行动态编排与微调。
这种沿时间轴压缩经验、升维抽象的能力,即“时间抽象”,正是人类将零散动作沉淀为熟练技能的关键机制,也是OaK赋予AI的底层认知杠杆。
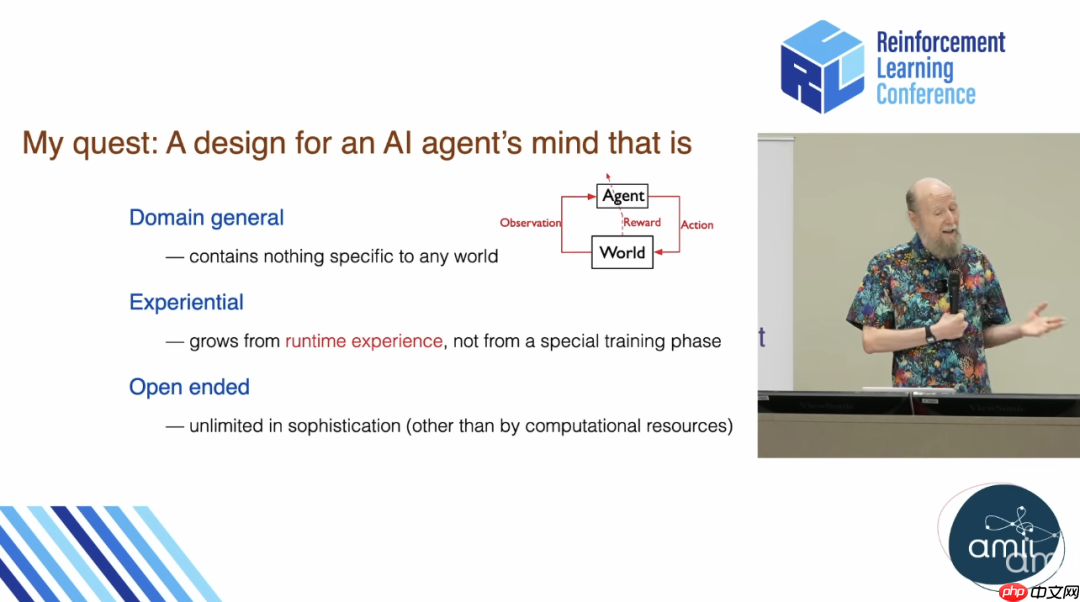
此外,OaK架构还设定了一个与当前深度学习显著背离的设计原则:
不存储历史经验,不回放旧数据。
主流深度强化学习依赖经验回放缓冲区(replay buffer),反复采样过往交互样本进行批量训练;
Oak Lab则主张采用batch size = 1的纯在线学习模式——每获得一条新经验,即刻完成单步参数更新。
团队相信,若将此类算法与事件驱动型神经网络结合,有望将计算开销与能耗压降至现有方案的百分之一甚至更低,从而真正释放实时、持续学习的工程可行性。
由此催生那个极具挑战性的远期目标:万亿参数、实时学习、实时规划、20瓦功耗。
当然,这仍属蓝图阶段。
支撑这一构想的,还有Sutton与Javed近期提出的大世界假说(The Large World Hypothesis):
其核心主张是——现实世界的复杂度永远超越任何模型的表征上限。无论AI如何进化,外部环境的变化速率与信息熵增长速度只会更快。
因此,依赖离线数据集训练的模型注定滞后;唯有具备选择性记忆、主动遗忘、持续在线适应能力的系统,才可能与真实世界共演化。
从《苦涩的教训》到创业实践
熟悉Sutton思想脉络的人,对上述路径并不意外。
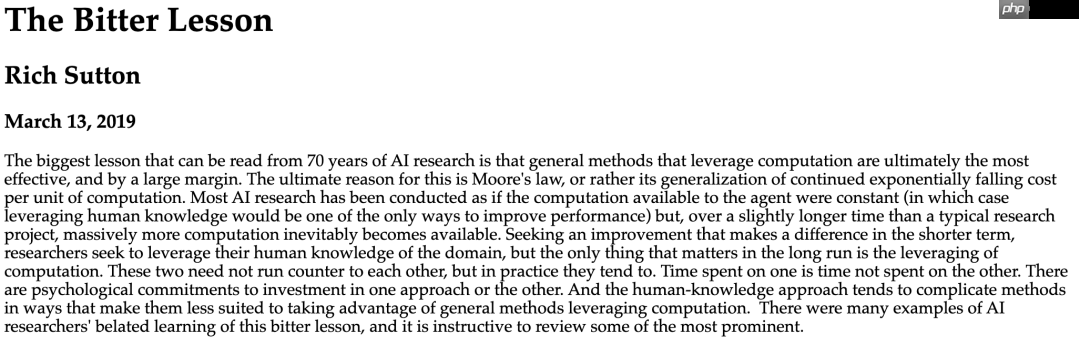
2019年,他写下AI圈影响深远的短文《苦涩的教训》(The Bitter Lesson),系统梳理了国际象棋、围棋、语音识别与计算机视觉的发展史,最终得出关键结论:
那些能随算力指数扩展的通用学习与搜索机制,终将碾压一切嵌入人类先验知识的定制化方案。
大模型时代的爆发,似乎印证了这一判断:更大规模、更强算力、更广数据,的确推动能力边界不断外推。
但Sutton并未因此认可现状。
在他看来,当前系统仍深陷“人类知识代理”的窠臼——所有训练数据均由人类生产、标注、筛选、清洗、组织;模型所学,不过是人类文明已有表达的统计压缩。
真正的智能体,必须拥有“第一人称经验”的生成能力:通过自主行动探索未知、遭遇失败、建立因果、追求长期目标,并在此过程中创造属于自己的新知识。
这也正是他从“苦涩的教训”迈向“经验时代”的思想跃迁。
2025年,他与AlphaGo核心开发者David Silver共同提出:AI演进将进入以持续经验生成为标志的新阶段,数据来源正从“人类供给”转向“智能体自产”。
Oak Lab,正是这一学术主张走向产业落地的第一块试验田。
四十年前,Sutton在博士论文中写下“temporal credit assignment in reinforcement learning(强化学习中的时序信用分配)”时,强化学习尚属边缘冷门;
四十年后,当全球资本与算力奔涌向大模型商业化浪潮,他依然执着叩问同一个本源问题——
智能,究竟如何从无到有?
One More Thing
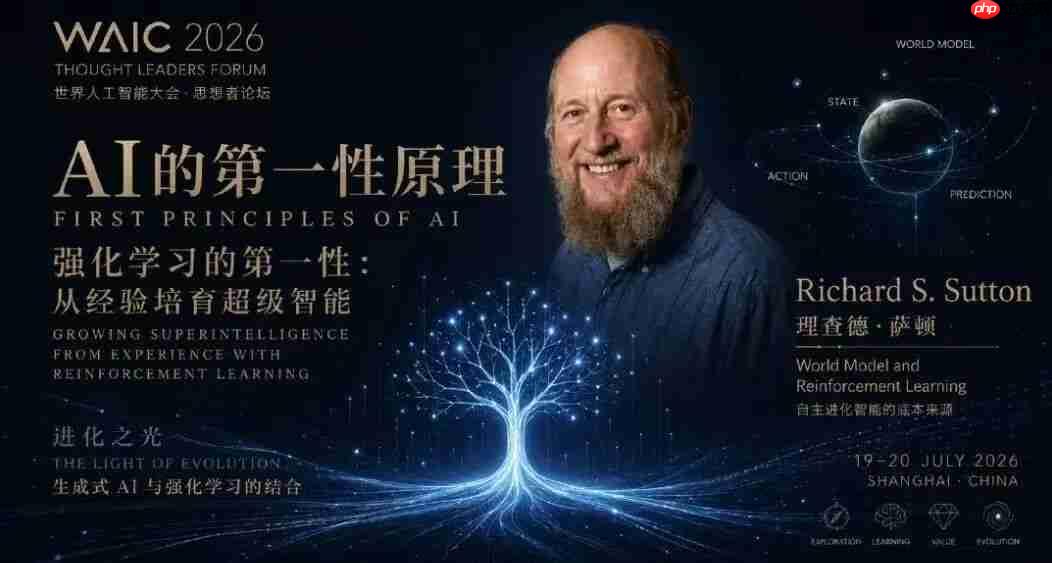
老爷子创业后的首个公开亮相,选在上海WAIC世界人工智能大会。
在WAIC思想者论坛上,Sutton将发表题为《强化学习的第一性:从经验培育超级智能》的主题演讲。
参考链接:https://www.php.cn/link/a6dc4fa9360888fd04a80b9754f41924
本文来自微信公众号“量子位”,作者:关注前沿科技,36氪经授权发布。