


近日,由德国人工智能协会牵头组建的研究联盟正式推出全新开源大语言模型——soofi s30b-a3b。这一发布不仅体现了欧洲在构建自主可控ai基础设施方面的关键突破,也为强调性能与能效并重的开源大模型生态带来了重要补充。
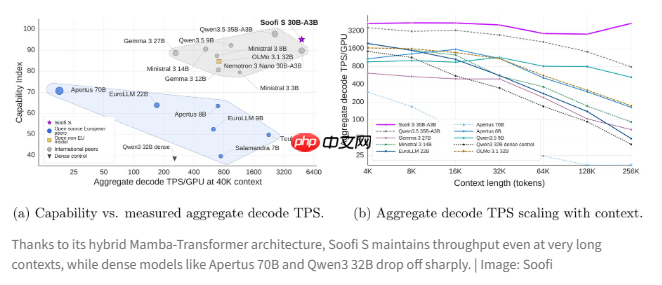
该模型在结构设计上别具巧思。Soofi S创新性地融合了Mamba-2架构与标准注意力机制,构建出一种轻量高效的“混合专家”(MoE)结构。其总参数规模达316亿,但在实际推理过程中,每处理一个token仅需激活约32亿参数。这种稀疏化策略显著压缩了计算开销,使其运行效率更贴近中小规模模型,同时在高并发、高吞吐场景下展现出卓越响应能力。尤其在长文本建模任务中优势突出——当上下文长度扩展至4万token时,其生成吞吐量约为同级别传统稠密模型的8倍,且随上下文增长仍维持高度稳定的输出表现。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
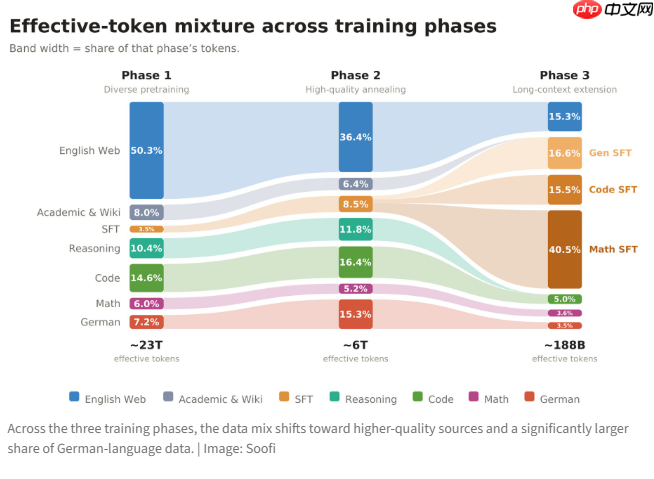
在训练数据构建方面,Soofi S体现出鲜明的本地化导向。整个训练过程覆盖27万亿token,研究团队系统性提升了德语语料权重:从初始阶段的7.2%逐步提升至第二阶段的15.3%,并整合了德语报纸、维基百科条目及工程技术手册等多元权威来源,从而大幅增强其在德语专业场景下的理解与生成能力。

将小说章节转换为电影分镜剧本。用户上传txt/md/docx文本,AI分析场景、角色、情绪、镜头语言,输出专业分镜脚本。适用于用户提及“分镜”“storyboard”“小说转分镜”“影视改编”“镜头脚本”或需要将小说改编为分镜的场景。
基准评测结果验证了其综合竞争力。Soofi S在英语与德语双语评估中均位居当前主流开源模型前列,全面超越OLMo332B和Apertus70B等代表性模型。在代码合成、领域逻辑推理以及德国本土知识问答等专项测试中,该模型持续展现顶尖水准。但研发团队也坦诚指出,其在超长上下文信息抽取任务及德语数学推演类问题上尚存优化空间。
项目成功落地依托于坚实的技术底座。全部训练工作在慕尼黑德国电信工业人工智能云平台完成,动用512块Nvidia B200 GPU协同运算。作为欧盟IPCEI-CIS战略项目的重要组成部分,该模型全程采用可再生能源供电,并承诺分阶段开源模型权重、训练与评估代码、以及完整数据构成清单。此举既贯彻了开放协作的研发哲学,也为欧洲制造业、工程服务等垂直领域提供了值得信赖的AI技术支撑。随着开源进程推进,研究团队正广泛邀请产业界伙伴参与合作,重点探索其在技术文档智能解析、自动化编程辅助等实际应用场景中的落地潜力。














