上市并不等于抵达安全港,反而往往要直面资本市场更为严苛的审视与情绪波动。
这一点,正真切地体现在中国大模型领域的两大领军者——智谱(02513.HK)与MiniMax(00100.HK)身上。
继今年3月同步披露首份年度财报、并不约而同提出高度相似的AGI价值公式后,两家公司又几乎在同一时间发布了面向全员的内部信。
智谱创始人唐杰在信中系统阐释了其对AGI的理解,并宣布启动「Touch High(摸高)计划」:未来将持续深耕AGI底层研究,暂不将重心转向短期商业化变现。
而就在数日前,MiniMax创始人闫俊杰也在内部信中宣告:自即日起,直至公司真正实现AGI之日,他将不再领取任何薪酬。
单从形式看,智谱的信更侧重长期技术愿景,MiniMax则采用了资本市场尤为青睐的“创始人零薪”信号;前者偏理想主义,后者显现实取向。但两封信背后折射出的,却是共同的现实压力:
当市场逐渐认清“Token不经济”的本质,大模型的价值评估逻辑正在悄然重构。
01 为何恰在此时?
智谱内部信题为《巨浪已来》,MiniMax则命名为《向天空的尽头》。仅从标题便可见端倪:一个锚定海洋纵深,一个仰望苍穹极限——二者都在技术维度上表达了对AGI的不懈追寻。
但若跳出技术话语,这两封信发布的时间点更值得深究。
第一,双方均迎来上市后首次“解禁大考”。
解禁本身不等于抛售,却可能成为公司真实价值的一次集中检验。
本质上,解禁为基石投资者提供了兑现窗口。他们将依据模型迭代节奏、商业化进展、训练效率等关键指标,判断是否继续持有。而他们的选择,势必牵动股价走势与市场信心。
第二,两家公司都迫切需要更多“弹药补给”。
MiniMax港股IPO净募资约54.61亿港元,上市仅半年,已有约77%资金投入研发与基建,公司坦言资金消耗速度超出预期。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
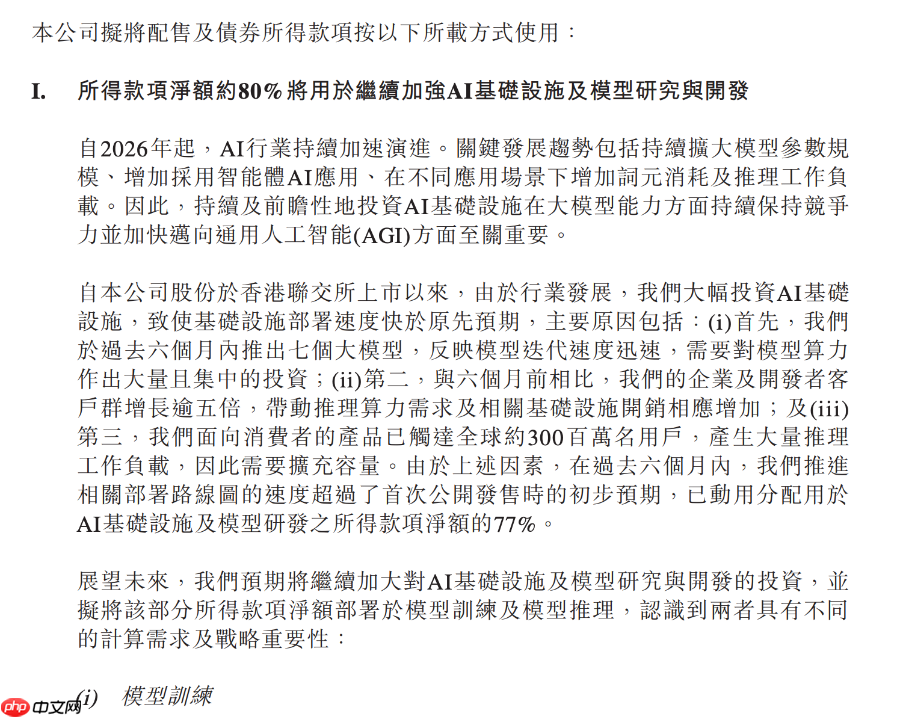
另一边,智谱上市前募集总额约50亿港元,同期资金使用率已达93%。
烧钱速度远超预设节奏,双方均亟需开辟新的融资通道。
一方面,是谋求从港股回归A股。此前MiniMax与智谱均已公开表示,正推进A股IPO申报或接受上市辅导。
另一方面,则是启动港股再融资。
智谱拟通过H股配售募资约314.1亿港元,达年初IPO金额的6倍;MiniMax则采取“新股配售+可转债”组合方式,合计募资160.4亿港元,约为IPO募资额的3倍。
从资金用途看,二者高度趋同:均明确投向基础模型迭代、算力基础设施升级及商业化拓展。
差异在于路径偏好:智谱重生态扩张,MiniMax强应用整合。
智谱特别提及资金将用于战略投资与并购,凸显其构建AI生态版图的强烈意图。
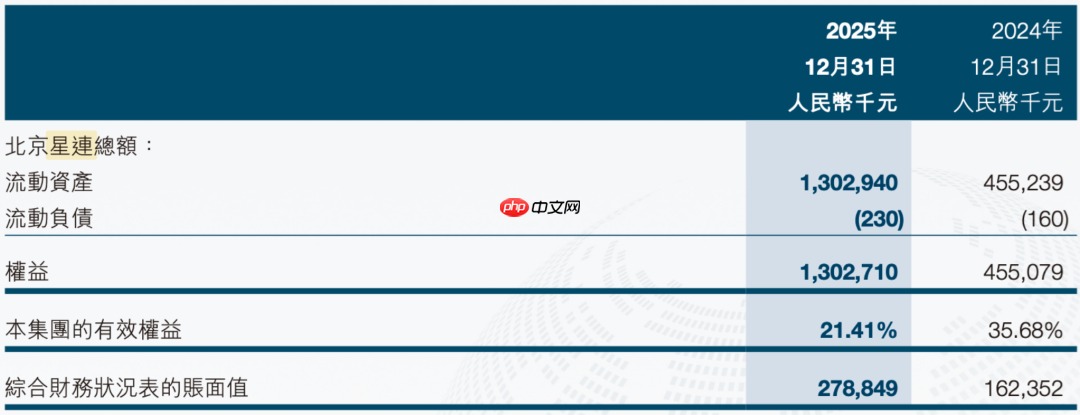
智谱多次以LP身份参与设立基金。据其2025年财报披露,由其参与发起的星连资本已投出30余个项目,整体估值达13.027亿元,增幅高达186.26%,作为LP的智谱所持账面权益约2.79亿元。
MiniMax则强调资金将聚焦于Harness类AI原生产品的全球商业化与开发。
这与其凭借Agent赛道收获的关键高光密不可分——OpenClaw爆火之际,MiniMax依托M2.5与M2.7模型实现53天高频迭代,精准卡位Agent渗透红利期。
然而很快,两家头部玩家几乎同时撞上同一堵墙。
02 同样撞上的那堵墙
这堵墙,名为:Token不经济。
回溯至今年年初首份年报发布之时,智谱与MiniMax曾给出惊人一致的公式表达:
智谱称:“AGI商业价值 = 智能上界 × Token消耗规模”;MiniMax表述为:“平台价值 = 智能密度 × Token吞吐量”。

双方共识清晰:智能上限与Token消耗呈强关联,这也代表当时行业的主流认知。
但现实很快给出反向反馈——海量Token订单并未换来等比例的实际交付成效,“Token越来越贵”“token plan定价争议”迅速成为行业热议焦点。
所谓“Token不经济”,即:Token用量持续攀升,模型厂商为覆盖成本上调API价格,下游用户却需承担不断上涨的成本;一旦效果未达预期,质疑便会直接指向模型本身能力。
这恰如大模型领域的“灰姑娘水晶鞋效应”:用户对AI模型的期待,就像灰姑娘等待一双合脚的水晶鞋——唯有真正契合业务场景、解决实际问题的SOTA模型,才能锁定用户、提升留存。
意识到此的智谱与MiniMax,开始同步调转方向,集中攻坚“Token不经济”这一核心痛点。
在模型层面,重点突破两大能力:Coding能力与长程任务能力。
具体而言,Coding能力直击Token定价难题,长程任务能力则关乎Token交付实效。
一方面,国内大模型厂商从Anthropic获得的重要启示是:Coding不仅是Token商业化变现的核心抓手,更易实现溢价;同时还能规避“做模型还是做产品”的创新困局。
MiniMax Agent首席架构师阿岛曾在采访中坦言:“当下做通用Agent应用的一大困境在于,你的创新成果,终将被模型自身吸收内化——甚至你写的许多Skill,未来或许都不再需要。”
而Coding场景天然契合“模型即产品”逻辑。编程能力领先的模型厂商,在观察到新解锁的应用场景与用法后,能迅速将其沉淀、融合进下一代模型与Agent产品中,让高黏性企业客户与开发者第一时间感知技术跃迁。
长程任务能力,则直指模型落地实效。
唐杰在内部信中指出:当前模型最激动人心的突破,在于能自主完成一项极长周期的任务——不再是即时问答,而是跨越数周、数月乃至数年的规划与执行。
换言之,为支撑更复杂、更持久的任务交付,两家厂商正将底层模型的编程能力、工具调用、深度搜索、多步任务编排等能力,封装成标准化、可调用、可交付的Agent工作流。例如MiniMax推出的MiniMax Agent,正是这一思路的具象呈现。
03 谁被低估了?
因内部信发布时间高度重合,两家公司自然被置于聚光灯下反复比对。
最直观的差异,是市值表现。
截至发稿,智谱市值逾7000亿港元,MiniMax则接近700亿港元,相差整整十倍。如此悬殊的估值落差,也引发投资者追问:同样具备独立大模型基因、同样处于亏损阶段,为何走出截然不同的资本路径?
第一,智谱拥有清晰参照系。
早期智谱便将自身定位为“中国版OpenAI”,并在业绩电话会上大量对标Anthropic;此次内部信中,更特别强调“极致的安全治理”。
而Anthropic凭借长期押注Coding路线,已实现对OpenAI的阶段性反超——无论估值还是年度经常性收入(ARR),均展现强劲增长势能。
智谱较早布局Coding方向,为其B端收入的可见性打下坚实基础。相较之下,MiniMax选择BC双轮驱动叠加原生多模态路线,虽更具灵活性,却因缺乏明确对标对象,在资本市场眼中确定性略显不足。
第二,智谱享有技术基础设施溢价。
从“摸高计划”的表述可见,智谱明确表态:短期内不追求应用层变现。
此前,DeepSeek与智谱被曝正联合自主研发AI推理芯片,旨在降低对英伟达、华为等外部芯片供应商的依赖。智谱已与多家国产芯片设计企业展开初步接洽,计划为GLM系列大模型定制专属AI芯片。
这意味着,智谱向资本市场传递的,不仅是一家模型平台商,更是一个覆盖芯片、模型、应用的全栈AI基础设施提供商。这种宏大叙事,天然带来更高估值溢价。
但无论是智谱抑或MiniMax,资本市场的短期分化并非终局。内部信既是面向投资者的预期管理工具,也是组织内部的一次再动员。
谁被低估、谁被高估,本非核心命题。短期来看,财报基本面才是韧性的试金石:MiniMax需证明多元化路径的增长可持续性,智谱则需验证Coding先发优势能否转化为长期动能。
长远而言,中国大模型的竞争远未落幕。谁暂时落后、谁暂时领先,变局仍在持续演进。
本文来自微信公众号“硅基研究室”,作者:kiki,36氪经授权发布。