


【php中文网快讯】今日,在光合组织2026智能计算应用大会现场,中科曙光正式宣布国内首个全自主可控的十万卡级ai超大规模集群——“曙光8000”(登峰)建成并投入运行,并已同步接入国家超算互联网。此举标志着我国ai算力基础设施全面迈入十万卡规模化部署新阶段,正式告别万卡时代。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
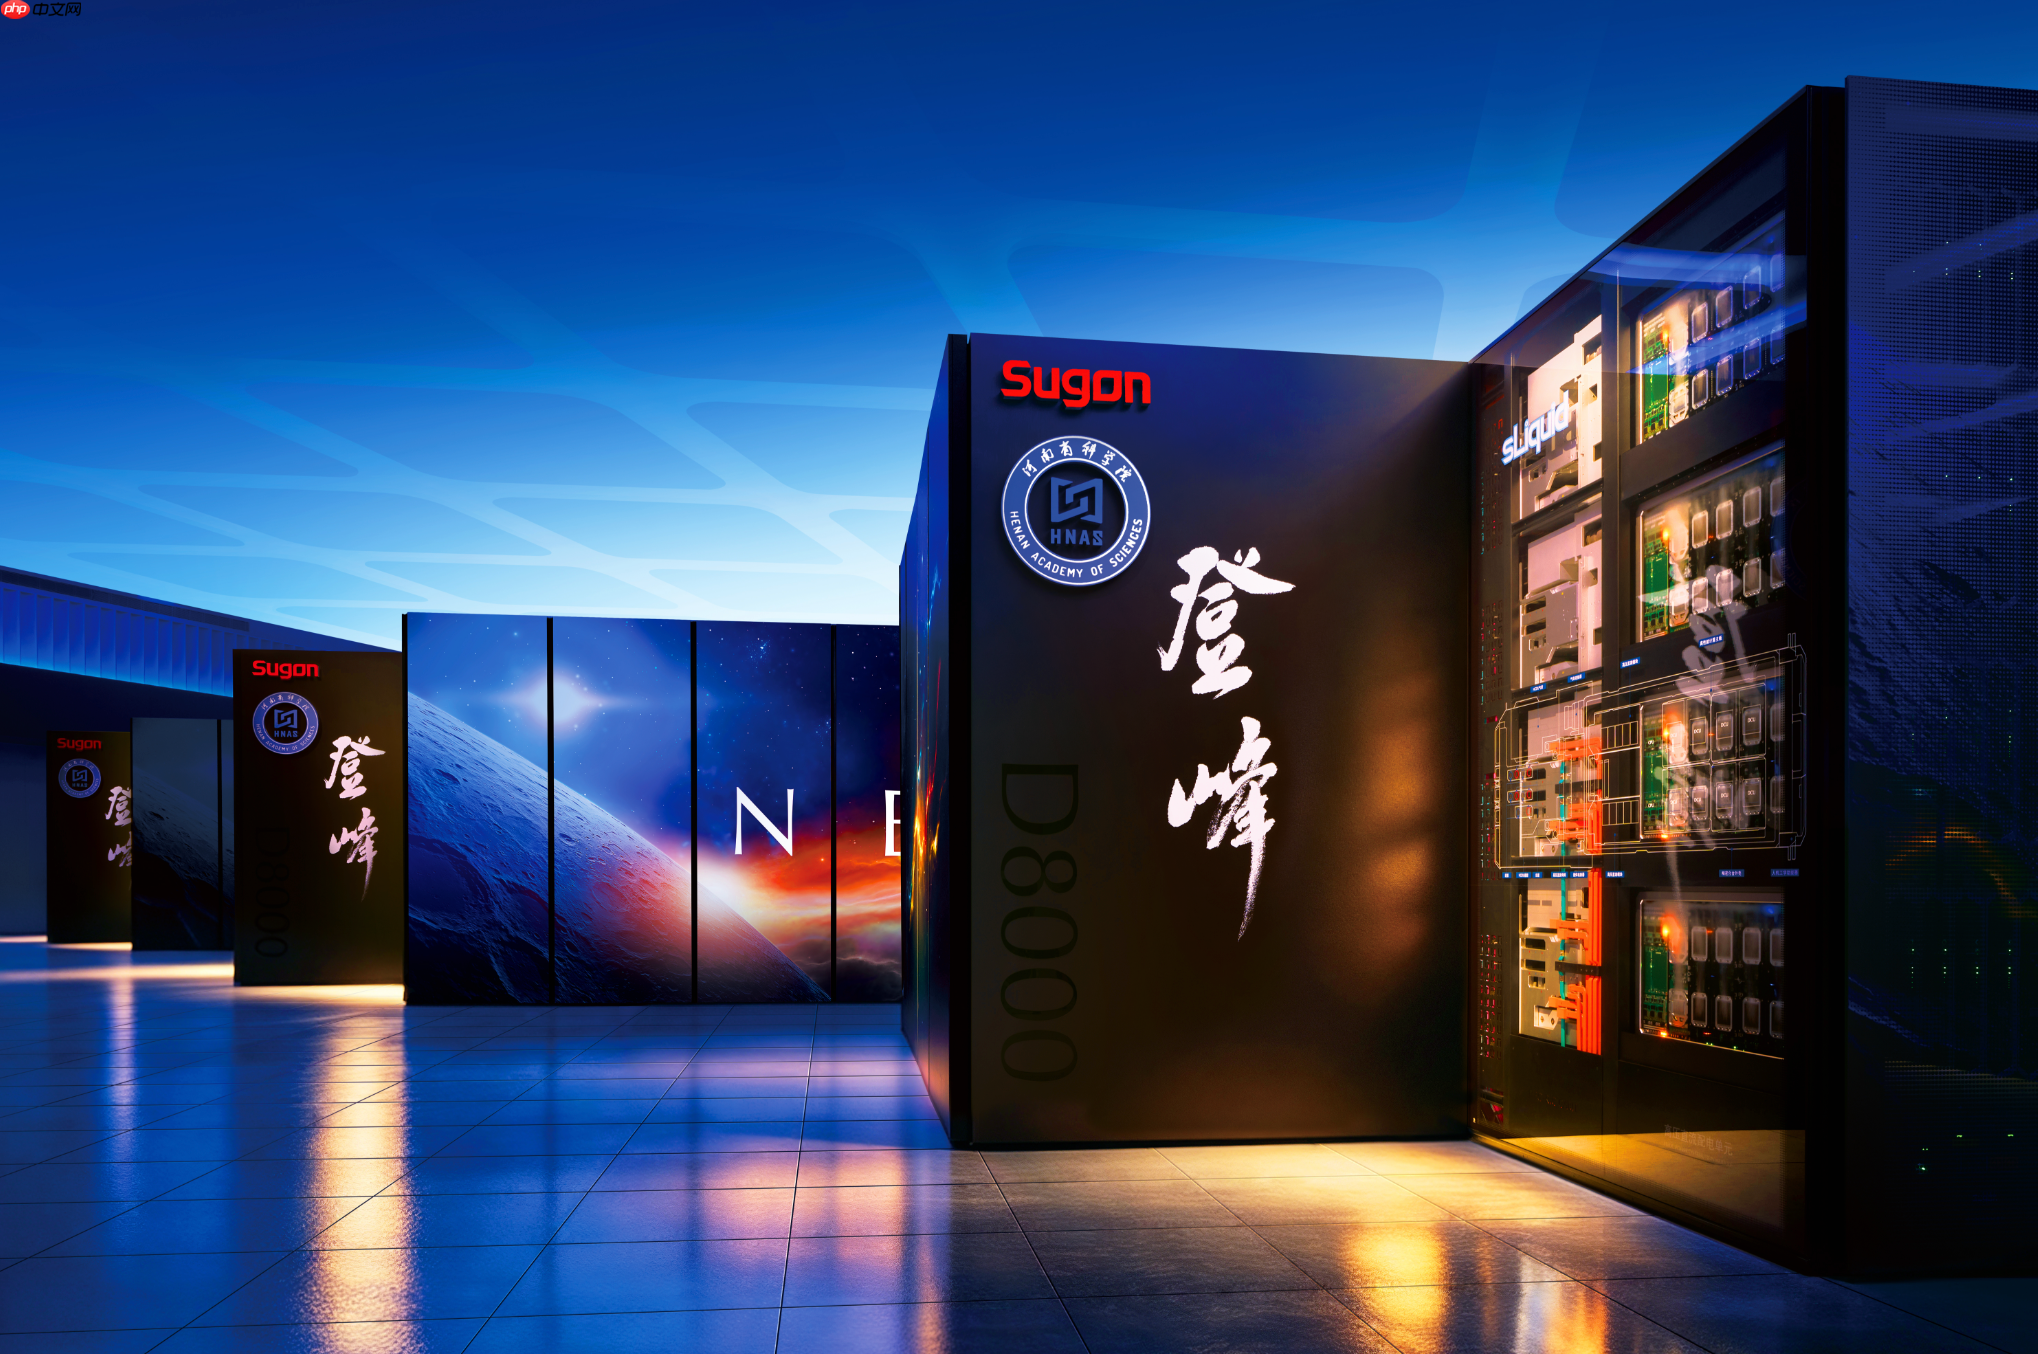 图片来源:中科曙光微信公众号
随着大模型训练、科学智能(AI for Science)、AI智能体等前沿应用加速落地,算力需求持续攀升,集群规模正由千卡、万卡向超大规模演进。面对高并发请求、高吞吐任务及多精度混合负载的复杂场景,十万卡级AI超集群已成为支撑下一代人工智能发展的关键底座与基本门槛。相较万卡系统,十万卡集群在整体架构设计、高速互联网络、内存带宽与访问延迟、能效管理以及产业链协同等方面均面临更高维度的技术挑战。
“曙光8000 登峰”的成功部署,为行业提供了首个可复制、可推广的十万卡级算力中心建设范式。这也推动算力平台评价体系发生根本性转变:不再仅聚焦于硬件数量或理论峰值性能,而是更强调系统级综合调度能力、真实业务负载下的运行效率,以及对科研攻关与产业落地的实际赋能价值。
该集群采用“超智融合”技术架构,打破传统通用计算与智能计算分域部署的边界,实现二者原生一体化协同调度;全面支持FP64至INT8全精度计算,可灵活承载科学仿真、大模型预训练与微调、实时AI推理、工业数字孪生等多样化科研与工程任务。
整套系统实现从芯片、计算单元、存储系统、高速网络、液冷散热,到上层应用与技术服务的全栈国产化自主可控。底层算力基于海光国产高性能CPU构建;scaleFabric原生RDMA网络确保十万级节点间低时延、高可靠互联;ParaStor分布式存储系统在2026年全球IO500榜单中斩获生产环境全节点与10节点组别双料冠军;配套浸没式相变液冷方案支持单机柜兆瓦级功率密度部署,结合国产环保冷媒与全年自然冷却策略,显著提升整机柜能效比(PUE)。平台同步构建开放生态,面向高校、企业及开发者提供覆盖软硬一体、训推融合、运维托管的全栈算力服务。
目前,“曙光8000 登峰”已完成与国家超算互联网的深度对接,纳入全国一体化算力网络体系,并面向高校、科研机构、中小企业及个人开发者提供普惠化算力资源。现阶段,其核心十万卡节点已完成超过300项“超智融合”类应用的适配与性能优化,覆盖大模型研发、具身智能机器人、智能网联汽车、创新药物发现、先进材料模拟、量子算法验证、气象预测及天文数据分析等二十余个重点领域;其中70余项典型应用已稳定支持万卡级并行扩展,充分验证了系统在长期高负载工况下的鲁棒性与可靠性。
“曙光8000 登峰”的全面落地,完成了我国在十万卡级全自主AI算力集群领域技术路径、产业生态、应用场景与服务体系的闭环验证。本届大会上,中科曙光还与北京科学智能研究院签署战略合作协议,正式启动第二套全国产化十万卡“超智融合”算力系统的联合研制与建设工作。在AI发展回归理性、注重实效的当下,具备全精度计算能力的十万卡级智能算力中心,正从示范标杆迈向规模化复制,成为驱动人工智能深度赋能科学研究与实体经济转型升级的核心新型基础设施。













