


“世界模型”大概是近两三年ai圈中最火爆也最模糊的术语之一。
黄仁勋在GTC大会上将“物理AI”与“世界模型”并列为下一代人工智能的核心支柱;自动驾驶厂商坚称世界模型是实现L4+高阶智驾的必由之路;机器人公司则宣称其世界模型已赋予机械臂跨场景通用操作能力;甚至一批视频生成团队,也将最新模型冠以“世界模型”之名,逻辑简单粗暴——能生成连贯视频,就等于建模了世界。
如今,“世界模型”正迅速演变为AI领域的新一代“万能贴纸”,一如前两年的元宇宙、去年的大模型热潮:只要打上这个标签,便自动获得通往资本聚光灯与媒体头条的快速通道。
这股热潮背后,实则是整个行业对大语言模型边际效益持续收窄的集体不安:当互联网文本数据几近枯竭,当AIGC内容的新鲜感迅速消退,AI迫切需要下一个万亿级落地入口——它必须从比特空间跃入原子世界,从信息处理迈向实体操控。
正因世界模型所承载的潜力与想象空间巨大,其距离真正实用仍隔着多重现实障碍。它并非单一技术点的突破问题,而是概念定义、数据获取、架构设计三重维度交织缠绕的系统性困局;每一层迷雾之下,都映射着AI向物理世界迁移时不得不直面的认知断层。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
定义先行,共识滞后:一场各取所需的命名狂欢
世界模型遭遇的首重困境,恰恰出现在它最喧嚣的地带——即概念本身。
大量视频生成模型、三维重建工具、多模态基础模型纷纷启用“世界模型”作为新头衔,但业内对其内涵、技术路径、评估体系始终缺乏统一认知。同一词汇,在不同企业口中,指向的技术实质可能截然不同。
这种混乱绝非偶然。概念失焦的本质,是各类玩家正借“世界模型”这一宏大叙事,争夺下一代AI技术话语权。
对内容生成厂商而言,将视频生成包装为世界模型,是把AIGC的旧剧本升级为“可交互虚拟世界”的新故事线,估值逻辑随之跃升一个量级。
机器人企业口中的世界模型,则特指机械臂对物体材质、空间位姿、接触反馈等物理属性的实时建模能力,意在硬件同质化红海中构筑差异化技术护城河。
自动驾驶公司所言的世界模型,核心在于对交通参与者运动轨迹、环境动态变化的毫秒级预测能力,是从被动感知转向主动预判的关键跳板,亦是高阶智能驾驶叙事不可或缺的一环。
而对英伟达这类基础设施提供商来说,世界模型是以Omniverse等仿真平台为底座,贯通“感知-仿真-决策”全链路的基础能力引擎,目标是面向全行业输出可复用的通用建模范式。
迥异的商业诉求,使同一个术语被塞进完全不同的技术内核。
为厘清乱象,李飞飞教授在今年6月发布的长文中提出一套分类框架,尝试为当前纷杂的世界模型实践提供观察坐标。她将其划分为三大类:
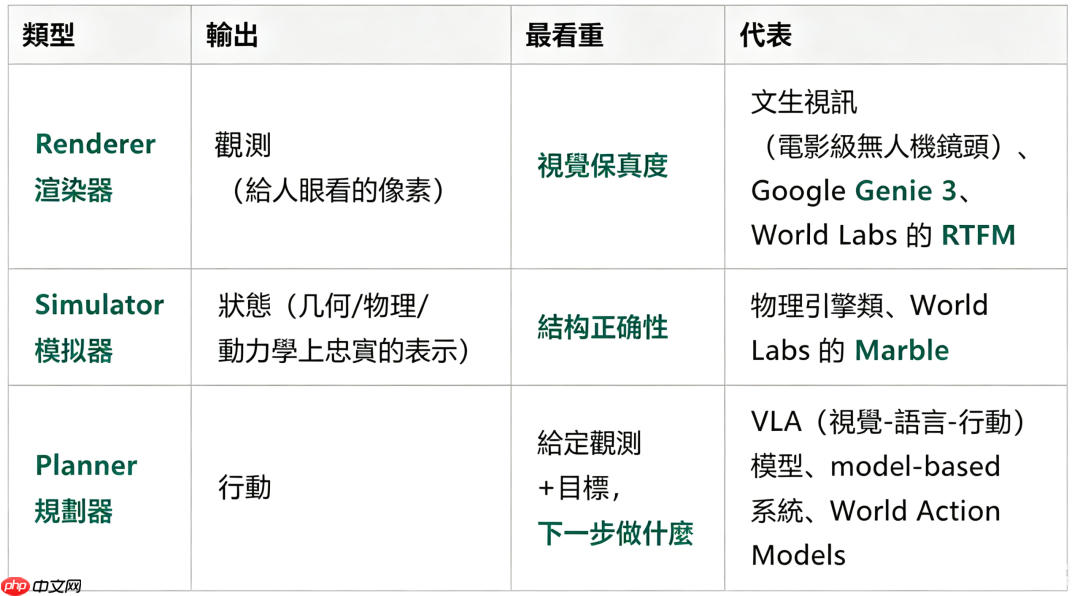
渲染器专注“视觉可信度”,产出高质量像素与视频流,但不保障物理合理性与几何一致性。代表模型如谷歌Genie、OpenAI Sora,核心评价指标为视觉真实感与时空连贯性。
模拟器追求“结构精确性”,输出非图像而是几何网格、材质参数、碰撞体等底层物理数据。典型如NVIDIA Omniverse物理仿真模块、Unity PhysX AI,构成数字孪生与工业仿真的关键基座。
规划器则承担“认知桥梁”角色,在感知输入与动作执行之间构建因果链条,使智能体具备行动前推演世界状态变化的能力。例如自动驾驶中的轨迹预测网络、机器人运动规划模型,直接支撑决策闭环。
但这一分类本身恰恰揭示了深层问题:当一个技术概念需耗费整篇长文来界定边界,说明它尚未进入技术收敛期。
回望深度学习发展历程,2012年前同样存在多路线混战局面,但最终依靠数据规模与算力优势完成路径收束。而世界模型至今仍未形成统一基准:视频生成类依赖FVD(Fréchet Video Distance)、CLIP Score等视觉指标;机器人方向采用抓取成功率、任务完成率等行为指标;自动驾驶领域则聚焦轨迹预测误差、人工接管频率等安全指标。没有共通标尺,便无迭代坐标——这场概念之争,大概率还将延续相当长一段时间。
比特易得,原子难驯:两种世界的成本法则根本错位
训练大语言模型,数据近乎取之不尽:网页、书籍、论文、社交媒体帖文,爬取即可用,标注成本极低。但要训练一个真正理解物理世界运行规律的模型,所需的数据类型却截然不同——必须是带有精细几何标注、物理参数、动作语义及时间同步的多模态交互数据。
差异根源在于信息维度本质不同。文本是离散、标准化、单模态的符号系统,词义相对稳定,标注门槛低;而物理世界是连续、高维、多因果耦合的复杂系统。“拿起纸杯”这一最基础动作背后,牵涉视觉纹理识别、空间深度估计、手指施力反馈、纸杯形变响应、摩擦系数适配、加速度曲线拟合等数十种物理变量,且所有信号须在微秒级完成严格时间对齐,稍有偏差即丧失训练价值。
更严峻的是,即便不惜重金采集到数据,也不等于获得了“对的数据”。
真实物理数据采集成本高得惊人。以自动驾驶为例,单台测试车搭载激光雷达、多目摄像头、IMU等传感器,硬件投入超百万元;每小时真实道路采集数据叠加标注、车辆运维等隐性成本,综合开销可达数千元;若要覆盖雨雪夜行、施工路段、异形障碍物等长尾场景,需百万公里级路测数据,总成本堪称天文数字。机器人领域挑战更大——Figure AI曾披露,人形机器人每小时真实操作数据采集成本,约为大语言模型文本数据的数千倍,还需额外承担硬件损耗与安全事故风险。
目前世界模型的实际应用,基本仍局限于自动驾驶、电子游戏等特定可控场景,数据规模与多样性远不足以支撑通用模型构建。而真实物理世界场景具有无限延展性:不同光照下的材质反射、不同磨损程度的表面摩擦、不同角度的碰撞能量耗散……这些长尾现象恰恰是检验模型泛化能力的试金石,却永远无法靠穷举采集全部覆盖。
合成数据一度被视为破局关键。借助物理仿真引擎或游戏引擎批量生成虚拟数据,成本显著低于真实采集。
当前主流方案已形成三类路径:
一是依托MuJoCo、Bullet、PhysX等经典物理引擎生成标准化动力学数据集,如DeepMind DM Control Suite、OpenAI Gym。
二是采用域随机化(Domain Randomization)策略,通过随机扰动仿真环境的光照、纹理、材质参数等方式提升模型鲁棒性。OpenAI Dactyl机械手即为典型案例:在仿真中通过随机调整摩擦系数、灯光强度等参数训练,最终成功在真实环境中完成魔方旋转任务。
三是引入生成式AI补全视觉细节,利用扩散模型生成逼真纹理,缩小虚实视觉鸿沟。英伟达Drive Sim即采用该技术增强仿真场景真实性。

用于在用户想通过浏览器自动化与 Google Gemini 或 ChatGPT 交互时。触发短语包括“ask Gemini”“ask ChatGPT”“ask GPT”“让...”。
但这条路径的暗礁,比多数人预估得更深。
许多人误以为“仿真→现实”鸿沟仅在于画面不够逼真,实则核心矛盾在于物理分布偏移:仿真引擎中设定的摩擦系数、弹性模量、空气阻力等参数均为理想化常量,而真实世界中这些物理量随温度、湿度、磨损、老化等因素持续动态变化——一块橡胶在不同工况下的摩擦特性千差万别,此类细微差异,仿真系统难以100%复现。
业内已有公开测试表明:在仿真环境中抓取成功率高达98%的机器人模型,迁移到真实场景后成功率常骤降至60%以下;即便加入域随机化优化,也难以突破85%瓶颈,剩余差距仍需依赖真实数据微调填补。
当下流行的“真实数据闭环”“合成预训练+真实微调”混合范式,本质上只是缓解矛盾的折中方案,尚无法根治底层问题。
比特世界的增长遵循边际成本趋零律,而原子世界的演进则恪守“每进一步皆需真金白银”法则。这种底层经济逻辑的根本冲突,正是世界模型无法绕行的天然天堑。
三条路径,三种世界观:AI如何表征世界?
纵使达成概念共识、解决数据瓶颈,还有一个更本质的问题横亘眼前:究竟该用何种架构,去构建一个真正意义上的世界模型?
这个问题的深层本质,是AI应在哪个抽象层级“刻画世界”——是像素层面、几何结构层面,还是更高阶的抽象状态层面?不同选择不仅导向截然不同的技术路线,更折射出彼此对立的认知哲学。
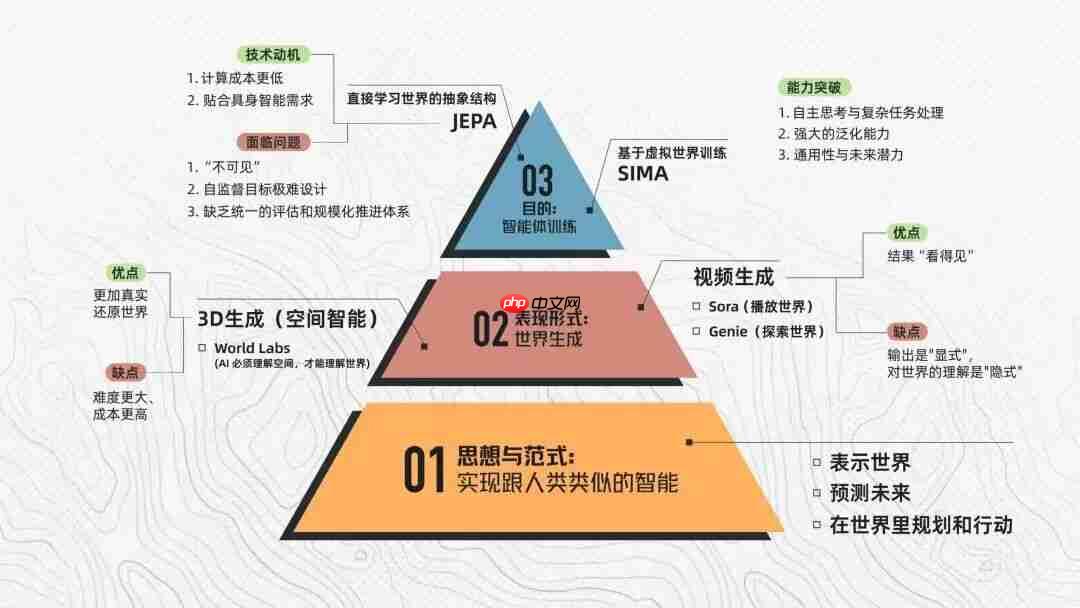
第一条路径,是以谷歌Genie3为代表的像素交互派,信奉“视觉即存在”。
其底层多基于时空扩散模型,在传统图像扩散基础上嵌入时间维度注意力机制,让模型学习帧间运动连续性。Genie3支持文本、图像、动作指令等多模态输入,可生成1080P分辨率交互式视频,用户可通过键盘鼠标实时操控画面角色移动与交互,模型即时生成逻辑自洽的后续帧,沉浸感突出。
该路径优势在于“变现路径短”:游戏开发、内容创作、数字人等场景可直接商用;训练数据门槛低,互联网海量视频皆可作为素材,模型迭代速度快。
但短板同样尖锐:像素级拟合≠物理级正确。它能生成杯子碎裂动画,却无法解释碎片飞溅方向背后的动量守恒原理,更无法预判不同地面材质导致的弹跳差异。业内测试显示,Sora生成视频中频繁出现物体穿模、能量不守恒、光影逻辑冲突等物理谬误。用此类模型指导实体机器人作业,如同让仅看过电影的人去操作数控机床——表象似真,实则隐患重重。
第二条路径,是以李飞飞World Labs推出的Marble模型为代表的空间结构派,秉持“结构先于物理”的信念。
该路线核心是从视觉输入中重建高精度三维空间结构,以几何表征替代像素表征。Marble模型可基于多视角图像输入,生成带语义标签、支持导出的3D网格环境,允许智能体在其内部导航、规划交互,生成的3D资产可无缝接入游戏引擎使用。
在自动驾驶领域,此路径已实现规模化量产。占用网络(Occupancy Network)已成为高阶智驾标配技术——它摆脱对高精地图依赖,仅凭车载多摄像头视觉输入,实时构建周围环境的3D体素空间,精准判定障碍物占据区域与可行驶空间。特斯拉、小鹏、理想最新智驾系统均已部署基于占用网络的空间世界模型,对异形障碍物、临时施工路障等传统感知盲区目标识别能力显著提升。
但其局限亦清晰可见:3D结构仅是物理世界的静态骨架,而世界模型的核心价值在于动态预测。它能准确还原斜坡倾角,却无法直接计算球体滚落加速度;能精细建模物体外形,却难以模拟软体变形或流体流动。从静态结构迈向动态物理建模,中间仍有漫长工程化征程。
第三条路径,是以杨立昆(Yann LeCun)提出的JEPA架构为代表的认知表征派,信奉“抽象即认知”。
它不生成任何像素,只预测抽象的世界状态表征,理论上最贴近人类大脑的“心智模型”。我们行走时不会在脑中渲染高清画面,只会预判脚下路况;投掷物品时不会逐像素计算轨迹,只需估算力度与落点。
技术实现上,JEPA通过编码器将原始图像映射至高维潜空间,再由预测器依据历史状态推演未来潜表示,全程不涉及像素生成,大幅降低计算负载,使模型更聚焦于语义级因果规律挖掘。
受同类思想启发的DreamerV3算法,已成为当前机器人强化学习主流方案之一:它在潜空间中构建世界模型,预测不同动作引发的环境反馈,并基于内部模型进行决策规划,无需频繁与真实环境交互,样本效率大幅提升。
该路径最逼近通用智能本质,却也最为遥远。潜空间表征本质是黑箱,模型究竟“理解”了什么难以追溯,出错时更难定位根因。更关键的是,抽象状态如何转化为精确电机控制指令?如何与底层运动规划系统无缝对接?目前尚无成熟通用方案,大多仅能在特定任务中实施端到端训练,泛化能力受限。
三条路径各有理论根基,亦各有不可逾越的短板。业内共识正逐渐形成:终极的通用世界模型,大概率将是三者融合的产物——以3D结构搭建物理骨架,以物理引擎注入硬性约束,以抽象表征驱动高层决策。目前英伟达的世界基础模型、特斯拉FSD端到端系统,均已开启多路线融合探索。但像素、几何、潜空间本属三套互不兼容的表征体系,要实现精准对齐与高效协同,本身就是世界级难题。
垂直先行,通用尚远:山脚仰望,步履未停
世界模型离真实世界,究竟还有多远?这个问题并无标准答案。
至少在未来三至五年内,它仍将处于持续演进与迭代阶段。当前的世界模型,恰如2012年前后的深度学习——彼时数据孤岛林立、技术路线未明、评测基准尚在争执,ChatGPT时刻尚未降临。
但世界模型所面临的挑战,或许比当年更艰巨。深度学习本质是模式识别,核心是挖掘数据中的统计规律;它的成功源于算力、数据与架构的共振,归根结底是一场统计拟合的胜利。而世界模型追求的是因果推理——理解物体为何如此运动、事件为何如此发生。
这两种能力之间,横亘的不只是几年技术迭代,而是根本性的认知范式跃迁。统计拟合可通过堆叠算力与数据实现突破,但因果推理要求对世界运行底层规律的抽象建模,这更接近人类智能的核心能力,因而也更难攻克。
当然,通用世界模型虽远,其阶段性价值却不容低估。在通往通用的路上,垂直场景的率先落地已悄然展开。自动驾驶领域,世界模型将在高速、城区等限定场景中率先实现对行人、车辆行为的精准预判,显著提升系统安全性与乘坐舒适性;工业机器人领域,特定工位定制化世界模型将加速产线换型调试,降低部署成本;游戏与数字孪生领域,交互式世界生成技术已初步商业化,为后续研发提供可持续资金反哺。这些垂直场景数据可控、需求明确,将成为世界模型技术迭代的“练兵场”。
从长远看,我们无需执着于“世界模型”这一标签本身,亦不必拘泥于某一条技术路线。真正值得追寻的,是让AI从“看见世界”迈向“理解世界”,从像素级模拟升维至因果级推理。
一旦跨越这道门槛,AI将不再仅是数字世界的创作工具,而将成为物理世界的通用决策主体。届时,它带来的不会是个别产品的升级,而是整个工业体系、交通网络、生产方式的底层重构。从这个意义上讲,今日所有的概念纷争、数据困局、架构分歧,都不过是黎明前必经的跋涉;所有迷雾,终将被技术前行的脚步逐一吹散。
本文来自微信公众号“极智GeeTech”,作者:半山,36氪经授权发布。













