


7月9日,蚂蚁灵波正式开源 lingbot-video——全球首个基于混合专家(mixture-of-experts, moe)架构、专为具身智能定制的开源视频生成基础模型。该模型紧扣机器人与具身智能的核心诉求,重构视频预训练范式,在推理速度、物理合理性、动作语义理解及任务执行完整性等关键维度实现系统性突破,标志着视频基础模型正从数字内容生产迈向真实物理世界交互的新阶段,也为行业提供了首个面向具身智能的高质量开源底座。
在由北京大学联合字节跳动构建的机器人操作视频评测基准 RBench 上,LingBot-Video 以总分 0.620 领跑,显著优于 Wan2.6(0.607)、Seedance1.5Pro(0.584)和 Cosmos3Super(0.581)。RBench 聚焦于评估模型生成视频是否符合现实世界的物理约束与机器人行为逻辑。这一成绩印证了 LingBot-Video 在生成机器人操作类视频时,具备更强的动作合理性保障与端到端任务完成能力。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
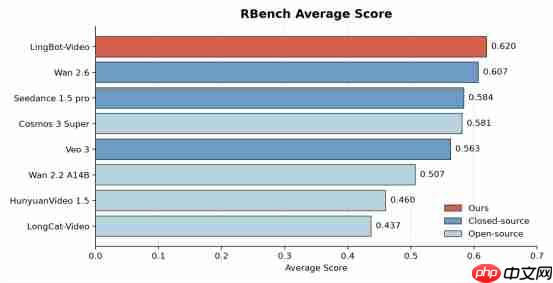
(图说:LingBot-Video 在 RBench 基准中综合表现最优)
为更全面检验其对物理动态建模的能力,蚂蚁灵波还设计了一套内部 benchmark,从通用视频质量与具身任务适配性两大维度展开横向对比。结果显示,在与 NVIDIA Cosmos3、Wan2.2A14B、LongCat-Video、Hunyuan Video1.5、LTX-2.3 等五大主流开源视频模型的比拼中,LingBot-Video 在具身相关场景下全面超越各基线模型。
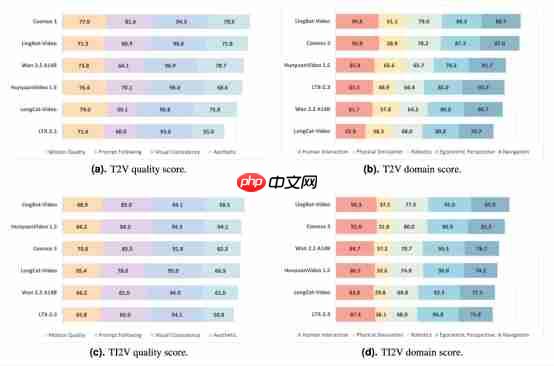
(图说:多维评测表明,LingBot-Video 在具身任务中展现出更优的物理规律遵循性与动作连贯性)
近年来,视频生成技术在画质清晰度、运动流畅性与艺术表现力方面持续跃升;但对具身智能而言,一段“视觉上逼真”的视频若缺乏真实的物理因果支撑,便难以驱动机器人进行连续感知、实时规划与可靠执行。与此同时,具身应用场景对模型响应延迟、计算开销与部署灵活性提出了更高要求。
由此,视频生成技术正悄然分化出两条演进路径:一条通往影视工业,服务于创意表达与内容消费;另一条则驶向机器人本体,致力于理解、预测并干预物理世界。LingBot-Video 正是蚂蚁灵波锚定后者所发起的关键技术探索。
该模型在架构设计、数据构建与训练策略三大层面实现了协同创新。
架构层面,LingBot-Video 采用 DiT(Diffusion Transformer)与 MoE 相融合的技术路线,以稀疏激活的专家机制替代传统稠密结构,在扩展模型容量的同时严格控制单次推理负载。其总参数量达 30B 的版本,在实际生成过程中仅需激活约 3B 参数,相较同规模 Dense 模型,推理效率提升近 3 倍。这种“大而快”的特性,既保留了大规模参数带来的强表征能力,又契合具身智能所需的低延迟响应需求。
数据层面,LingBot-Video 搭建了专属的数据画像引擎,在广泛采集互联网公开视频的基础上,深度整合 VLA(Vision-Language-Action)、VLN(Vision-and-Language Navigation)、Ego-centric(第一人称视角)等机器人领域数据源,覆盖灵巧抓取、自主导航、人机协同交互等典型具身场景,最终构建起高达 7 万小时的高质量具身视频数据集。这些数据使模型不再停留于像素级复现,而是深入学习动作意图、环境反馈与状态变迁之间的内在关联。
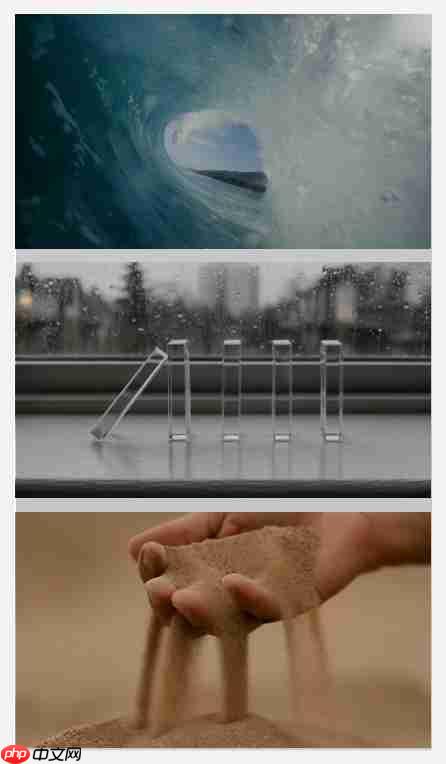
训练层面,LingBot-Video 引入多目标强化学习奖励机制。除常规的美学质量、文本对齐度与运动一致性等指标外,特别增设物理合理性(如重力响应、碰撞约束、能量守恒)与任务完成度(如目标抵达、物体操控成功)两大核心奖励信号,推动模型输出结果更贴近真实世界运行逻辑,也更适配机器人在物理空间中完成具体任务的实际需求。
据悉,LingBot-Video 已开放应用于机器人动作预测、高保真仿真数据合成、条件化动作建模、世界模型构建等多个前沿方向。目前,该项目已在 GitHub 等平台全面开源。












