








fable 5 自面世以来,其发展轨迹便如其名般充满玄机与变数。
从被寄予厚望的「AI 封神时刻」,到突遭美国政府禁令强制下架,再到限制非美国用户访问——这场风波席卷全球,牵动无数开发者与研究者的心弦。
如今,喧嚣渐息,喧闹退潮。模型的价值终究要落回真实场景、回归生产一线。
为此,Claude Code 工程师 Thariq Shihipar 在社交平台上发布了一篇深度长文,系统梳理了驾驭 Fable 5 的核心方法论。
这篇文章回应了一个长期萦绕在用户心头的困惑:当下大模型能力已如此强大,为何我仍常感它“答非所问”、“做不对事”?
Thariq 的剖析令人顿悟:人与模型之间,本质存在一道“信息鸿沟”——即用户输入的提示词、技能设定、上下文信息,与任务真实执行所需的全部条件之间,并不完全对齐。
整篇博客,正是围绕如何识别、暴露并弥合这道鸿沟而展开。以下为原文全文,机器之心特此编译呈现,供读者参考。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
博客标题:A Field Guide to Fable: Finding Your Unknowns 博客链接:https://www.php.cn/link/37cf78297210d710dfc4e031ca107372
与 Claude Fable 5 协同工作,一次次让我重拾一个古老却常被忽略的真理:地图不等于疆域。
所谓「地图」,是你对目标工作的抽象表达——即你写下的提示词、调用的 Skill、提供的上下文,是你交付给 Claude 的全部输入;而「疆域」,则是任务真正发生之地:代码仓库、物理世界,以及其中不可回避的真实约束与边界。
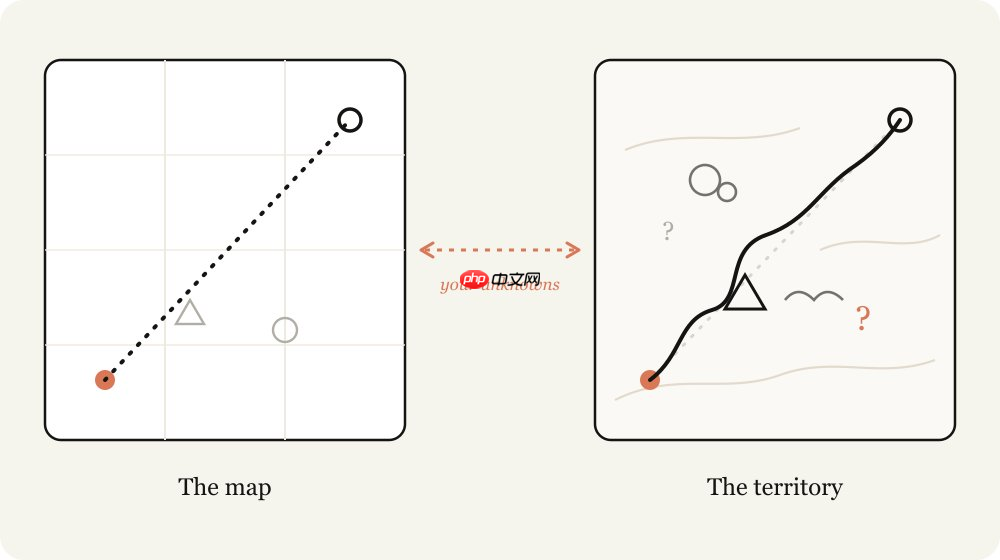
我把地图与疆域之间的偏差,统称为「未知项」(Unknowns)。每当 Claude 遇到一个未知项,它就必须基于对你意图的最优推测来决策。任务越复杂,未知项就越多,不确定性就越强。
Fable 是首个让我深切体会到:最终产出质量的天花板,并不取决于模型本身,而取决于我能否精准识别并澄清这些未知项。
尤为关键的是,仅靠前期规划往往并不足够。你可能在编码中途才撞见未知项;也可能发现某个未知项其实暗示着:你本该换一条路径来解题。
与 Fable 合作的过程,本质上是一场贯穿“实现前—实现中—实现后”的持续探知循环:不断发现未知、验证假设、调整策略。
作者同步附上了多个典型场景的实操示例,便于读者对照理解。
示例链接:https://www.php.cn/link/e95c450cfea74f2de27472231cf9373e
认识你的未知项
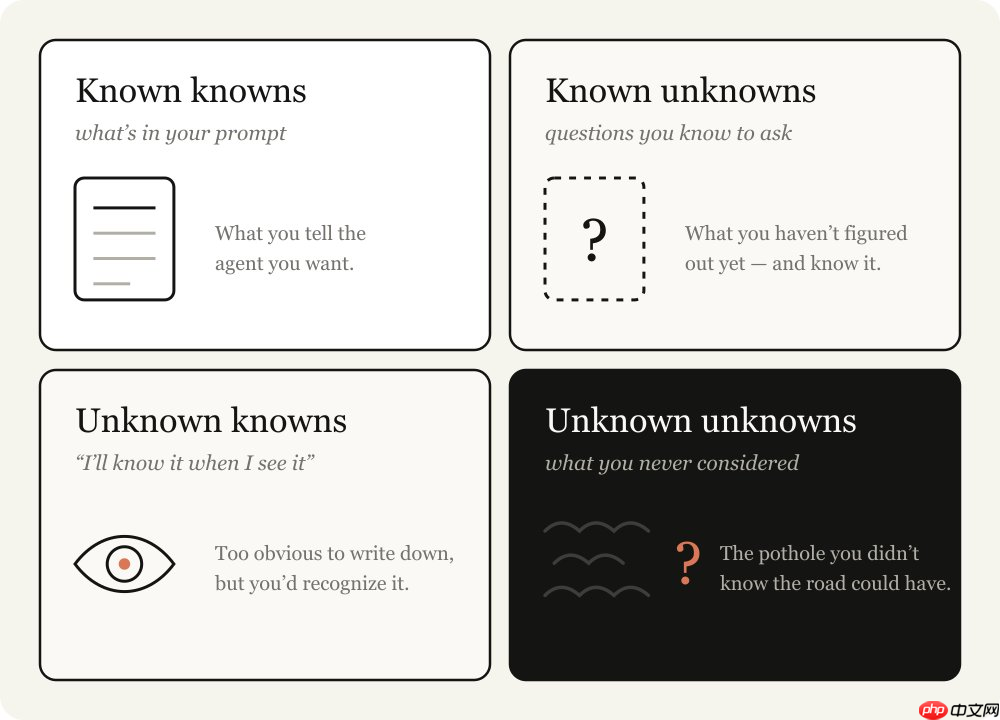
什么是未知项?当我带着一个问题向 Claude 提问时,我习惯从四个维度进行拆解:
已知的已知:即明确写进提示词里的内容。我告诉智能体,我想要什么?目标是否清晰?边界是否划定?
已知的未知:那些我清楚自己尚未掌握、但已意识到需要补足的信息。例如:“我不确定这个 API 是否支持批量操作”,这类问题我虽不知答案,但知道它存在。
未知的已知:那些对我而言习以为常、根本不会特意说明,但一旦呈现就能立刻识别的知识。比如你熟悉某框架的默认行为,却从未在提示中提及——Claude 并不知道。
未知的未知:最隐蔽也最危险的一类——我甚至没意识到它的存在。我不知道有哪些关键变量未被考虑;不清楚某类问题已有成熟解法;更不了解这件事理论上能做到何种程度。
顶尖的智能体协作型程序员,往往拥有更少的未知项。他们对目标有高度共识,细节定义充分;同时与代码库逻辑、模型行为保持实时同步。
但他们从不假设“一切尽在掌握”。恰恰相反,他们主动预设未知项的存在。某种意义上说,识别未知、压缩未知、前置管理未知,正是智能体编程最核心的能力。值得庆幸的是,这项能力可通过与 Claude 的反复协作持续精进。
借力 Claude,反哺自身
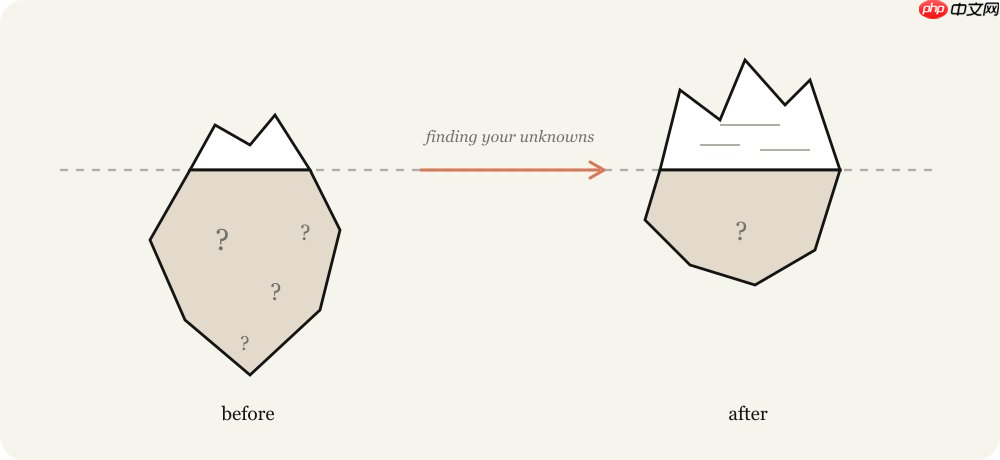
向 Claude 下达指令,是一门微妙的艺术。若指令过于严苛,哪怕切换方案更优,它也会机械执行;若指令过于宽泛,它则倾向于套用通用最佳实践——而这未必契合你的具体语境。
当你的未知项尚未被充分审视时,两种极端都会导致失败。你既不知前方何时会出现断崖,也不知哪段路其实畅通无阻,却仍期待 Claude 能在关键时刻自主转向。
Claude 其实可以成为你发现未知项的加速器。它能毫秒级检索你的代码库与全网知识,在多数领域掌握的常识远超个体;它也能在失败后迅速迭代、试错成本极低。
这一过程中最关键的动作,是为 Claude 提供扎实的起点上下文:说明你当前思考进展、坦诚你对代码库或领域的熟悉程度、邀请它以“思维伙伴”而非“执行工具”的角色参与进来。
我此前曾撰文介绍如何用 Claude 构建 HTML 页面。在绝大多数场景中,HTML 都是最高效、最直观的思维外化载体。
本文将系统介绍我在实践中总结出的若干识别未知项的方法论。我并非每次全盘套用,但将其作为一套可按需调用的“工具箱”,极大提升了协作效率与产出稳定性。
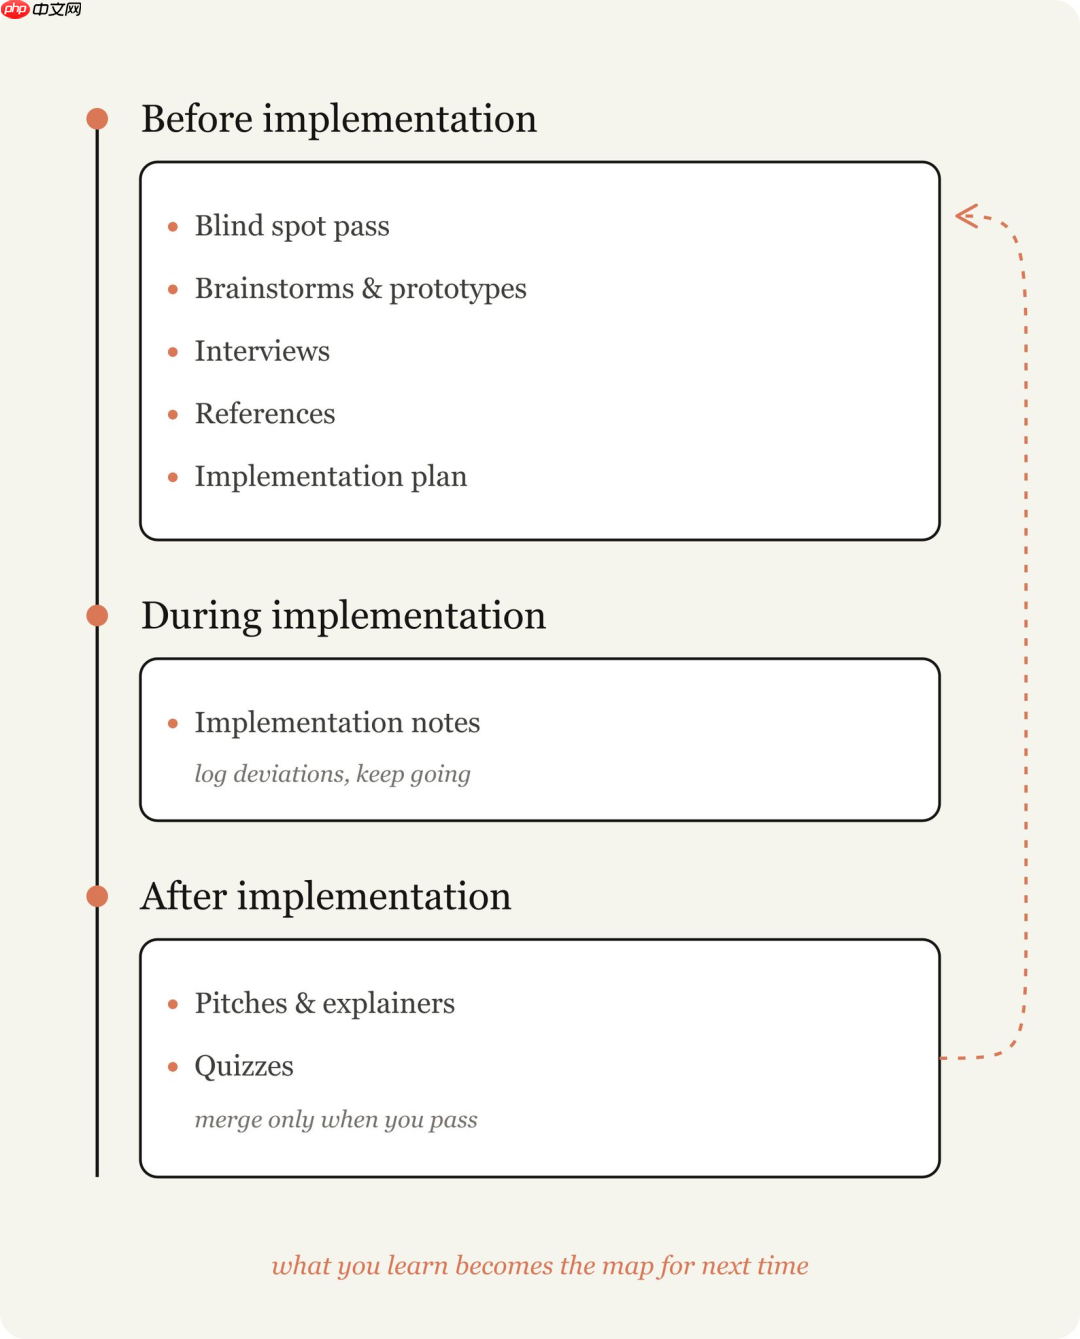
实现前
盲点扫描(Blindspot Scan)
启动一项新任务时,最有效的第一步,往往是厘清自己的认知盲区。例如:你在陌生模块中新增功能;或请 Claude 协助完成你不熟悉的任务(如 UI 设计评审、视频调色),此时极易存在大量「未知的未知」。
你可能不清楚该问什么问题、无法判断何为“好结果”、不了解历史实现逻辑、更难预见潜在陷阱。
这时,可主动请 Claude 帮你定位这些隐藏盲区,并解释其影响。我习惯直接使用 “blindspot pass” 或 “unknown unknowns” 等关键词触发分析。同时,务必说明你的身份背景与现有认知水平。
示例提示词:
「我正为系统接入新的身份认证提供方,但对当前认证模块完全陌生。请做一次 blindspot pass,帮我识别关键 unknown unknowns,并指导我如何写出更有效的后续提示。」
「我对影视调色毫无经验,但需为这段视频完成基础调色。请帮我梳理调色领域的 unknown unknowns,让我能写出更具指向性的提示词。」
头脑风暴与原型构建(Brainstorming & Prototyping)
当你身处「未知的已知」密集区——即那些只有亲眼看到才能定义标准的领域(如视觉设计、交互流程)——我会邀请 Claude 共同开展头脑风暴与快速原型。
尽早暴露并具象化这些隐性认知,价值巨大。若留到实现阶段才浮现,不仅重构代价高昂,还可能导致架构级返工,且智能体难以回溯修正。

举例来说:你只想测试某个框架中按钮的视觉效果,无意立即对接后端路由,也不愿在前端维护额外状态。
视觉设计恰是典型难言之域——我常需见到样稿才能确认偏好。此时,我会要求 Claude 输出多种风格迥异的设计方向,供我筛选反馈。
我几乎每次编码会话都以探索性头脑风暴开场,借此锚定项目边界与核心意图。Claude 常能指出我忽略的高价值路径,但也可能陷入细节而失焦。头脑风暴,正是防止初始范围过窄或过宽的第一道防线。
示例提示词:
「我想为这批数据构建仪表盘,但缺乏设计直觉,也不清楚技术上限。请生成一个 HTML 页面,提供 4 种视觉语言截然不同的设计方案,方便我基于实际效果反馈。」
「在正式接入真实系统前,请先用模拟数据生成独立 HTML 文件,复现新编辑器工具栏。我需先对布局结构反馈,你再修改主应用。」
「粗略问题如下:用户完成 onboarding 后流失率高。请扫描代码库,头脑风暴 10 个干预点,按实施成本由低到高排序,涵盖最小改动到颠覆性方案。我会标注哪些方向更契合业务目标。」
反向提问(Reverse Q&A)
完成初步头脑风暴后,未知项通常仍未清零。
此时,我会让 Claude 围绕所有模糊、歧义或存疑之处,对我发起针对性提问。为提升问题质量,请提前提供充足上下文——尤其是影响架构决策的关键变量。
示例提示词:
「请逐条向我提问,聚焦于任何存在歧义或决策依赖的环节。优先提出那些答案将直接影响整体架构设计的问题。」
参考素材驱动(Reference-Driven Prompting)
有时,你难以用语言精准描述需求。原因可能是缺乏专业术语,或是问题过于庞杂,完整描述耗时过长。
此时,最高效的解法是提供参考素材:图表、文档、截图,甚至——源代码本身。
若某开源库已用特定方式实现了你所需的功能,或某网站组件恰好符合你的审美与交互预期,请直接将 Fable 指向对应路径,并明确指示关注重点。即使参考代码使用不同语言,也完全可行。
这正是 Claude Design 的底层逻辑:你无需上传文件,只需提供 URL,它即可解析网页底层 DOM 结构、组件组织方式与实现逻辑,远超截图所能传递的信息密度。
示例提示词:
「vendor/rate-limiter 目录下的 Rust crate 实现了我所需的回退重试机制。请研读其实现逻辑,并在我们的 TypeScript API 客户端中复现同等语义。」
实现计划预演(Implementation Plan Review)
当我认为准备就绪,即将进入编码阶段时,我会先让 Claude 输出一份结构化实现计划供我审阅。重点聚焦于易变性最高的部分:数据模型、类型接口、UX 流程等。此举可提前暴露潜在风险点,避免后期返工。
示例提示词:
「请用 HTML 格式输出实现计划。开头优先罗列我最可能调整的决策点:数据模型变更、新增类型定义、面向用户的关键文案。机械性重构步骤置于末尾——这部分我信任你能自主完成。」
实现中
实现笔记(Implementation Notes)
确认计划后,我会开启新会话,传入规格文档、原型页面等关键工件,正式启动开发。
但现实是:无论前期多么周密,总会有未知项蛰伏于代码深处。Claude 在执行中可能因边界情况被迫转向新思路。
因此,我要求 Claude Code 持续维护一份 implementation-notes.md 或 .html 文件,实时记录关键决策与偏离原因,确保每次尝试都能沉淀经验。
示例提示词:
「请维护 implementation-notes.md。若因边界情况需偏离原计划,请选择保守方案,并在 ‘Deviations’ 区域详述原因,随后继续推进。」
实现后
推介与解释文档(Pitch & Explanation Artifacts)
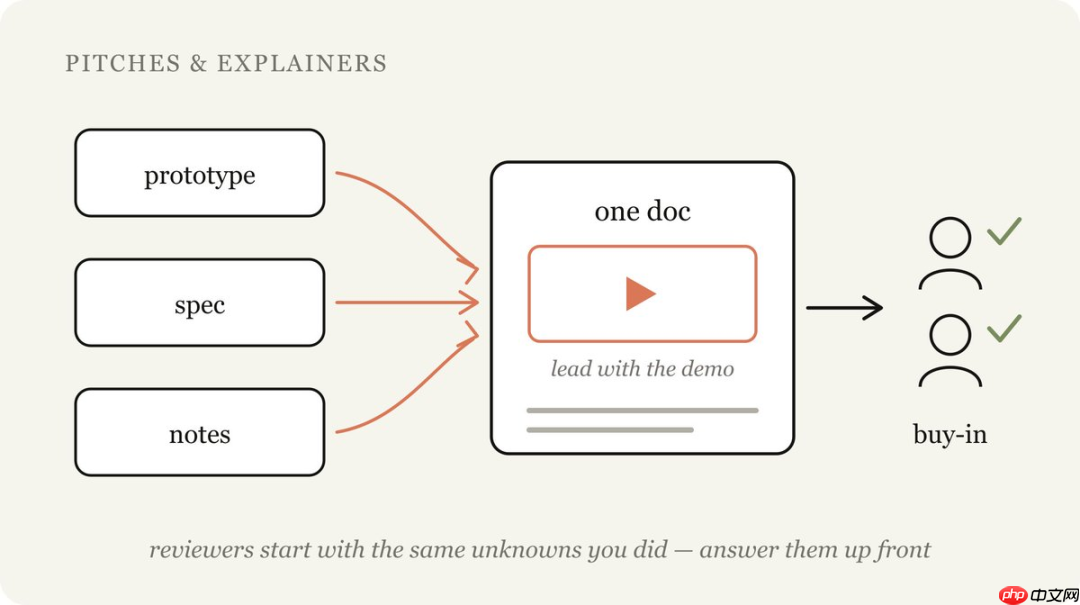
任何成果的落地,离不开他人理解、支持与批准。在最终交付物中嵌入推介性与解释性文档,能显著提升协同效率:
- 当评审者与你共享相同未知项时,加速其理解进程;
- 当领域专家需确认你是否覆盖了关键风险点与常见陷阱时,加速审批流程。
示例提示词:
「请整合原型、规格说明与实现笔记,生成一份独立 HTML 文档,含演示 GIF,我可直接转发至 Slack 争取跨团队支持。」
知识测验(Knowledge Quiz)
经历一次长周期协作后,Claude 往往已完成远超你感知范围的工作。仅看代码 diff,常只能获得表层认知——许多行为依赖既有代码路径与隐式逻辑。
此时,请 Claude 在提供完整上下文后,围绕本次变更为你定制一份测验。唯有通过全部题目,我才视为真正理解,方可合并代码。
示例提示词:
「为确保我彻底掌握本次变更的全部影响,请生成一份 HTML 报告,包含:上下文摘要、行为直觉解读、具体修改点说明,并在文末附上我必须通过的测验题。」
方法串联实战:以 Fable 发布视频为例
Fable 的官方发布视频,全程由 Claude Code 完成剪辑。这对身为非专业视频工程师的我而言,是全新挑战。
我从已知出发:确认 Claude 可调用代码完成视频剪辑与语音转录,但不确定 Whisper 转录精度是否满足需求。于是请它详解转录原理,并验证能否用 ffmpeg 精准剔除“嗯”“啊”等语气词及长停顿。
我希望实现语音文本与画面时间轴同步的 UI,但不确定可行性。于是请 Claude 基于 Remotion 与转录文本快速构建视频原型,验证技术路径。
最终成片色调偏灰。我意识到这是调色问题,却缺乏相关知识。首次尝试是让 Claude 输出多个版本供我挑选,但很快发现:面对调色,我根本无法判断何为“优质”。于是果断暂停生成,转而请 Claude 教我调色基础——主动暴露并填补我的未知项。
让地图贴近疆域
模型越强大,正确的方法论就越关键。当一个长周期任务产出错误结果时,往往不是模型能力不足,而是你需要投入更多精力去界定未知项,或制定更具弹性的实现计划,使 Claude 能在不确定性中稳健前行。
每一份解释文档、每一次头脑风暴、每一场反向访谈、每一个原型、每一处参考代码,都是低成本的风险探测器——它们帮你提前发现那些原本看不见的问题,远在修复成本飙升之前。
所以,在开启下一个项目前,请先让 Claude 帮你找到自己的未知项。
本文来自微信公众号“机器之心”,编辑:机器之心编辑部,36氪经授权发布。




















