


这是正在发生的现实。根据最新统计,anthropic 公司自身在算力上的投入,已攀升至其员工薪资总额的 2.3 倍。以一名资深工程师 22.4 万美元的全成本为基准,anthropic 每位工程师背后所对应的年度算力开销高达约 51.5 万美元。换言之:人,尚未比模型更值钱。
面对如此惊人的账单,连 Claude 自身也不得不开始精打细算,主动压缩 token 使用。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
Claude Code:用 token 堆砌“高效能”的幻觉
近期,业内悄然兴起一个新热词:Token Apocalypse(Token 末日)。
从“token maxing”(极致刷 token)到“token apocalypse”,这一转变折射出 AI 领域正经历一场深刻范式迁移。今年三四月间,圈内还流行晒 token 消耗量,甚至将其视作能力排行榜。但很快人们意识到:调用 AI 并不天然等于降本增效——于是焦点迅速转向“单 token 成本”。
更值得警惕的是,大模型正不断将原本无需 AI 的任务也卷入其中。PDF 不愿自己读,长文懒得亲自看,所有内容都交由 AI 概括;再一键转成 PPT,发给同事,对方又用 AI 解读……AI 正在为本就空泛的工作流程强行叠加一层“智能外衣”,同时悄然推高整条链路的成本账单。
如今,成本失控已成普遍现象。亚马逊、Adobe、Atlassian、花旗集团等头部企业纷纷祭出 AI 使用管控措施:
- 模型等级限制:部分公司禁止员工使用 Claude Opus 等高性能模型,强制切换至性价比更高的轻量版本;
- 个人用量封顶:Uber 为每位工程师设定了每月 1500 美元的 token 消耗上限;
- 权限全面冻结:花旗银行等机构已暂停高级 AI 工具的企业级访问权限;未达成使用规范者,甚至被直接注销账户。此前 Uber CTO 曾坦言,公司数月内便耗尽全年 AI 预算;沃尔玛亦近期叫停了部分 AI 工具的部署。
大厂要么四处寻觅降本路径,要么果断踩下 token 浪费的急刹车。员工因此陷入双重信息夹击:一边是“AI 能让你效率飙升百倍,必须上手”,另一边却是“再这么烧下去,公司真要被你用垮了”。
这恰是 AI 工具首轮规模化落地中最典型的结构性缺陷:产品上线时,缺乏有效护栏来遏制企业在大语言模型上的百万级支出,也缺少实时预警机制提示团队 token 正在飞速蒸发。无论是对话助手还是编程插件,多数产品优先追求“快速可用”,而将成本治理、用量配额、模型分级与上下文调控等关键能力延后交付。
但 Claude Code 的本质,并非效率引擎,而是营销载体。
其设计逻辑极为清晰:让你沉浸于“高产”的自我感知。项目负责人 Boris 在构思该产品之初便坦言:“如果模型足够聪明,代码开发会变成什么模样?我希望如何与它协作?”——出发点并非“帮开发者省 token”,而是“如何最大化呈现模型的智能感”。
Anthropic 愿意为这种“感知价值”豪掷大量 token——无论这笔费用来自客户,还是自家账本。五分钟烧掉 200 美元,在 Claude Code 这里不是异常事故,而是既定设计。它的底层信条是:凡能靠多消耗 token 解决的问题,绝不采用更经济的方案。所有 sub-agent 架构、所有炫目的 UI 动画、所有冗长的 reasoning trace,均非服务于效率提升,而是为了让你凝视屏幕时,笃信“这模型真厉害,真靠谱”。
这背后是一套精密运转的营销闭环:你持续消耗 token,换取“高产”体验,进而强化对 Claude 的好感与依赖,从而继续高频使用。Anthropic 甚至甘愿自掏腰包承担巨额 token 成本,只为换取用户情绪层面的认可。这也解释了为何其桌面客户端长期存在明显功能短板——Claude Code 的终极使命,从来不是打造一款实用工具,而是成为 Anthropic 模型实力的“最佳展窗”。
恰恰是这种“以 token 换体验”的设计理念,使 Claude 在 token 效率维度被 OpenAI 显著拉开差距。
OpenAI 始终将 token 压缩置于核心战略。从 reasoning trace 的极致精简,到模型架构本身的能效优化,其哲学始终如一:用更少 token,完成同等任务。Codex 5.5 就是最有力的佐证。
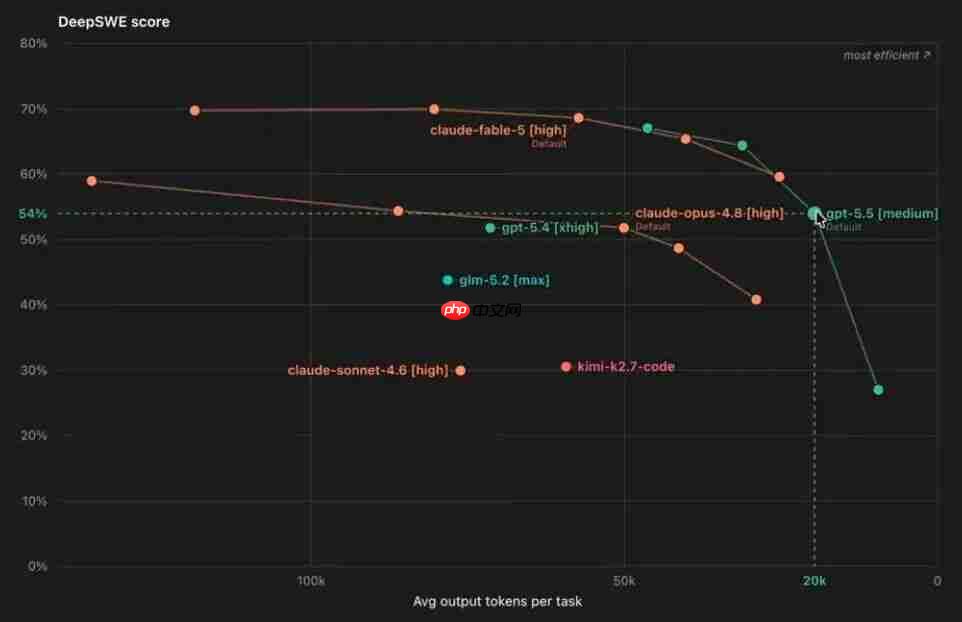
尽管 Fable 5 模型展现出强大推理能力,但在效率指标上并不突出。Deep SWE 发布的对比图表直观揭示了这一点。若将同批模型横向拉齐评估,则差异更为显著:GPT-5.5 medium 仅凭 2 万个 token 即斩获惊人分数;而 Opus 4.8 消耗 5 万个 token,得分却反而更低。
这正是两条技术路线最直白的映照:行业集体焦虑于成本失控,Claude 持续加码燃烧,OpenAI 则坚定执行节流。接下来的关键命题随之浮现——既然必须降本,首当其冲该砍掉什么?答案明确:那些层层堆叠、早已臃肿不堪的提示词。
Claude Code 的 Prompt 债:越堆越多,越欠越深
在最新技术分享中,Anthropic 宣布已移除 Claude Code 中 80% 的系统级提示词(system prompt)。
Anthropic 技术专家 Tariq Shihipar 指出,此举标志着 AI 模型引导范式的根本性转向——过去人们笃信“指令越详尽、示例越丰富,模型表现就越出色”;如今,这套逻辑已然失效。新一代模型 Fable 5 的想象力,甚至超越了人类提供的标准范例,过度示范反而成了束缚。
当然,这番表述不乏营销色彩,他顺势夸赞了 Fable 的自主性:“示例反而容易框住模型,因为它其实比我们预设的样本更具创造力。”但一个无法回避的事实是:Anthropic 自身已开始向 system prompt 动刀。
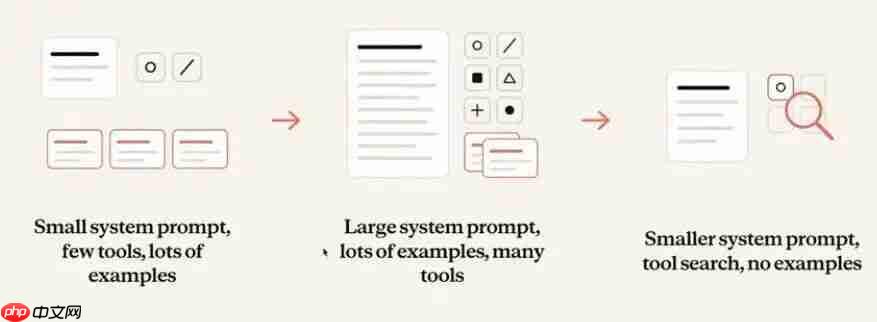
那么,为何过往需要如此庞杂的提示词?
过去一两年,AI 编程生态形成了一种惯性共识:上下文窗口越大越好,工具说明越全越好,system prompt 越完备越好。模型不懂项目结构?写份 Agents.md。模型不熟工具调用?补上 tool descriptions。模型响应不够主动?加入行为引导语句。模型输出不够稳定?再塞进几条约束规则。
不可否认,system prompt 曾是 AI 编程工具的核心壁垒。对 LLM 提示策略稍作微调,就可能带来可观性能跃升。同一模型在 Codex、Cursor、OpenCode 和 Copilot 中体验迥异,根源往往就在 prompting 的细微差别。
正因如此,Cursor 曾投入大量资源反复测试 system prompt,开展 A/B 实验,针对不同模型定制提示模板。相比在 Claude Code 中直接调用 Opus,Cursor 的 harness 可显著提升模型表现,部分 benchmark 测试显示提升幅度达 10% 至 30%,关键变量往往就是那几段精心打磨的提示文本。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
但问题在于:只要提示词有效,团队就会持续叠加新内容。某模型滥用工具?加一条禁令;某模型响应迟钝?添一段激励;某模型过度搜索?补一道限制;某模型理解不了工程上下文?再附一份 Markdown 文档。每次扩充都有充分理由,可日积月累之下,system prompt 渐渐演变为沉重的常驻上下文负担。
须知:system prompt 并非零成本。每一次请求,它都会被完整载入、计入账单、占用上下文空间。
Claude Code 将全部工具与功能深度集成后,其 system prompt 曾一度膨胀至 65,000 token;即便关闭大部分模块,仍保有 12,000 token。这意味着——模型尚未写出第一行代码,已先背负起一本厚达数百页的操作手册。相较之下,Pi 启动时的上下文不足千 token。
更棘手的是,prompt 债远比代码债更难察觉。
老旧代码通常会在功能迭代、测试运行或缺陷修复过程中暴露问题。而陈旧的 prompt 却可能只是让模型悄然退化:用户只会感知“Claude Code 最近好像没以前灵了”,或“新模型不如宣传中惊艳”,却难以归因于 system prompt 已与新模型脱节。
当提示词从竞争优势蜕变为效率枷锁,Anthropic 选择剔除 80%,也成为提升 token 效率的必然之举。
Claude 的“冗余税”:多说一个字,多付一份钱
Claude Code 的语言冗余程度,令人咋舌。
今年一款名为 Caveman 的插件迅速走红,专治此症。其名直译为“穴居人”,寓意回归原始表达——摒弃客套话、删减语法赘余、剔除填充词,只保留核心语义。
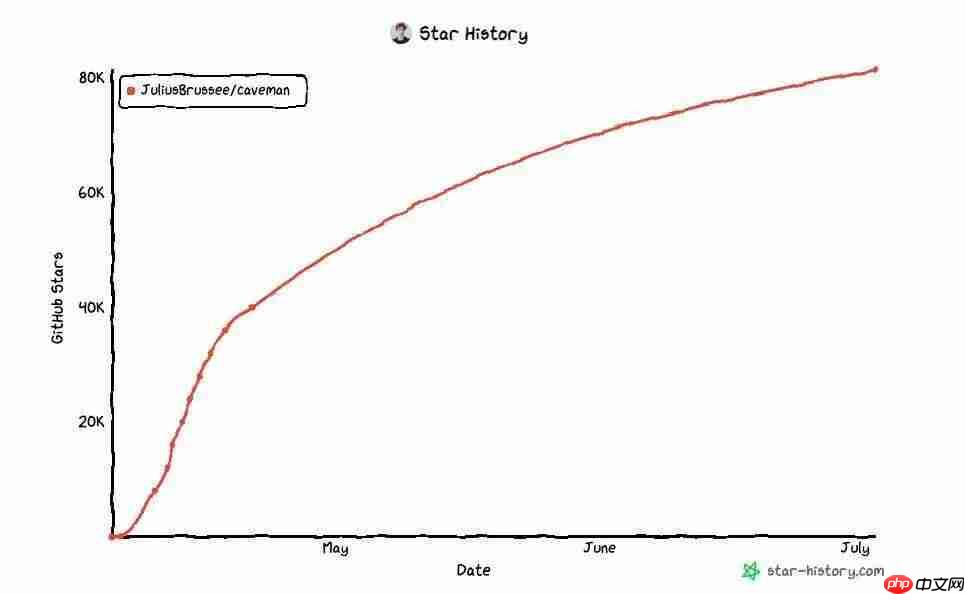
“Caveman save you token, save you money. Star cost zero.”
初看像是个玩笑,细究却发现它直击 LLM 应用中的真实痛点:废话泛滥、token 浪费、成本无谓攀升。
而它的诞生,正是源于对 Claude Code 的深度观察。
“我是在 4 月初开发出 Caveman 的,当时正高频使用 Claude Code,明显察觉大量 token 被浪费在无关紧要的文字上:寒暄问候、模糊措辞、过渡短语,以及 agent loop 中那些纯属‘表演性质’的闲聊式表达。”Caveman 创作者 Julius Brussee 表示。
Brussee 的实测数据显示,启用 Caveman 后,输出 token 可减少 65%–75%,效果远超简单指令“请简洁”。它主要压缩外围描述性语言,对代码、命令、路径、URL、函数名等需精确传达的内容则保持原样。
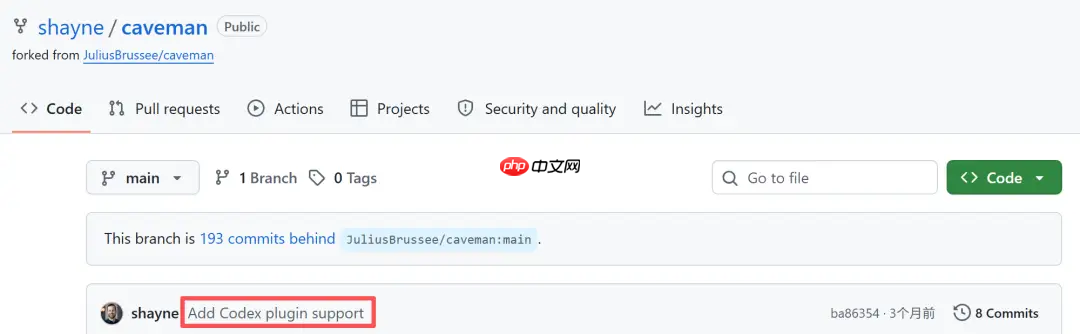
据悉,OpenAI 工程总监 Shayne Sweeney 亦为该项目贡献了代码,以适配 Codex。
更有意思的是,OpenAI 早已将此类极简语言模式嵌入模型内部推理环节。
部分泄露的 reasoning trace(非对外展示的 summary 版本)揭示了这一策略:内容不似自然英语,更接近压缩版工程速记:
"Use core new nodes. Need infer. Need add VAE encode for images. Try. Try period."
这些句子看似滑稽甚至混乱,但其目标并非可读性,而是极致 token 效率。模型在内部推理时,无需像面向用户那样维持礼貌、完整与流畅。它只需保留动作、对象、判断与下一步指令。换言之,只要最终输出正常,推理过程完全可以采用更短、更粗粝、更省 token 的语言形态,以疯狂压榨效率。
这甚至比优化 prompt 环节更具收益。压缩 reasoning token 的价值更大,因为 agent 是多步执行的,前一步推理结果会直接作为后一步输入。模型每少“想”一段,节省的不仅是当前 token,更是后续整条执行链的重复开销。
这正是 OpenAI 与 Claude 路线分歧的鲜明注脚。
Claude 始终以“好聊”见长,更像一位用完整语言思考与表达的智能助手。仅看其 reasoning trace 明显更长,即可推测其内部推理很可能基于标准英语。输出与推理过程普遍冗长,因此极度依赖超大上下文窗口承载内容。
这也是为何 Claude 默认配置 100 万 token 上下文窗口。许多人误以为这是为容纳巨型代码库,实则原因更朴素:Claude 生成的内容太长,若无如此宽裕的空间,根本无法装下。它在上下文压缩(compaction)方面亦表现平平——当你恢复历史对话时,Claude 甚至会建议放弃完整上下文,转而尝试 compact,因其无法保留 reasoning trace;事实上,它们会在 10–20 分钟后自动清除这些内容,因为 reasoning token 效率过低,长期留存将导致成本荒谬到不可承受。
而 OpenAI 模型的上下文窗口通常设定在 20 万 token 或更低,但凭借从推理阶段即启动的极简语言策略,实现了高效压缩。
一个耐人寻味的细节:倘若 Anthropic 真正根治“冗余过多”这一顽疾,其营收或将显著下滑。若开发者能以更少 token 完成同等任务,就意味着 Anthropic 少了一笔本可赚取的收入。
本文源自微信公众号 “InfoQ”(ID:infoqchina),作者:Tina,经 36 氪授权发布。














