


Nginx Master进程无内置配置错误热备能力,需依赖外部机制实现:强制nginx -t校验、双槽位软链切换、集群配置一致性保障及外部健康检查触发自动回滚。
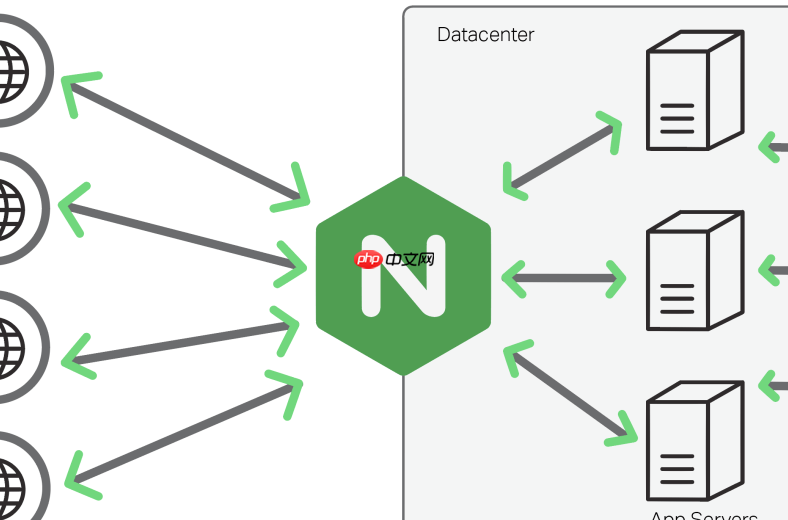
Nginx 的 Master Process 本身不支持配置错误时自动回退或热备切换。它不会在 nginx -s reload 失败时保留旧配置继续运行,也不会主动启动备用配置槽——这是常见误解的根源。真正的“配置错误热备”,靠的是外部机制协同实现,而非 Master 进程内置能力。
配置校验必须前置,不能依赖 reload 后补救
Master 进程收到 nginx -s reload 信号后,会尝试加载新配置并 fork 新 worker,但前提是 nginx -t 已通过。如果配置语法错误或引用路径失效,nginx -t 会直接失败,此时 reload 根本不会触发。所以关键动作不是让 Master “容错”,而是确保 nginx -t 成为不可绕过的强制关卡:
- 所有配置变更必须先执行
nginx -t,失败则中止发布流程 - CI/CD 流水线中嵌入校验步骤,测试环境先行验证
- 生产部署脚本里把
nginx -t || exit 1作为 reload 前的硬性前置
双槽位 + 软链切换,让 Master 加载始终指向已验证配置
每台机器维护两个独立配置目录(如 /etc/nginx/slots/a 和 /etc/nginx/slots/b),当前生效的通过软链 /etc/nginx/conf.d/live → /etc/nginx/slots/a 指向。更新时:
- 只写入非活跃槽(比如当前用 a,则写 b)
- 在 b 中完成全部文件写入后,执行
nginx -t - 校验通过,再执行
ln -sf /etc/nginx/slots/b /etc/nginx/conf.d/live && nginx -s reload - 若 reload 后异常(如 worker 异常退出、5xx 突增),立即切回原软链并 reload
这样 Master 进程每次 reload 加载的,永远是经过完整校验且历史验证过的配置集,不存在“边加载边纠错”的可能。

集群一致性保障,避免单点正确但全局失衡
即使单机配置无误,若多台 Nginx 节点间配置哈希不一致(比如 upstream 地址漏同步),仍会导致流量分发紊乱。需配合:
- 使用 Ansible 或 etcd 统一分发配置,所有节点执行相同部署动作
- 部署后统一校验:
ssh nodeX 'nginx -T | md5sum'对比各节点输出 - 动态 upstream 列表可交由 lua-resty-etcd 或 nginx-upsync-module 管理,主配置仍走版本化发布
自动回滚依赖外部健康反馈,不是 Master 主动判断
Master 进程不感知业务状态。回滚需靠外部脚本监听:
- reload 后 10 秒内轮询
curl -sf http://127.0.0.1/health或检查systemctl is-failed nginx - 发现异常即执行预设回滚命令(切软链 + reload)
- 脚本需幂等设计,多次触发不影响状态
不复杂但容易忽略









