


Nginx吞吐优化关键在于事件循环与系统资源的协同效率,而非修改循环逻辑;重点是缩短事件驱动路径、减少拷贝与阻塞,涵盖网络层(sendfile、tcp_nopush等)、连接生命周期(reuseport、backlog等)、磁盘I/O(AIO、open_file_cache)及系统级调优(CPU绑定、文件描述符等)。
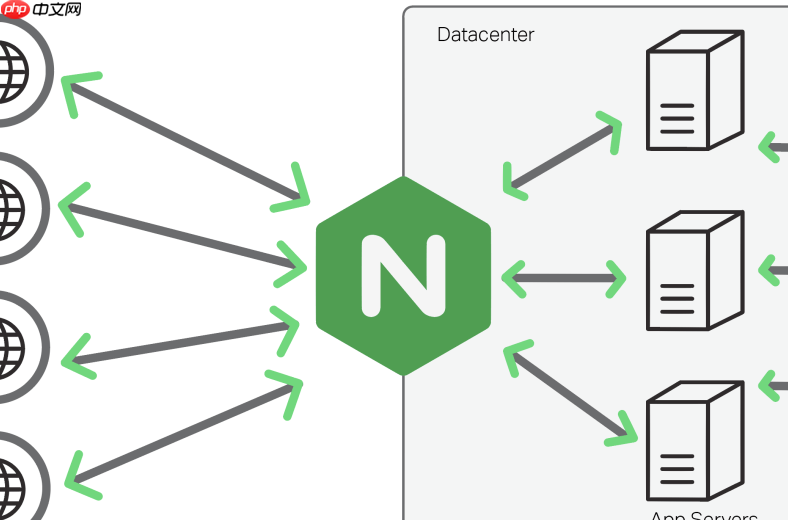
nginx 的事件循环本身不直接控制数据吞吐量,但它决定了数据如何被调度、何时被读取和发送。真正影响吞吐的,是事件循环与网络栈、磁盘 I/O、系统资源之间的协同效率。优化重点不在“改循环逻辑”,而在配置与拓扑层面让事件驱动路径尽可能短、无阻塞、少拷贝。
网络层吞吐:减少协议开销与内核拷贝
高吞吐场景下,每个字节的额外拷贝或延迟都会被放大:
-
启用 sendfile:静态文件服务必须配
sendfile on;,绕过用户态缓冲,由内核直接 DMA 从磁盘到 socket 发送队列,降低 CPU 和内存带宽压力 -
配合 tcp_nopush:与
sendfile联用,让内核把多个小响应包攒成一个 MTU 大小再发,减少 TCP 报文数量和 ACK 次数 -
关闭 Nagle 算法(按需):若业务对首字节延迟敏感(如 API 接口),设
tcp_nodelay on;;但注意它会增加小包数量,需权衡带宽与延迟 -
调大 TCP 缓冲区:在
/etc/sysctl.conf中设置net.ipv4.tcp_rmem和net.ipv4.tcp_wmem的第三项(最大值),例如1048576,避免突发流量因缓冲不足而丢包或重传
连接生命周期吞吐:加快 accept 与复用效率
连接建立和复用速度直接影响每秒新建连接数(CPS)和长连接利用率:

-
启用 reuseport:
listen 80 reuseport;让内核将新连接哈希分发到各 worker 监听 socket,消除单队列瓶颈,特别适合多核机器 -
增大全连接队列:Nginx 配置中显式设
listen 80 backlog=4096;,并同步调高内核参数net.core.somaxconn = 65535 -
合理设置 keepalive:反向代理中开启
keepalive 32;并配keepalive_requests 1000;,减少重复建连开销;同时设keepalive_timeout 60s;避免连接长期空闲占用资源 -
关闭 accept_mutex(高并发时):当 worker 数较多且流量均匀时,设
accept_mutex off;可减少锁争抢,提升 accept 频率(需确保使用 epoll)
磁盘 I/O 吞吐:避免阻塞事件循环
静态文件读取若走普通 read(),会短暂阻塞 worker;必须通过异步机制解耦:
- 小文件走 sendfile:默认策略,零拷贝、高效,适用于大多数 CSS/JS/图片
-
大文件启用 AIO + directio:在 location 块中配
aio threads;和directio 4m;,让内核线程异步读取,worker 不等待 -
配置线程池:在 http 块中定义
thread_pool default threads=32 max_queue=65536;,确保 AIO 请求有足够线程处理 - 开启 open_file_cache:缓存文件句柄、元信息和格式校验结果,减少 stat() 和 open() 系统调用,尤其利于大量小文件场景
系统级协同吞吐:释放事件循环执行潜力
即使 Nginx 配置完美,若系统资源调度失衡,事件循环也跑不满:
-
CPU 绑定要精准:设
worker_processes auto;和worker_cpu_affinity auto;,确保每个 worker 固定运行在独立物理核心上,避免缓存失效 -
文件描述符别卡住:检查
ulimit -n是否 ≥worker_connections × worker_processes,并同步调高fs.file-max -
监控 recv-q 积压:用
ss -lnt查看监听端口的 Recv-Q 值,持续 > 0 表示 accept 速度跟不上建连速度,需回查 backlog、somaxconn 或 worker 负载 -
避免 DNS 同步解析:反向代理中用
resolver 127.0.0.53 valid=30s;,禁用阻塞式解析,防止 upstream 域名查询拖慢整个循环











