


Nginx worker process 是压测链路中的“交通调度员”,负责流量调度、连接管理与日志追踪,其配置直接决定压测真实性与有效性。
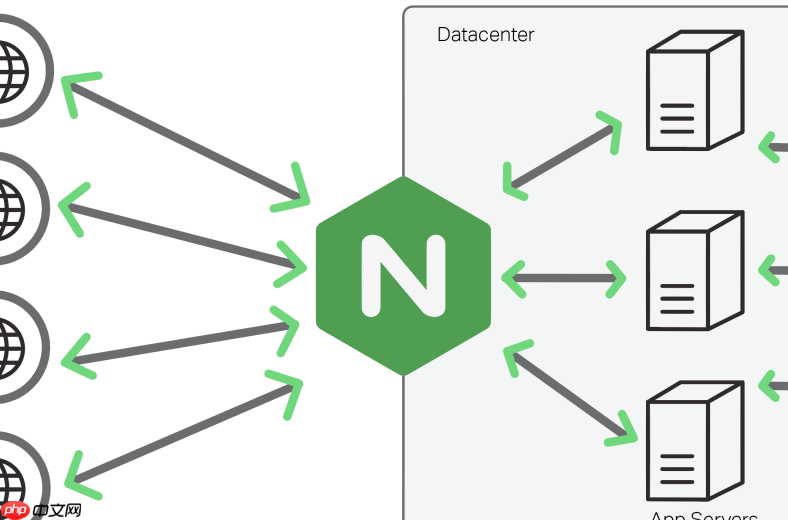
Nginx 的 worker process 本身不直接“实现”压力测试,而是作为高性能反向代理和负载分发枢纽,在压测中承担流量调度、连接管理与日志追踪的关键角色。真正发起压力的是外部工具(如 wrk、ab),而 worker process 的配置与行为,决定了压测能否真实、稳定、可度量地打到后端集群。
合理配置 worker process 是压测有效的前提
worker_processes 和 worker_connections 共同决定了 Nginx 能承载的并发连接上限。压测时若该上限过低,Nginx 自身就会成为瓶颈,导致后端未被打满、数据失真。
-
worker_processes auto;—— 自动匹配 CPU 物理核心数,避免多核闲置或单核争抢 -
worker_connections 65535;—— 单个 worker 最大连接数,需配合系统级限制 -
worker_rlimit_nofile 100000;—— 确保 worker 进程能打开足够文件描述符(每个连接占用一个 fd) -
use epoll;和multi_accept on;—— 提升高并发下事件处理效率,减少连接排队延迟
这些设置不是调得越高越好,而要与压测目标匹配:比如计划 5000 并发,理论连接数 ≈ 5000 × 1.2(含 keepalive 复用),那么至少需 worker_processes × worker_connections ≥ 6000。

worker process 在压测中实际承担三项关键任务
连接复用与分发控制
启用proxy_set_header Connection '';和 upstream 中配置keepalive 32;,让 worker 复用到后端的长连接,降低 TCP 开销,使压测更贴近真实业务流量模式。请求路由与节点追踪
每个 worker 在处理请求时,依据 upstream 策略(如least_conn或轮询)选择后端节点,并通过$upstream_addr变量记录实际转发地址。配合自定义log_format,可在 access log 中精准看到每个请求由哪个 worker 分发到了哪台后端。超时与错误兜底管理
压测中后端响应变慢或超时频发,worker 会依据proxy_connect_timeout、proxy_read_timeout等参数决定重试或返回错误。若 timeout 设置过短,大量请求被 Nginx 主动中断,就无法反映后端真实承压能力;过长则导致连接堆积、资源耗尽。
避免常见 worker 层压测陷阱
- 不检查
ulimit -n和/proc/sys/fs/file-max,导致大量 “too many open files” 错误,压测未达预期就失败 -
worker_processes设为 1 但压测并发远超worker_connections,所有连接挤在单个 worker,CPU 成瓶颈 - 忽略
accept_mutex off;(尤其在高并发+多 worker 场景),造成新连接竞争不均,部分 worker 空转、部分过载 - 未启用
worker_cpu_affinity,多个 worker 在同一 CPU 核上频繁切换,上下文开销抵消并发收益
本质上,worker process 是压测链路中的“交通调度员”:它不制造车流(请求),但决定车怎么走、走多快、走错时如何处置。调得好,后端压力真实可见;调不好,数据全是假象。











