


Nginx采用事件驱动异步模型,单worker进程通过epoll管理数万连接,内存与CPU消耗平缓;Apache基于同步阻塞模型,每请求独占线程/进程,高并发时资源指数级增长,导致性能断层。
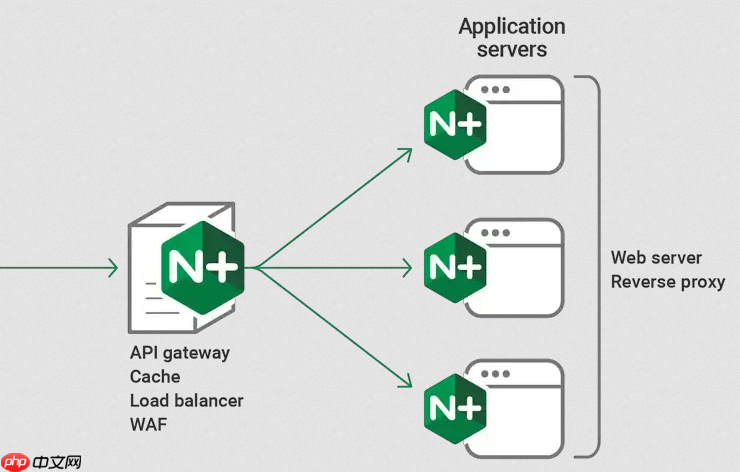
理解这个“物理性能断层”,关键不是比谁写得更炫,而是看服务器在真实硬件上怎么用 CPU 和内存——尤其是当并发连接从几千涨到几万、几十万时,两种模型的资源消耗曲线会彻底分叉。
单线程多路复用:一个 Worker 吃满 CPU,不抢内存
Nginx 的每个 Worker 进程(通常数量 = CPU 核心数)用一个线程跑事件循环,靠 epoll(Linux)这类系统调用监听成千上万个 socket 描述符。它不为每个连接分配栈空间、不创建新线程,只在有数据可读/可写时才触发回调。
- 一个 Worker 处理 10 万个空闲 Keep-Alive 连接,内存占用可能仅 20–30 MB
- CPU 主要花在事件分发和少量业务逻辑上,上下文切换几乎为零
- 瓶颈通常是网络带宽或磁盘 I/O,而非调度开销
多线程模型:连接数一涨,进程/线程就指数级膨胀
Apache 默认 prefork 模式下,每个连接独占一个进程;worker 或 event 模式虽优化了线程复用,但仍需为每个活跃请求维持独立执行上下文(栈、TLS 存储、信号处理等)。

- 1 万个并发连接 ≈ 1 万个线程 → 即便每个线程栈仅 1 MB,也要吃掉 10 GB 内存
- 线程调度由内核完成,连接数超 5000 后,CPU 大量时间花在上下文切换上,有效计算占比骤降
- 即使启用 event MPM,对长连接的管理仍依赖专用线程池,无法消除资源绑定关系
断层出现在哪里?不是理论值,是实测拐点
这个断层不是抽象概念,而是在真实压测中清晰可见的性能塌陷点:
- 在 4 核 8 GB 的云服务器上,Nginx 轻松支撑 5 万并发连接,CPU 利用率约 65%,内存稳定在 120 MB 左右
- 同样配置下,Apache(prefork)在 8000 并发时就开始频繁 fork 失败,内存飙升至 6 GB+,RPS 不增反降
- 延迟抖动也明显不同:Nginx 的 P99 延迟随并发线性缓升;Apache 在 6000 连接后出现大量 >1s 的毛刺,源于调度饥饿
这不是“单线程 vs 多线程”的优劣,而是资源映射方式的根本差异
Apache 把“连接”映射为“OS 线程”,让操作系统替它管调度;Nginx 把“连接”映射为“内存中的结构体 + 事件状态”,自己用非阻塞 I/O 驱动整个生命周期。前者依赖内核调度器的公平性,后者把控制权收回到用户态——代价是编程复杂度上升,收益是资源利用率逼近物理极限。











