


过去几年,ai视频生成总被一个生动的比喻所定义——“抽卡”。
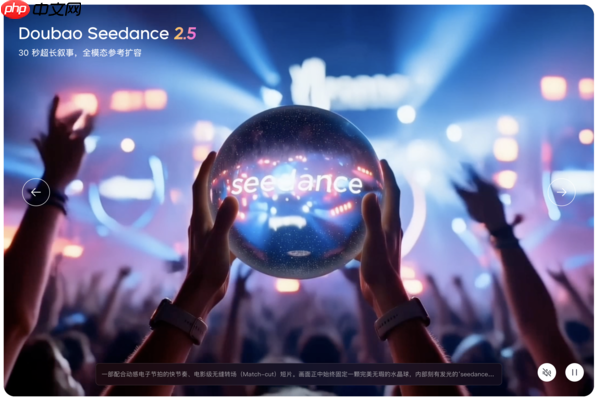
输入一段提示词,点击生成,最终输出的人物是否稳定、镜头是否精准、情节是否连贯,很大程度上取决于模型的概率采样与创作者的运气。一旦结果不尽人意,就只能反复修改提示词、调试参数,再重来一遍又一遍。
对众多AI视频创作者而言,真正的消耗并不在算力或时间,而在于无休止的试错循环。而Seedance 2.5的价值,正在于让视频生成变得更可预期、更可掌控,大幅压低“抽卡率”。
30秒原生直出、50种全模态参考支持、局部区域精准编辑、3D分镜实时预览……这一系列能力跃迁,其本质指向同一个转变:
立即进入“豆包AI人工智官网入口”;
立即学习“豆包AI人工智能在线问答入口”;
AI视频生成正从“随机开箱”,迈向“流程化创作”。
支持单段30秒视频原生生成
AI视频的瓶颈,从来不止于单帧画质。此前行业普遍卡在15–20秒区间,根本原因在于时序拉长后,人物面部形变、光影跳变、物理穿模、运镜断裂等问题高频爆发,严重削弱成片质量。
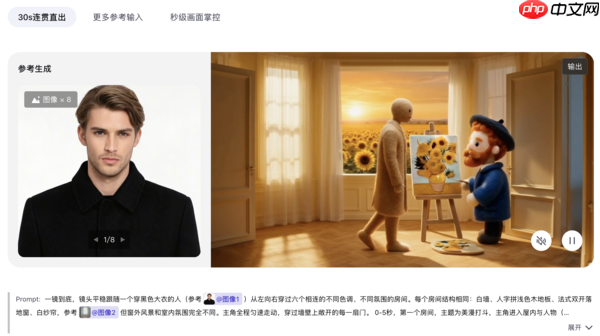
Seedance 2.5实现的30秒单段原生输出,依托的是时空联合扩散架构下的长时序优化能力。其帧间时序注意力机制中集成了长程记忆模块,使模型在生成第N帧时,不仅能关联前后邻近帧,更能锚定起始帧中的人物特征、场景结构与光照设定,确保整段30秒视频从开场到收尾,角色形象、材质表现、环境光影与运镜逻辑均由统一推理路径持续驱动,全程无缝、无拼接感。
事实上,30秒已基本覆盖短剧单场戏、广告核心片段、产品功能演示及知识类教程中的典型叙事单元。以往多数AI视频模型仅能产出几秒“快闪式”素材,创作者不得不大量依赖后期拼接、补帧、重剪与瑕疵修复;而当模型能稳定输出30秒内容,它便开始承载一段完整情节的起承转合、一个镜头内部的动作演进,以及音效节奏、人物状态与场景氛围的持续统一——这标志着AI视频正从“静态画面生成”,升级为“时间维度管理”。
更关键的是,多镜头调度与音画同步能力被同步强化。视频不再是无声的动态图像,而是具备镜头语言、节奏律动与声画反馈的内容实体。这对短剧制作、品牌广告、电商讲解与科普传播尤为关键——这些场景真正需要的,不是零散素材,而是可直接接入生产管线的半成品资产。
全模态参考能力全面增强
Seedance 2.5另一项突破性升级,是全模态参考体系的扩容与深化。
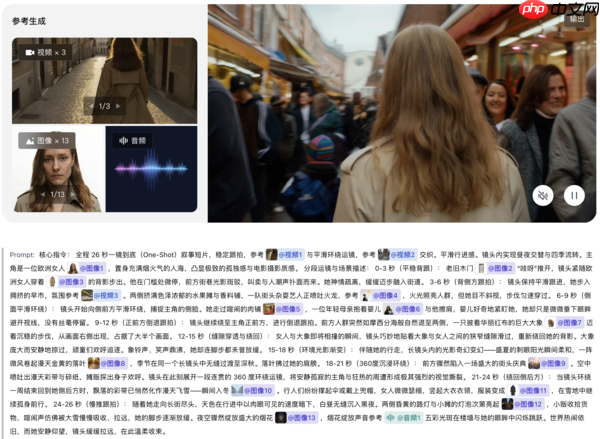
这看似是一个技术功能点,实则极大拓展了创作者的表达边界。过去用户仅靠一句文本提示“抽卡”,模型对角色、产品、空间与风格的理解高度模糊且混杂:你想要一位主角,它可能给出“接近但不精确”的形象;你指定一款商品,它可能生成“轮廓相似但细节缺失”的模型;你想延续某种视觉调性,下一次输出却可能完全跳脱原有世界观。
而如今,创作者可一次性上传人设图、分镜脚本、氛围参考图、动作示范视频、背景音乐等多源素材。模型由此精准识别“角色长相、场景气质、镜头运动方式、动作节拍节奏”。当文本、图像、视频、音频全部成为可解析的参考依据,AI视频的生成过程便拥有了更扎实的创作支点。
这对系列化内容生产尤为关键。

短剧依赖角色一致性,广告依赖产品还原度,IP衍生依赖世界观延续性,电商视频依赖商品细节准确性。创作者最担忧的并非某次生成失败,而是每次都要重新描述“他是谁、它长什么样、这个品牌调性是什么”。
全模态参考扩容,本质上是在削减重复解释的成本,让AI真正理解“上下文”。
从抽卡到创作:Seedance 2.5补上的核心能力是“修改权”
早期AI视频最大的局限,在于用户仅有生成权,缺乏修改权。
一条视频生成后,若80%满意、20%存疑,过去几乎只能推倒重来。而重生成意味着那80%的优质成果也将一并丢失。对专业级内容生产而言,这是不可接受的——创作从来不是一击即中,而是层层迭代。
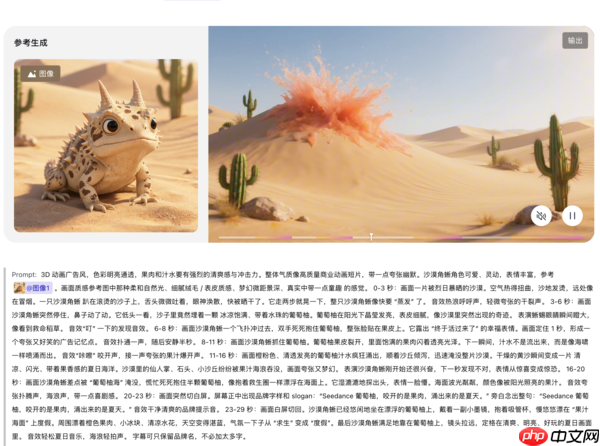
Seedance 2.5将视频延长、局部编辑、参考驱动生成纳入标准任务类型,意味着它不再定位为单一“生成器”,而是向“全流程创作平台”演进。
视频延长,解决故事延展问题;局部编辑,解决细节微调问题;参考生成,解决前后一致性问题。
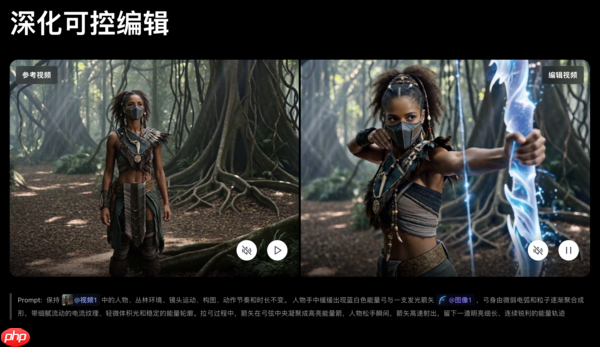
三者协同,AI视频才真正具备从“灵感激发工具”升级为“生产力基础设施”的潜力。
未来更专业的形态,大概率将持续聚焦于局部框选编辑、分镜可视化预演、动作幅度调节、镜头逻辑续写等方向。因为影视工业、广告制作、短剧开发乃至工业仿真,都不是“一次性生成”的游戏,它们都需要在确定性框架内进行可控变量调整。
这正是Seedance 2.5释放的核心信号:它不追求让你少写一个词,而是助你以导演、剪辑师、制片人甚至工程师的身份,真正掌控视频生产的每一个环节。
结语
放眼全球AI视频赛道,Seedance 2.5最值得关注的,并非它在某个单项指标上是否超越Sora、Veo或Runway,而是字节跳动背后构建的生态闭环能力。
海外主流模型各有所长:Sora曾将“视频即世界模拟器”的理念推向高潮;Runway深耕专业创作者市场,强调一致性与可控媒体输出;Veo则持续强化音频建模、真实感渲染与Flow式交互体验。而字节的独特优势,则体现在另一条路径上:内容场景贴近一线、产品入口密集多元、商业化链路高效短平。
豆包、剪映、即梦、火山方舟,叠加字节内部多年积累的内容理解与分发能力,共同决定了Seedance并非孤立存在的大模型,而是天然嵌入C端创作者、内容平台、广告电商系统及B端企业服务的智能基座。
这也解释了为何Seedance 2.5的战略重心,不是打造一个更炫技的“AI魔术师”,而是将模型转化为一种可调用、可采购、可集成进各类生产系统的标准化能力。
AI视频真正的商业化落地,不会发生在用户敲下回车键的那一刻,而将扎根于企业将其嵌入内容生产、营销投放、员工培训、工业仿真乃至数字孪生系统的日常运转之中。














