


在当前高度竞争的就业环境中,企业亟需一套系统化、可落地的招聘筛选标准,以精准识别与岗位高度匹配的优质候选人。mulerun作为智能化招聘协同平台,提供了多路径融合的初筛标准构建机制,兼顾效率、专业性与动态适应能力。
首先,MuleRun支持通过自然语言指令即时生成结构化筛选逻辑。无需预设模板或编写代码,HR只需输入如“寻找3年以上Python后端开发经验、熟悉Django和PostgreSQL、本科及以上学历、有电商项目经历的候选人”等口语化需求,系统即可自动解析语义,拆解为技能标签、经验阈值、学历门槛、行业背景等维度,并智能区分硬性条件与偏好项,生成带权重配置的初筛卡片。
其次,MuleRun可基于结构化JD文档(PDF/DOCX)自动提取核心要求,并结合行业知识图谱补全隐含条件。上传职位描述后,系统高亮识别必需技能、优先技能、经验年限、证书资质及排除规则(如“不接受外包履历”),并支持人工调节匹配强度——例如将“熟悉Kubernetes”设为宽松模式,使其兼容“了解容器编排”等语义近似表达,提升召回率与准确性。
再次,MuleRun内置私有化历史模板库,支持一键复用过往验证有效的筛选方案,并进行最小化参数微调。例如调取“高级Java工程师_2026Q1”模板后,仅需将原“Spring Boot 2.x”升级为“3.x”,将“3年经验”更新为“5年”,并新增“具备CI/CD平台搭建经验”为必选项,即可快速适配新岗位需求,避免重复建模。
最后,MuleRun支持与HRIS系统深度集成,在筛选标准中自动关联组织数据(如部门编制、职级带宽、汇报关系),实现动态加权:例如对高潜岗位自动提升技术栈匹配权重,对急招岗位放宽年限容忍度,并基于实时人才池热度反馈持续优化阈值策略。
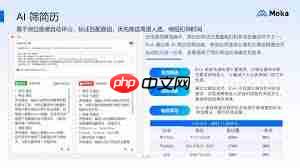
综上,MuleRun构建的筛选标准并非静态规则集,而是融合语义理解、数据驱动、组织语境与业务演进的智能决策模型。它既保障初筛过程的客观性与一致性,又保留HR的专业判断空间,显著缩短简历处理周期,提升人岗匹配精度,为企业打造高质量、可持续的人才供应链提供底层支撑。













