


Nginx流量峰值分析需按时间窗口聚合请求量,识别突增时段,并结合状态码、IP、URL等上下文定位成因;关键步骤包括时间对齐、异常增幅判定(如滑动窗口+2σ)、错误率关联及高频特征筛查。
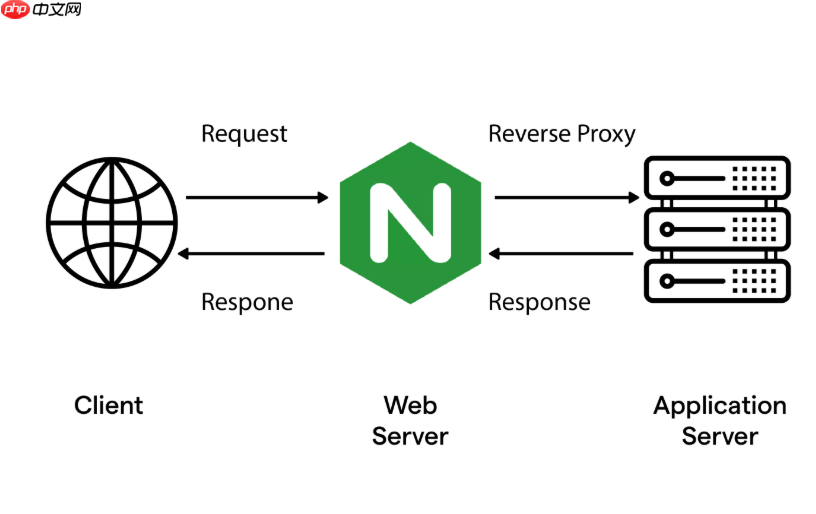
分析 Nginx 访问日志中的流量峰值变化,核心是提取时间维度的请求频次,识别突增区间,并结合状态码、来源 IP、URL 路径等上下文判断成因。关键不在于单纯统计总量,而在于“何时突增、增在哪里、为何发生”。
按时间窗口聚合请求量
用 awk + sort + uniq 或 logstash / Prometheus + nginx_log_exporter 将日志按分钟或 5 分钟切片统计请求数。例如:
- 提取每分钟请求数:
awk '{print substr($4,2,15)}' access.log | sort | uniq -c | sort -nr(假设日志时间格式为[01/Jan/2024:12:34:56) - 更稳健的做法是用
date -d标准化时间戳,再用awk '{key=int((mktime($0)-offset)/60)*60; print strftime("%Y-%m-%d %H:%M", key)}'对齐时间窗口 - 注意排除健康检查(如
/healthz)、爬虫 UA 或内部监控探针,避免干扰真实业务峰值
识别异常增幅与持续时段
单纯看最大值意义有限,需计算同比/环比变化率。例如对比前 10 分钟均值,若当前分钟请求量 > 均值 × 3 且连续 3 分钟超阈值,即标记为有效峰值。

- 用脚本计算滑动窗口标准差:若某分钟数值落在均值 + 2σ 之外,视为离群点
- 观察峰值是否对应固定周期(如整点秒杀、定时任务触发),或突发性(如热点链接被转发、攻击开始)
- 结合
$status字段看峰值期间 4xx/5xx 比例是否同步上升——若错误率飙升,可能是服务过载而非真实流量增长
关联请求特征定位源头
峰值时段内,重点筛查高频 IP、高频路径、异常 User-Agent 和 Referer。
- 查 Top IP:
awk '$9>=200 && $9(过滤成功响应,排除探测和失败请求) - 查高频 URL:
awk '{print $7}' access.log | sort | uniq -c | sort -nr | head -10,注意区分静态资源(/static/)和动态接口(/api/) - 检查 Referer 是否集中来自某外部站点,或 User-Agent 是否大量重复(如 Python-urllib、masscan),辅助判断是正常业务、爬虫还是攻击
可视化与基线比对
将分钟级请求数导入 Grafana 或简单用 gnuplot 绘图,叠加过去 7 天同时间段曲线,能直观看出是否偏离常态。
- 建立每日/每周基线:比如工作日 20:00–22:00 是常规高峰,但某天该时段请求翻倍且集中在单个接口,就需排查新上线功能或营销活动
- 保留至少 30 天日志用于趋势分析;压缩归档前确保已提取结构化指标(如每小时总请求数、4xx 数、平均响应时间)
- 配置告警:当峰值请求量超过基线均值 2.5 倍且持续 ≥5 分钟时,触发通知并自动抓取该时段原始日志片段供人工复核
不复杂但容易忽略的是时间精度和日志采样偏差——确保 Nginx 使用 log_format 记录完整时间戳(含毫秒),且日志未被 rotate 截断或异步写入延迟影响统计准确性。











