


Worker不能用于动态剖析分布式静态资源挂载,因其本质是隔离执行耗时GPU资源初始化任务,需闭环完成加载、解码、上传与绑定,禁止跨线程操作和调试API调用。
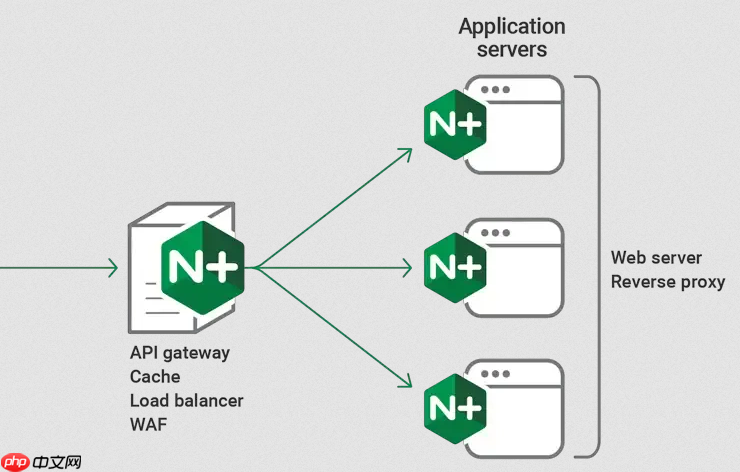
不能直接“动态剖析分布式静态资源的挂载”——这个说法本身存在概念混淆。Worker 的独立堆栈不是用来“剖析”资源挂载过程的工具,而是用来隔离执行、避免阻塞、闭环处理 WebGL 渲染中本该由主线程承担但又极其耗时的资源准备环节。
WebWorker 必须闭环完成资源加载与初始化
WebGL 上下文、纹理、着色器、缓冲区等静态资源,一旦在 Worker 中使用,就必须全程在 Worker 内完成加载、解析、上传和绑定。任何依赖主线程 DOM(如 new Image())、document、URL.createObjectURL() 或同步 fetch 的做法,都会触发隐式跨线程回退,导致卡顿甚至失败。
- 纹理必须用
fetch + createImageBitmap解码,再调用gl.texImage2D - 着色器源码通过
fetch(url).then(r => r.text())获取,不能读取<script type="x-shader">标签 - OffscreenCanvas 实例需在主线程创建后立即传入 Worker,并立刻调用
getContext('webgl2'),不可延迟 -
preserveDrawingBuffer: false是强制项;截图靠gl.readPixels + transferToImageBitmap,而非toDataURL
静态资源“挂载”实为 GPU 资源对象的生成与绑定
所谓“挂载”,在 WebGL 流水线中实际指:把 CPU 端的资源数据(如图像像素、顶点数组、uniform 值)上传至 GPU 显存,并建立可被着色器引用的句柄(texture ID、buffer ID、program ID)。这一过程在 Worker 中不能“观察”或“剖析”,只能主动执行并确保原子性。
- 所有
gl.createTexture()、gl.bufferData()、gl.compileShader()都必须在 Worker 内完成 - 禁止在 Worker 中调用
gl.getError()以外的调试 API(如console.log输出 WebGL 对象),它不返回有效信息且可能触发同步 - 若需验证资源是否就绪,应由主线程发送带版本号/哈希的任务指令,Worker 完成后回传 success 标志+资源元数据(如尺寸、格式),而非暴露内部对象
分布式资源需统一路径策略与预加载协调
“分布式”通常意味着资源来自多个 CDN 或子域名。Worker 本身不管理域名策略,但可通过以下方式适配:
- 主线程预先聚合资源清单(含完整 URL、类型、预期 hash),以
postMessage发送,避免 Worker 多次解析配置 - 对跨域资源,确保服务端返回
Access-Control-Allow-Origin: *,否则fetch直接拒绝 - 利用
Cache API在 Worker 中做二级缓存(需配合Service Worker注册),减少重复网络请求 - 不推荐在 Worker 内做资源 fallback(如主 CDN 失败切备用),应由主线程决策后重新下发任务
真正可“剖析”的是渲染管线阶段行为,不是资源挂载本身
若目标是分析资源如何影响渲染性能,应转向真实可观测的管线指标,例如:
- 用
performance.mark()+performance.measure()记录 Worker 内各阶段耗时(加载 → 解码 → 上传 → 绑定) - 结合浏览器 Graphics Profiler 工具抓取 trace,查看
GPU Memory分配峰值、Render Load波动、Frame Timeline中纹理上传是否成为瓶颈 - 监控
gl.getProgramParameter(program, gl.LINK_STATUS)和gl.getShaderParameter(shader, gl.COMPILE_STATUS)返回值,定位着色器失败根源
不复杂但容易忽略:所谓“剖析挂载”,本质是控制变量、测量结果、归因到具体 API 调用。Worker 提供的是干净的执行沙箱,而不是调试探针。













