


核心是Nginx upstream连接生命周期与后端长连接服务错配导致上下文泄漏,表现为RSS上涨、AnonHugePages增长、ESTAB连接堆积;需从诊断、超时对齐、后端配合、监控四方面协同解决。
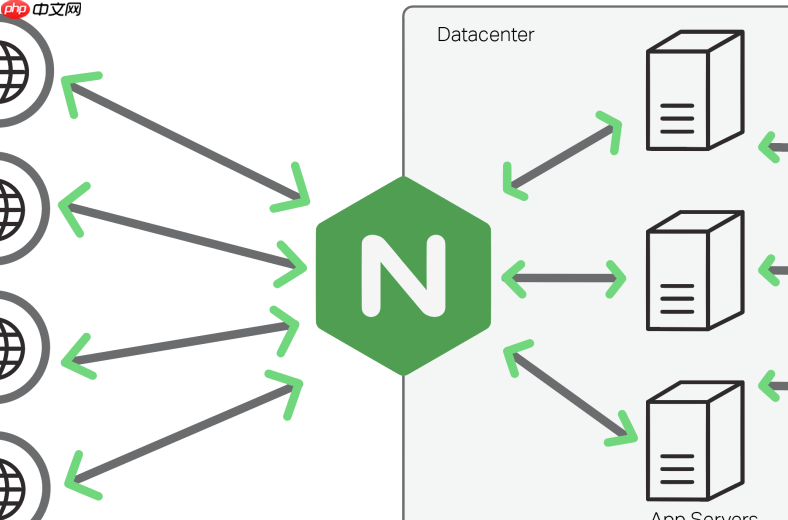
这个问题核心不在“Nginx显式绑定代理被销毁”,而在于分布式实时协作文档系统中,Nginx 作为反向代理层,其 upstream 连接生命周期与后端长连接服务(如基于 WebSocket 或 SSE 的协作服务)严重错配,导致连接上下文在内存中堆积不释放。这种泄漏表现为:worker 进程 RSS 持续上涨、/proc/<pid>/smaps 中 AnonHugePages 或 Anonymous 段异常增长、ss -tnp | grep nginx 显示大量 ESTAB 状态但无活跃流量。
以下是针对性解决路径:
一、确认是否为 upstream 连接上下文泄漏
不是 Nginx 自身代码级泄漏,而是它维护的代理连接状态未及时清理:
- 执行
curl http://127.0.0.1/nginx_status(需启用stub_status),观察Active connections长期高于业务并发量,且Writing数值持续不归零; - 查看后端服务实际连接数:
lsof -i :<backend_port> | grep nginx | wc -l,若远高于 Nginx worker 数 ×keepalive设置值,说明连接未复用或未关闭; - 检查 Nginx error 日志是否有
upstream timed out (110: Connection timed out)或no live upstreams类报错,表明健康探测失效。
二、强制对齐 Nginx 与后端的连接生命周期
重点修正 upstream 和 location 块中的超时与保活策略:
-
在
upstream中明确限制连接复用与存活时间:upstream collab_backend { server 127.0.0.1:8081 max_fails=2 fail_timeout=15s; keepalive 16; # 每个 worker 最多缓存 16 个空闲连接 keepalive_requests 100; # 每个 keepalive 连接最多承载 100 个请求(防长连接僵死) keepalive_timeout 30s; # 后端空闲连接最大保持时间 } -
在
location中适配实时协作协议(WebSocket / HTTP/1.1 流):location /collab/ { proxy_pass http://collab_backend; proxy_http_version 1.1; proxy_set_header Upgrade $http_upgrade; proxy_set_header Connection "upgrade"; # 必须透传 upgrade,否则 WebSocket 断连后不触发 cleanup proxy_set_header Host $host; # 关键:禁用 Nginx 自主缓存响应体,避免 hold 上下文 proxy_buffering off; proxy_cache off; # 主动探测后端健康,避免半开连接堆积 proxy_socket_keepalive on; proxy_next_upstream error timeout http_502 http_503 http_504; }

三、约束后端服务自身连接行为
协作后端(如基于 Node.js Socket.IO、Go Gin+WebSocket、或 Java Spring WebFlux)必须主动配合:
- 后端设置 比 Nginx
keepalive_timeout更短的 idle timeout(建议 ≤25s),确保它先断开; - 启用连接最大请求数限制(如 Node.js
server.maxRequestsPerSocket = 50),防止单连接无限复用; - 禁止后端监听
0.0.0.0:<port>,仅绑定127.0.0.1:<port>,并用ufw或云安全组封锁该端口对外访问,杜绝绕过 Nginx 的直连请求(此类请求完全脱离 Nginx 连接管理,极易造成上下文泄漏)。
四、启用连接级监控与自动干预
-
部署轻量脚本定期检查异常连接:
# 检测单 worker 连接数是否超阈值(如 > 200)
for pid in $(pgrep nginx); do
    conn_count=$(ss -tnp | grep ":<backend_port>" | grep "pid=$pid" | wc -l)
    if [ "$conn_count" -gt 200 ]; then
        echo "WARN: worker $pid has $conn_count backend connections" | logger
        # 可选:对特定 worker 发送 SIGUSR1 触发日志重载,间接促使其清理部分连接
    fi
done
将
nginx_stub_status指标接入 Prometheus,告警规则示例:avg_over_time(nginx_connections_active[10m]) > 1.5 * on(instance) group_left() nginx_workers * 16
不复杂但容易忽略。










