




反向代理稳定性取决于Nginx worker进程模型、内存隔离与连接生命周期管理;每个worker独立管理连接、缓冲及健康状态,需按per-worker维度配置keepalive、超时与探活策略。
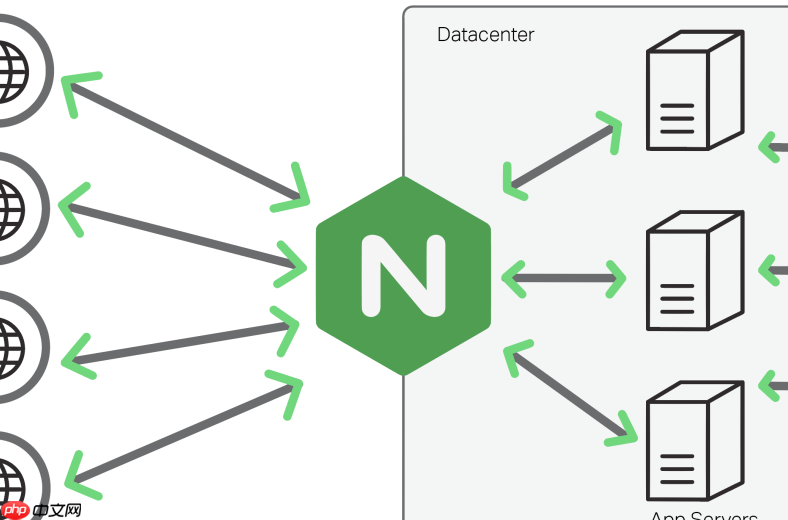
反向代理不是“配个 proxy_pass 就完事”,它的底层稳定性和行为表现,直接取决于 Nginx 进程模型、内存隔离机制、连接生命周期管理这三根支柱。避坑的关键,是理解 worker 进程如何与内核 socket、上游服务、客户端真实交互——而不是背配置项。
worker 进程与操作系统级连接资源绑定不可忽略
Nginx 的每个 worker 进程是独立的用户态进程,不共享连接池、不共享 upstream 连接缓存、不共享 keepalive 连接句柄。这意味着:
- upstream keepalive 最大连接数(
keepalive N)是 per-worker 限制,不是全局总数;若开 4 个 worker,实际最多可复用 4×N 条到后端的空闲连接 - client_max_body_size、client_header_timeout 等 client 相关指令,在每个 worker 内单独生效;超限触发的是该 worker 内部的 413/408,不会跨 worker 同步状态
- 使用
reuseport(如listen 80 reuseport)可让内核在 accept 阶段就做负载分发,避免惊群;但需确认系统内核 ≥ 3.9 且未被 SELinux 或容器运行时禁用
连接复用必须区分 client 和 upstream 两个维度
很多人混淆“客户端长连接”和“到上游的长连接”,其实它们完全独立,且复用策略互不影响:

- 客户端 keepalive:靠
keepalive_timeout+keepalive_requests控制,只影响 client ↔ nginx 的 TCP 连接复用;超时或请求数超限后,Nginx 主动 FIN - 上游 keepalive:需显式启用
upstream { keepalive 32; },且 backend 必须支持 HTTP/1.1 或 HTTP/2,否则连接无法复用;Nginx 不会自动探测后端是否支持,错误配置会导致连接频繁重建 - 关键细节:upstream keepalive 不等价于 connection pool;它只是把空闲连接挂起在 worker 私有哈希表中,一旦后端响应异常(如 RST、超时),该连接立即从池中剔除,不会重试或标记为“脏”
proxy_buffering 和 proxy_buffer_size 的误用是性能隐形杀手
默认开启的 proxy_buffering on 表面提升吞吐,实则极易引发内存膨胀与延迟毛刺:
- buffer 大小由
proxy_buffer_size(首块 buffer,仅存响应头)和proxy_buffers(后续 body buffer)共同决定;若后端返回大文件(如 10MB PDF),且未设proxy_buffering off或proxy_max_temp_file_size,Nginx 可能将全部内容暂存内存或临时文件,拖慢整个 worker - 流式接口(如 SSE、gRPC-Web、chunked JSON)必须关闭 buffering:
proxy_buffering off,否则 Nginx 会攒满 buffer 才转发,破坏实时性 - 注意:
proxy_buffering off不等于禁用所有缓冲——TCP 层的 socket send buffer 仍存在,只是取消了 Nginx 用户态响应体缓冲;此时更依赖proxy_buffer_size对 header 的安全兜底(建议至少 128k)
upstream fail_timeout 与 max_fails 的真实语义常被曲解
这两个参数控制的是“健康检查失败后的临时摘除”,但判定逻辑非常具体:
-
max_fails=3指:在fail_timeout=10s时间窗口内,同一 upstream server 连续发生 3 次失败(connect timeout / 5xx / 4xx 中显式配置的proxy_next_upstream error timeout http_500等)才会标记为 down - “连续失败”不是指任意 3 次,而是指该 server 在本轮请求选择中被选中后发生的失败;如果轮询跳过它,计数器不会累加
- server 被标记为 down 后,并非等到
fail_timeout结束才恢复,而是下次请求时尝试一次 probe —— 成功则立刻恢复,失败则重置倒计时 - 务必配合
health_check(需 stream 或 http 模块启用)或外部主动探活,否则被动摘除对瞬时抖动过于敏感,易引发雪崩
真正稳的反向代理,不是靠堆参数,而是清楚每条连接在哪个进程里、何时创建、谁负责关闭、失败时谁来兜底。把 worker 当作一个个封闭的通信单元去建模,很多“诡异问题”就自然消解了。











