





Nginx高可用自愈网关基于多worker进程+事件驱动模型,通过健康检查、失败重试、缓存降级和状态上报构建可观测、可干预的服务入口体系。
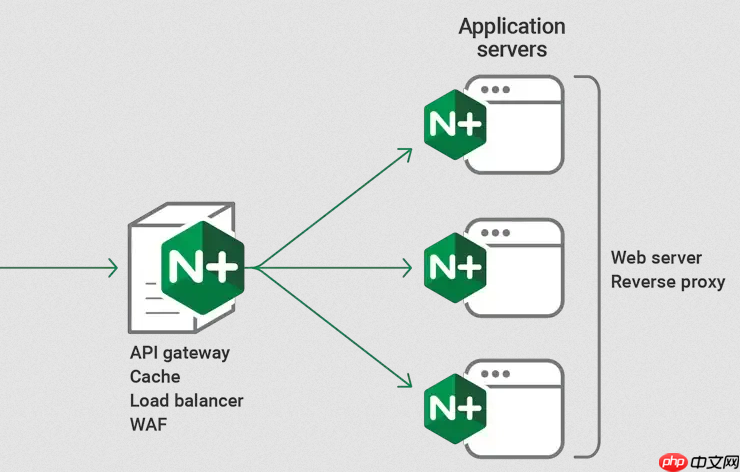
这个说法听起来很技术化,但其实核心目标很明确:用 Nginx 的轻量、稳定、高并发能力,配合反向代理机制,构建一个能自动响应故障、维持服务可用性、状态可观察且可控的服务入口体系。它不是靠“单线程”实现的——Nginx 实际是多 worker 进程(每个进程单线程 + 事件驱动),真正支撑弹性的是它的异步非阻塞 I/O 模型(epoll/kqueue)和模块化设计。
理解底层底座的真实含义
Nginx 并不运行在“单线程”上,而是采用“一个 worker 进程 + 一个事件循环”的模型,多个 worker 并行工作。这种设计避免了线程切换开销,又能充分利用多核 CPU。它的“多路复用”体现在:单个 worker 可同时管理数万连接,靠操作系统内核的高效事件通知机制(如 Linux 的 epoll)来轮询就绪事件,而不是为每个连接开线程或进程。
- worker_processes 应设为 CPU 核心数(或 auto),确保负载均衡到各核
- 每个 worker 的连接上限由 worker_connections 控制,需结合系统 ulimit 调整
- 务必启用 use epoll;(Linux)或 use kqueue;(macOS/BSD),否则回退到低效 select/poll
Proxy 代理层要承担“状态感知”与“行为决策”
单纯 proxy_pass 不足以构成“自愈”。关键是在 upstream 中注入健康检查、失败重试、降级策略和状态反馈逻辑:

aperture: the L402 aware reverse proxy
下载
安装并运行 Aperture(Lightning Labs 的 L402 闪电反向代理),用于创建 L402 付费墙、配置付费 API 端点、为其他代理托管付费内容或测试 L402 认证流程。
- 使用 upstream 块定义后端集群,并开启 health_check(需 stream 或 http 模块支持),支持主动探测(HTTP HEAD/GET)或被动检测(连续失败次数 + fail_timeout)
- 配置 proxy_next_upstream error timeout http_500 http_502 http_503 http_504,让请求在上游异常时自动转发给下一个可用节点
- 搭配 proxy_cache_use_stale updating error timeout http_500,允许在上游不可用时返回过期缓存,保障基本可用性
- 用 proxy_redirect 和 add_header 注入 X-Upstream-Status 等自定义头,便于前端或监控系统识别当前路由状态
构建受控状态树的关键配置结构
所谓“状态树”,本质是把服务拓扑、健康状态、路由策略、缓存生命周期等维度组织成可查询、可干预、可版本化的配置结构。推荐分层组织:
- 全局层(http 块):定义 cache_path、upstream 默认参数、日志格式(含 $upstream_addr $upstream_status)、map 变量做动态路由判断
- 服务域层(server 块):绑定域名/IP,设置 access_log 和 error_log 分离,启用 keepalive_timeout 和 reset_timedout_connection
- 路径粒度层(location 块):按 /api/v1/、/static/、/healthz 等划分,各自配置 proxy_pass、proxy_cache、限流(limit_req)、熔断(proxy_next_upstream + max_fails)
- 健康探针专用 location:如 location = /healthz { return 200 "OK\n"; },不走 proxy,供外部巡检调用
让“自愈”真正落地的三个动作
配置只是基础,自愈能力需要闭环反馈:
- 接入 Prometheus + nginx-vts-exporter 或官方 nginx-plus-module,采集 upstream 状态、request rate、response time、failures 等指标
- 用 Grafana 做可视化看板,对 upstream 下游节点的 down 状态、5xx 上升趋势设置告警
- 配合 Consul 或 etcd,通过 Lua(nginx-lua-module)或 NJS 脚本,在检测到持续失败时自动从 upstream 移除节点,或触发 webhook 通知运维介入













