


要让Nginx在多核CPU上跑满每核,需实现网络中断、软中断处理与worker执行三者CPU绑定对齐:启用多队列网卡并配置RPS分流NET_RX软中断;worker_processes设为物理核数,配合worker_cpu_affinity绑定至对应核心;NUMA架构下用numactl限制CPU与内存节点绑定;负载均衡优先选用低开销的round-robin算法。
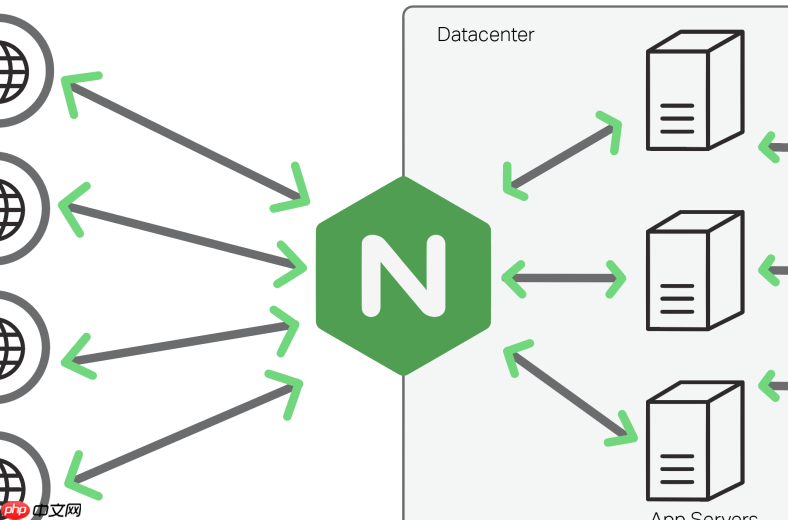
让 Nginx 在多核 CPU 上真正跑满每颗核心,关键不是简单开多个进程,而是让网络中断、软中断处理、worker 执行这三步全程落在同一组匹配的 CPU 核上,避免跨核调度和跨 NUMA 节点内存访问带来的性能损耗。
启用多队列网卡并配置 RPS
单队列网卡会把所有网络中断集中压到一个 CPU,造成 NET_RX 软中断堆积。必须启用硬件多队列,并配合内核 RPS(Receive Packet Steering)做软件层面分流:
- 用 ethtool -l eth0 查看网卡支持的最大队列数,再执行 ethtool -L eth0 combined N(N 为物理 CPU 核数)启用多队列
- 开启 RPS:向 /sys/class/net/eth0/queues/rx-0/rps_cpus 写入十六进制掩码,例如 8 核写 ff,16 核写 ffff
- 运行 watch -n 1 'cat /proc/softirqs | grep NET_RX' 观察各 CPU 的软中断增长是否均衡
绑定 worker 进程到专属 CPU 核
仅分散软中断不够,worker 必须与处理该流量的 CPU 对齐,否则缓存频繁失效,反而拖慢响应:

- 设 worker_processes auto 或显式等于物理核总数(如 32 核就设 32)
- 启用 worker_cpu_affinity auto 让 Nginx 自动绑定;或手动配置位掩码,如 8 核服务器:
worker_cpu_affinity 00000001 00000010 00000100 ... - 加 worker_priority -20 提升调度权重,减少被其他进程抢占的机会
适配 NUMA 架构,限制内存访问范围
双路或多路服务器中,每个 CPU node 绑定本地内存,跨 node 访存延迟可翻倍:
- 先用 lscpu 和 numactl --hardware 确认节点拓扑,记下每个 node 的 CPU 编号和内存容量
- worker_processes 设为单 node 的物理核数(如双路 32 核,每路 16 核 → 设 16)
- 用 numactl --cpunodebind=0 --membind=0 /usr/sbin/nginx 启动主进程
- 验证:运行 numastat -p $(pgrep nginx),local_node 应 >95%,foreign 接近 0
选用低开销负载均衡算法
算法本身消耗 CPU,尤其在高 QPS 场景下不可忽视:
- round-robin 开销最低,仅需计数器取模,适合绝大多数反向代理场景
- ip_hash 或 hash $request_uri 需哈希计算,万级 RPS 下可能占 worker CPU 的 8%~20%
- least_time 依赖共享内存锁读响应时间,在 16 核+、后端超 32 台时易引发锁争用,推高 sys CPU











