





每一次技术范式的深刻更迭,都意味着旧有格局的松动与全新物种的孕育。
步入2026年,大模型竞赛已悄然演变为一场关于参数体量与算力密度的无尽追逐。就在此时,一家成立仅三年有余的中国初创企业——智象未来(HiDream.ai),凭借底层架构的原创突破,在群雄割据的图像生成领域成功凿开一道关键突破口。
国内榜首、全球亚军
智象未来刷新国产图像生成模型新高度
近期,智象未来(HiDream.ai)正式发布商用级图像生成模型 HiDream-O1-Image-1.5,再度刷新SOTA纪录。在国际权威AI模型评测平台 Artificial Analysis 的文生图榜单(Text to Image Leaderboard)中,该模型强势登顶中国第一,并成为全球仅次于 OpenAI 的图像生成模型,力压 Google Nano Banana 2(Gemini 3.1 Flash Image Preview)、NVIDIA Cosmos3-Super-Text2Image 及字节跳动 Seedream 4.0 等国内外一线厂商主力模型。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
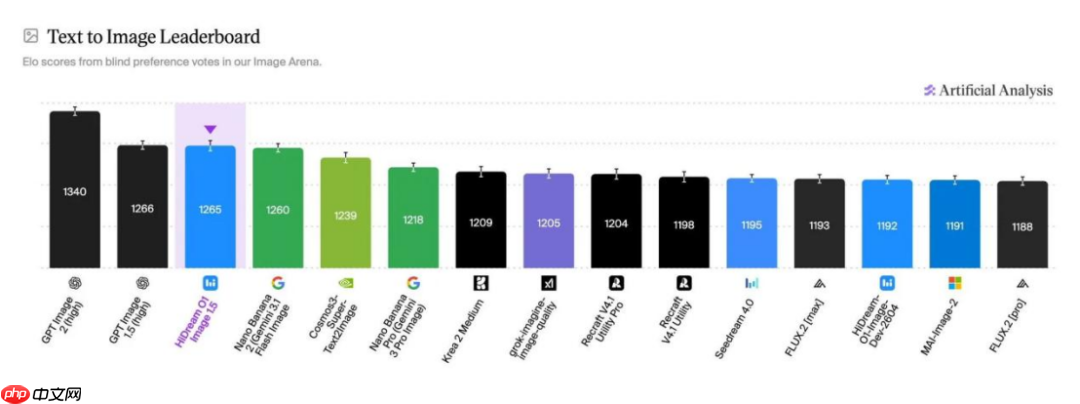
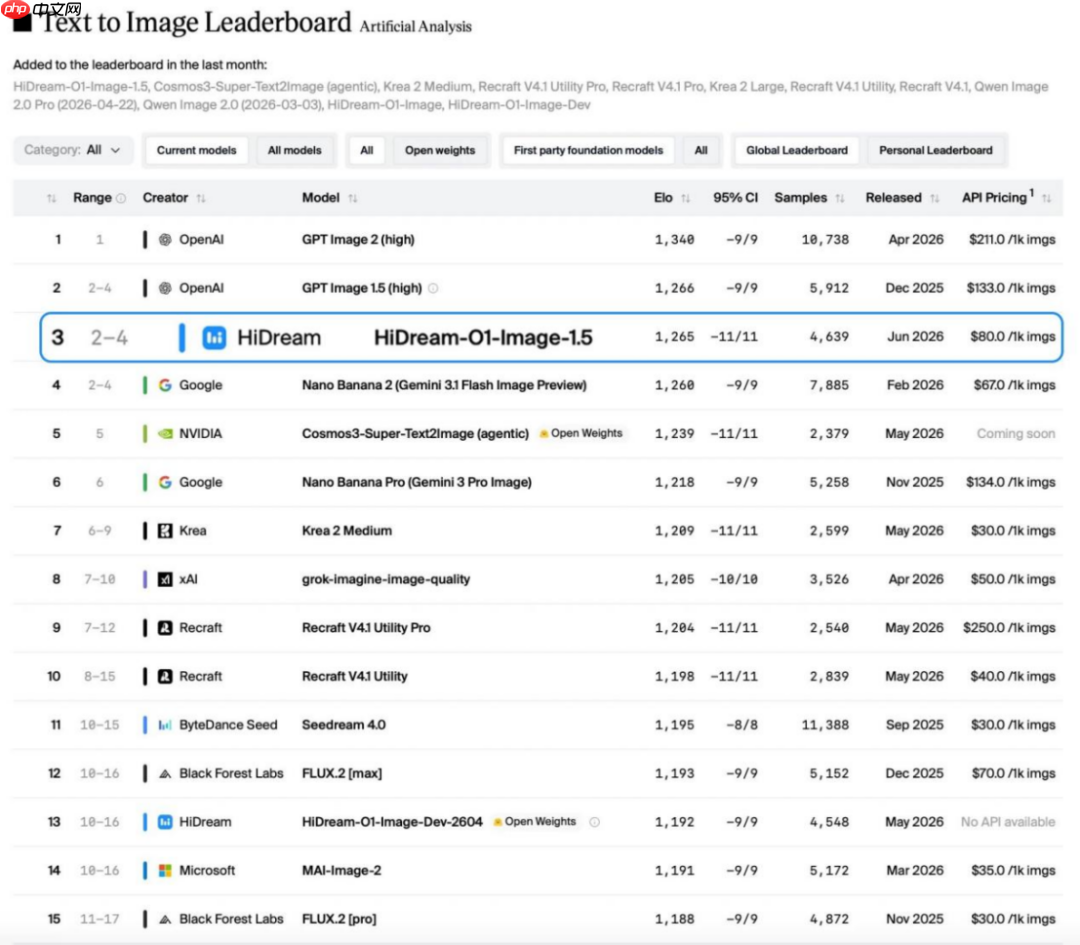
这并非偶然的技术闪光。就在数周前,智象未来原生全模态 HiDream-O1 系列开源模型 HiDream-O1-Image-Dev-2604 已率先斩获文生图榜单开源模型全球第一。
短短半个月内两度问鼎全球,不禁引人深思:一家成立仅三年的创业公司,何以在图像生成这一高壁垒赛道中,接连超越谷歌、字节等科技巨头?是评测机制下的短期优化,还是实打实的技术硬实力?这份成绩单背后,又映射出怎样的时代转向?
榜单背后的真相——UiT 架构的胜出
Artificial Analysis 的 Text to Image Leaderboard 采用匿名对比、真实用户投票与 ELO 动态评分机制,最大限度规避品牌效应干扰,更贴近开放生成场景下用户的实际偏好。在该严苛评测体系下,HiDream-O1-Image-1.5 在逾4000组样本对比中取得1265 ELO分值。其表现不仅印证了图像质量的领先性,更凸显其在语义精准度、复杂构图理解、文字渲染能力及多主体协同控制等综合维度的全面提升。
放眼整场“竞技”,智象未来的对手不乏万亿市值的科技巨擘:Google 坐拥自研TPU集群与顶尖人才储备,字节跳动则握有海量流量入口与成熟应用生态。在算力资源、数据规模与产业协同均不占优的前提下,这家初创公司实现反超,核心在于选择了一条迥异于主流的技术路径。
当前全球主流文生图模型,普遍沿袭“文本编码器 + VAE(变分自编码器)+ DiT(扩散Transformer)”的经典模块化结构,行业亦长期将扩大参数量、堆叠算力作为主要升级手段。而智象未来果断放弃这条成熟路径,毅然踏上一条更具挑战却也更具潜力的道路——像素级原生全模态架构 UiT。
传统文生图模型通常采用“文本编码器 + VAE + DiT / 扩散模型”的拼接式架构,其信息处理逻辑如同一棵不断分叉的树:文本拥有专属 tokenizer,图像与视频各自配备独立 encoder/decoder,音频、动作、空间关系等信号也常被分流处理,各模块间需反复转换表征,极易造成信息衰减。在长文本排版、UI设计、多主体画面、多参考图联动、连续分镜等高阶任务中,这种多次模态转换常导致细节模糊、语义偏移与画面结构失稳——这也正是当前多数商用图像模型难以突破的核心瓶颈。
智象未来 HiDream-O1 系列所采用的原生全模态架构,则彻底重构了信息流动范式。该架构摒弃传统方案中的专用文本编码器与独立VAE模块,将图像像素、文本Token、视频体素、音频波形、动作序列及空间关系等原始信号,统一映射至同一共享表征空间,并由一套 UiT(像素级统一 Transformer)完成全模态的理解、建模与生成。区别于业内常见的“多模态后期融合”策略,UiT 从模型最底层即实现跨模态信号的原生交互,从根本上降低模态转换损耗。
一家企业的技术抉择,往往根植于其团队的认知积淀与实战经验。要读懂智象未来的选择,必须回溯这支团队的成长轨迹。
智象未来核心技术团队深耕 AIGC 领域逾十年,完整参与三代 AI 模型演进历程,是国内罕见由院士领衔、兼具全栈技术能力与规模化落地经验的多模态AI团队。早在2017年,团队便提出 TGANs-C,系全球最早一批视频生成模型论文之一;也曾深度支撑全球第二大视频搜索引擎、中国最大自营电商平台图片搜索系统等大型基础设施建设,并将多模态技术成功应用于物流具身智能、千卡级准实时智能视频推理等高复杂度工业场景。
这意味着,智象未来不仅具备前沿算法研发能力,更历经算法—工程—业务的完整闭环锤炼。决定技术高度的,是持续攻坚底层创新的定力;决定商业纵深的,是穿越真实产业场景的实战能力。
智象未来从不缺乏颠覆常规的勇气。
在其技术哲学中,图像被定义为现实世界建模的空间基底。单张图像凝结着某一瞬完整的场景结构、光影分布、空间关系与主体语义,它不是孤立的能力单元,而是通向视频生成乃至原生全模态世界模型的关键入口。基于这一前瞻判断,公司确立了“以图像为锚点,纵向延伸至视频与全模态”的发展主轴。
纵观当前格局,头部厂商普遍以大语言模型为中枢构建多模态体系。文本作为主流认知媒介,围绕其形成的工具链、产品矩阵与商业护城河早已根深蒂固,也让大厂难以彻底重构现有技术栈。而成立时间较短的智象未来并无历史包袱,团队提出全新主张:在多模态发展的新阶段,原始信号本身即可承载认知,文本不再是不可或缺的中间桥梁。
目前全球多模态技术路线尚未收敛,行业仍处于关键的路线竞速期。当巨头受限于既有技术惯性难以全面革新时,初创企业凭借组织轻量化、试错成本低等优势,依托底层架构创新,反而有望实现代际跃迁。
智象未来的破局路径,可归纳为三个维度:
第一,在架构层面构筑代际壁垒,用有限资源锻造核心竞争力。
智象未来并未卷入 DiT 主流赛道的算力军备竞赛,而是集中火力打磨自研 UiT 原生全模态架构。这条路前期投入大、容错率低,但一旦验证成功,便可能形成结构性代际优势。据团队透露,在相近训练数据与计算资源条件下,其8B参数模型已能对标甚至超越行业百亿级传统模型的综合性能,展现出显著更高的参数效率。
这种对底层架构的极致追求,并未使其陷入“为创新而创新”的技术空转。相反,在工程落地层面,智象未来展现出极强的务实精神。以视频生成为例,团队坚持“先图像、后视频”的渐进策略:优先通过图像模型完成技术验证与快速迭代,再将成熟能力迁移至视频领域。该路径使训练成本压缩至行业平均水平的五分之一至十分之一——正是这种以极限资源打造核心业务的生存智慧,助力创业公司在巨头环伺中走出独特节奏。
第二,推动模型与垂直场景深度咬合,构建难以复制的产业护城河。
智象未来远不止是一家模型公司。如前所述,商业化始终是其创立之初的核心命题。经过多年沉淀,公司已形成“1+1+3”立体布局:一个 HiDream 模型底座、一个能力输出平台,以及三大智能体应用场景——面向专业影视团队的影视创作协作智能体「帧赞」、服务电商(尤其跨境商家)批量营销内容生产的 HiBurst,以及面向专业社媒创作者的 vivago,真正实现模型能力与产品价值的深度耦合。
商业营销智能体 HiBurst 已跻身 TikTok 官方服务商 Top 5,年生成电商营销视频超百万条,覆盖 GMV 超亿元;AI 影视创作与协作智能体「帧赞」打通“创意—分镜—成片”全流程,累计制作短漫剧超5000分钟,并已接入长江电影集团、慈文传媒等头部影视机构;社媒创作智能体 vivago 近期登顶 Product Hunt 日榜首位,覆盖全球100余国,服务用户超4000万。
智象未来的专业影视视频生成业务,目前已稳定支持 one-shot 直出1–3分钟视频,成功率逾70%。在当下“抽卡式”生成尚为主流的背景下,这一指标极具说服力。
第三,坚守战略定力与持续认知跃迁。
当绝大多数同行仍在传统架构上持续加码时,智象未来敢于“归零重启”,全力押注原生全模态。这份“清零再出发”的魄力,源于创始团队的双重坚守:一面是战略定力,一面是认知迭代。 他们未被算力比拼与参数内卷裹挟,始终笃信“全模态原生融合才是通往世界模型的必经之路”;同时又在每次技术演进中主动复盘路径、刷新认知。这种既沉得住气又跟得上节奏的能力,构成了公司持续创新的深层动能。
会排版、识文字、懂分镜
原生全模态迈入生产验证新阶段
这种持续进化的能力,正加速转化为一系列可见的战略成果。HiDream-O1-Image-1.5 登顶全球权威榜单,便是最具象的佐证。
HiDream-O1-Image-1.5 展现出远超“精美图片”范畴的全能图像生成能力。它不再满足于静态画面的视觉呈现,而是具备复杂排版理解、多语言文字渲染、连续分镜逻辑把控等高阶能力。
同时,HiDream-O1-Image-1.5 的商用定位,标志着原生全模态正式迈入生产验证阶段,能够切实解决真实业务中的高频痛点。过往许多AI图像模型难以进入商业流程,尤其在复杂排版、多主体一致性、长文本渲染等环节存在明显短板,而 HiDream-O1-Image-1.5 在这些方面实现了实质性突破。
该模型面向广告营销、品牌设计、电商视觉、游戏内容、影视分镜、IP创作等高要求商业场景,全面强化了图像质量、文字可读性、版式合理性、多主体稳定性及视觉叙事连贯性。
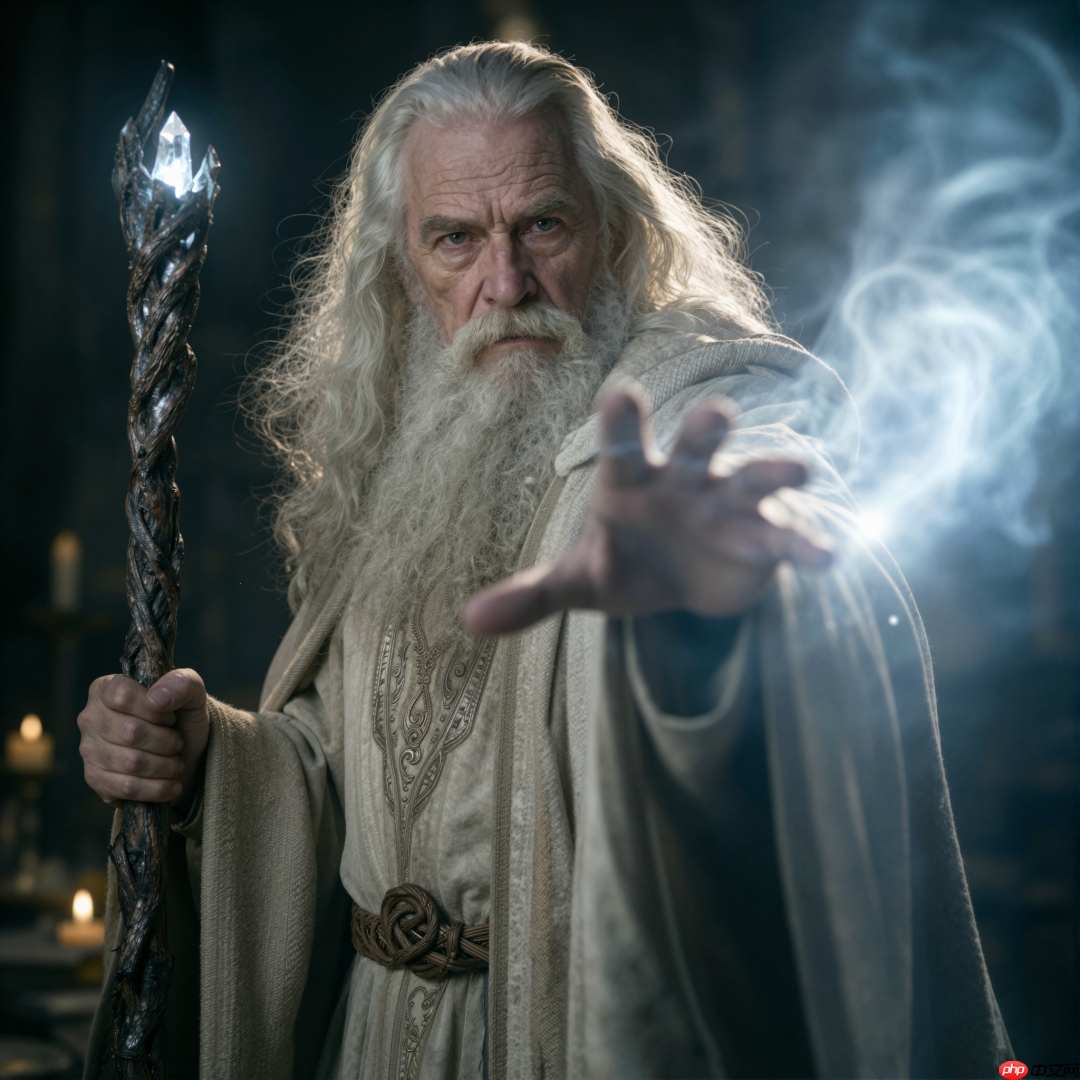
人像摄影场景
模型可生成摄影级画质图像,适配魔幻光影、人物特写、双人互动等多种风格。在皮肤质感、服饰纹理、肢体自然度、背景虚化等细节上表现细腻;面对广角构图、低机位拍摄、室内暖光等复杂条件,仍能保持人物比例协调、空间透视准确与画面叙事统一,可满足商业人像、品牌视觉、影视分镜等专业需求。
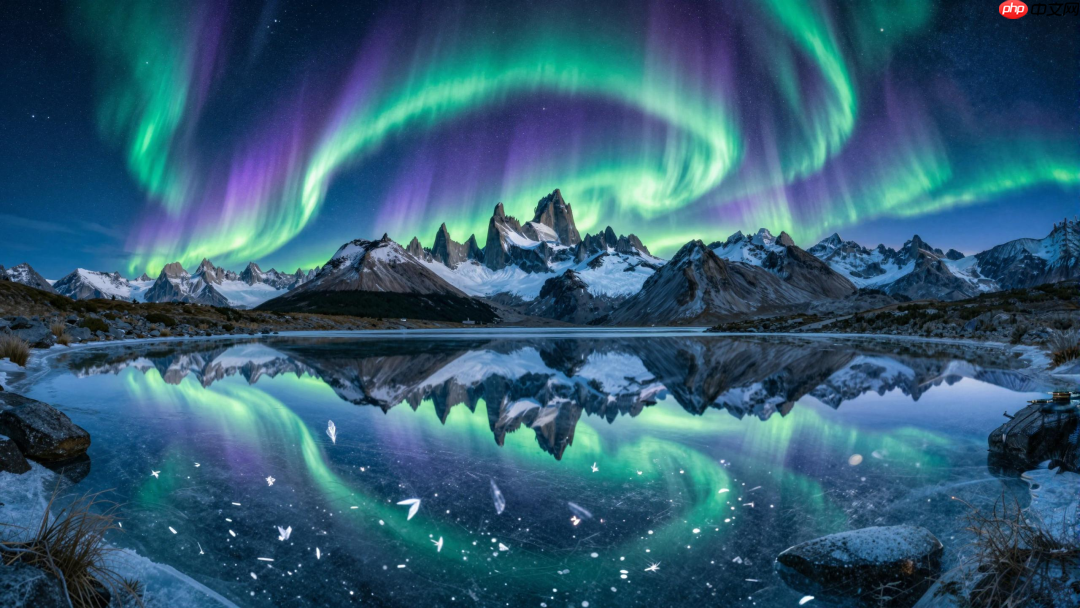
自然风光场景
针对雪山湖泊、沙漠戈壁、地下洞穴等宏大场景与复杂地貌,模型能精准把握空间层次、光影过渡与环境氛围,画面兼具电影级质感与丰富细节,适用于旅游宣传、影视概念图、游戏场景设计、品牌视觉传播等多元场景。
电商海报场景
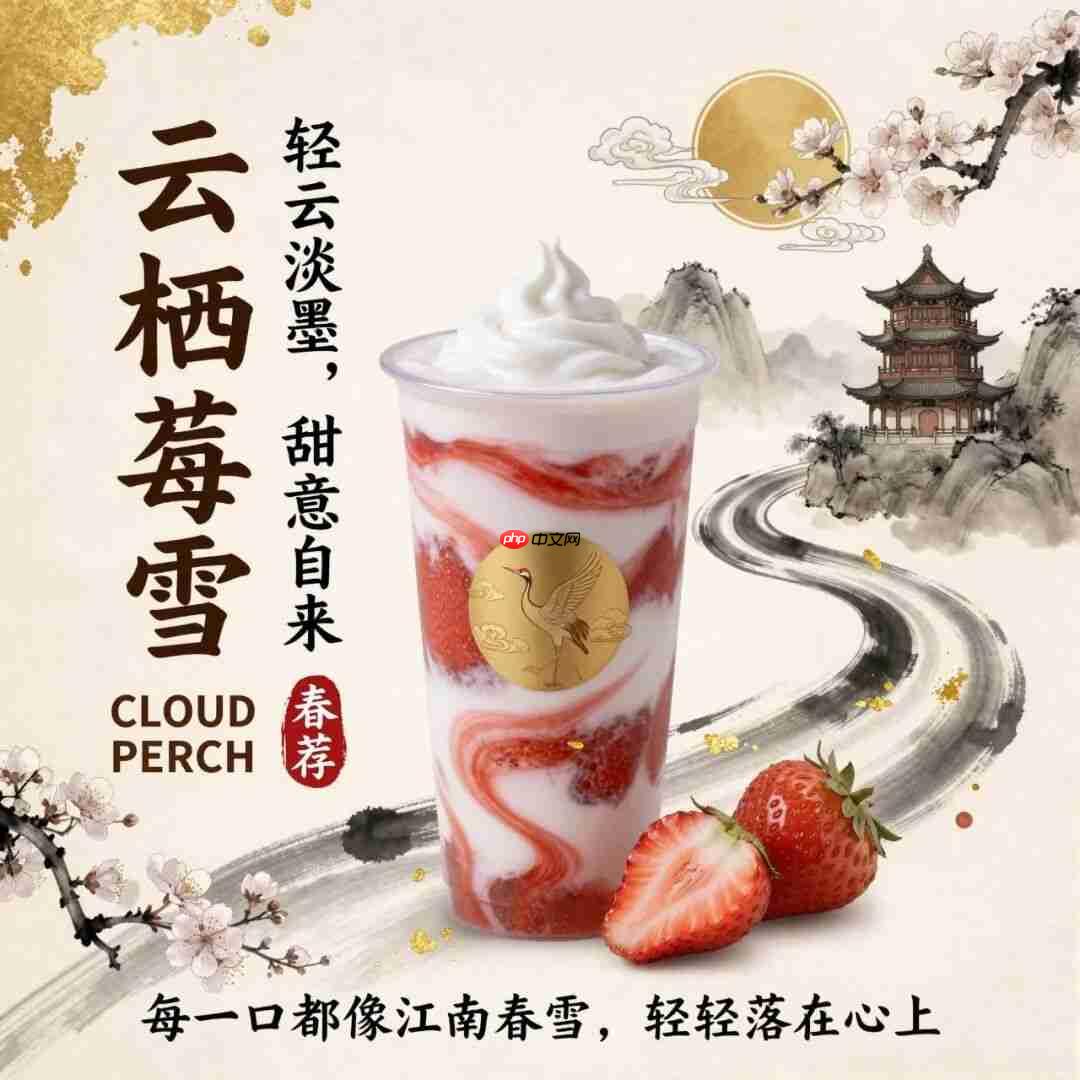
可快速匹配不同品类商品的视觉调性,将产品主体、场景氛围、装饰元素与营销文案有机融合。面对中英文混排、多层级卖点、复杂版式等需求,仍能保障文字清晰可读、画面整体和谐,显著提升电商上新、广告素材、社交种草等内容的生产效率。
多宫格与分镜设计
模型具备连续视觉叙事理解能力,在绘本创作、故事脚本、广告分镜、短视频脚本等多画面任务中,可生成逻辑连贯的内容,并保持角色形象、场景设定、视觉风格的高度统一;对宫格布局、标题标注、序号编排等元素亦能合理组织,有力支撑漫画、影视、教育类内容的可视化生产。
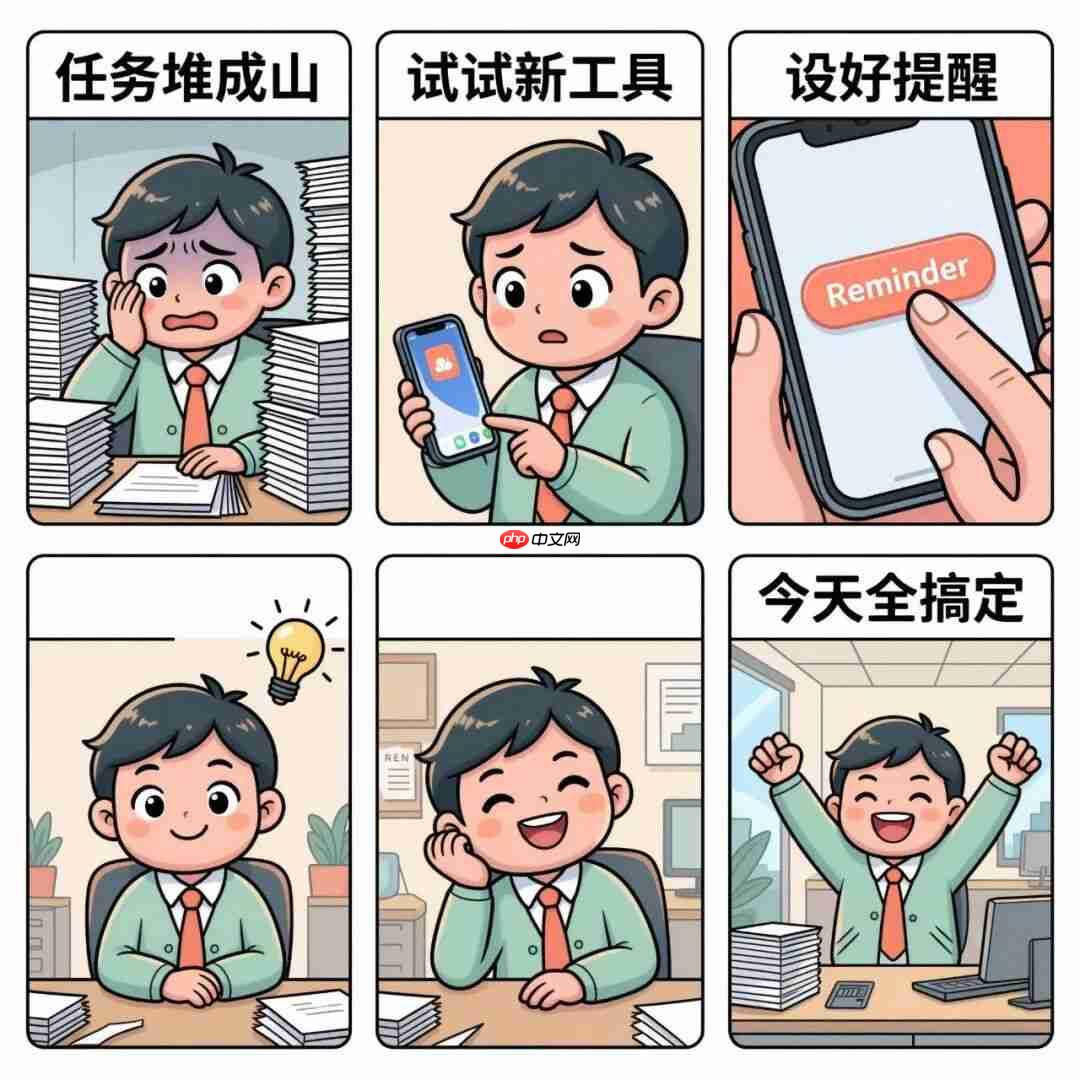
HiDream-O1-Image-1.5 的卓越表现表明,UiT 路线不仅带来单图生成质量的跃升,更在多图一致性、分镜生成、视频首帧生成乃至长视频生成等复杂任务中展现出更稳健的底层能力。
站在2026年的关键节点回望,AI图像生成的竞争逻辑正在悄然重塑。它已不再局限于参数规模的数字竞赛,也不止于“画面是否美观”的主观评判——而是迈入一个由架构先进性、生产实用性与工作流嵌入度共同定义的新纪元。
当然,这绝非终局。当前全球多模态技术路线仍未收敛,窗口期依然敞开。但无论如何,这场竞争已释放出明确信号:在AI的长周期演进中,底层创新的胆识与真实落地的能力,正逐步取代单纯规模优势,成为更稀缺、更关键的核心变量。
不同体量、不同路径的企业同台共舞,终将推动整个产业向更实用、更高效、更契合真实需求的方向演进。我们正身处这场范式革命的序章——而非高潮。在这场浩荡变革中,每家企业都在以自己的方式锚定未来坐标。而智象未来,已然先行一步。
体验入口如下:
HiDream-O1-Image-1.5 :
https://www.php.cn/link/28e335e762e26a85af8789e7264b5a97
https://www.php.cn/link/f2e46b57c887314c461b477fdb838122
开源模型 HiDream-O1-Image:
GitHub:https://www.php.cn/link/ad2e584191559a42c0a3aa6120122a3a
Huggingface:https://www.php.cn/link/2483125d070c795ba1ed28b241c5c737
本文来自微信公众号“机器之心”,36氪经授权发布。














