


内存池通过消除锁争用与系统调用,使小块内存分配稳定在纳秒级;Nginx对≤4KB内存采用无锁bump-pointer分配,耗时2–5纳秒;请求结束时整池重置实现O(1)销毁;大内存走large链表或落盘;chain复用与sendfile进一步压降延迟。
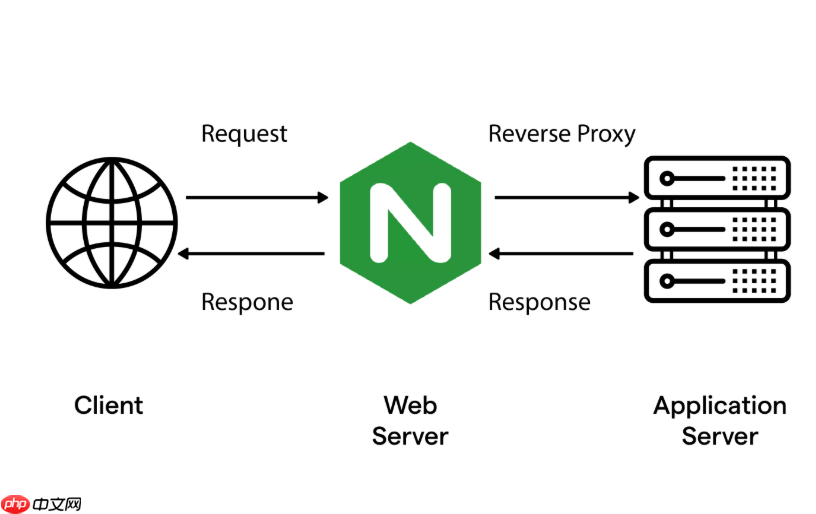
内存池直接决定请求处理的响应延迟和吞吐上限——它不提升单次计算速度,但消除了高并发下 malloc/free 的锁争用、系统调用开销与堆碎片拖累,让每个请求的内存操作稳定在纳秒级。
小块内存分配接近零开销
Nginx 对 ≤4KB 的临时内存(如请求头解析、变量字符串、重写规则缓存)采用 bump-pointer 分配:仅移动 last 指针,无元数据、无对齐检查、无锁。一次分配耗时约 2–5 纳秒,比 glibc malloc 快 100 倍以上。这意味着解析一个典型 HTTP/1.1 请求头(平均占用 1–2KB)几乎不产生可观测延迟。

- 所有 request-level 结构体(
r->headers_in、r->args、r->uri)都从此池分配 - 避免使用
malloc或第三方库隐式分配(如 Lua 的string.gsub),否则会跳出池机制,引入不确定延迟 - 配置
client_header_buffer_size和large_client_header_buffers应贴近实际请求头大小,避免池过早扩容或频繁 fallback
整池销毁替代逐块释放
请求结束时,Nginx 不遍历释放数百个零散 buffer,而是重置 pool 的 last 和 current 指针,并统一回收 large 链表中的大块内存。这个动作是 O(1) 时间复杂度,耗时恒定且极短(通常
- 子请求(subrequest)必须创建独立子池,否则父池销毁会导致子逻辑访问已失效内存
- 定时器回调、upstream connect 回调等异步上下文,须明确使用
cycle->pool或新建短期池,不可复用r->pool - 连接级池(
c->pool)生命周期更长,适合缓存 keepalive 连接的读缓冲区(如recv_buffer),避免每请求重复分配
大内存自动分流,避免池污染
超过 4KB 的内存(如上传 body 缓存、SSL session 数据、proxy buffer)不走线性池,而是调用 malloc 并挂入 pool 的 large 链表。这样既防止大块撑爆主池造成内部碎片,又确保它们在池销毁时被一并 free,不遗漏。
- 启用
client_body_in_file_only on可将超大 body 直接落盘,绕过内存分配 - 反向代理场景中,合理设置
proxy_buffer_size和proxy_buffers,使多数响应 body 复用固定 buffer 池,减少 per-request 大块申请 - 第三方模块若需长期持有数据(如缓存索引),应存于
cycle->pool或共享内存,而非 request 池
缓冲链(chain)复用进一步压降延迟
HTTP body 传输依赖 ngx_chain_t 链表组织 buffer。反复 new/delete chain 节点会触发额外分配。Nginx 提供 ngx_chain_get_free_buf 复用空闲节点,使链表构建从多次分配降为一次指针赋值。
- 静态响应(如 favicon.ico)可预分配 chain + buf,全生命周期复用
- 启用
sendfile on或directio时,内核直接从文件描述符拷贝到 socket,跳过用户态 buffer,彻底消除 chain 分配压力 - 避免在 Lua 脚本中高频构造 table 或 string,改用预分配 buffer +
string.sub拼接,减少 GC 触发导致的隐式堆分配












