


应监控Nginx所有worker进程的CPU和内存总和,并结合stub_status连接数、请求量及响应时间分析业务压力,同时用systemd设MemoryMax、CPUQuota等硬限制防失控。
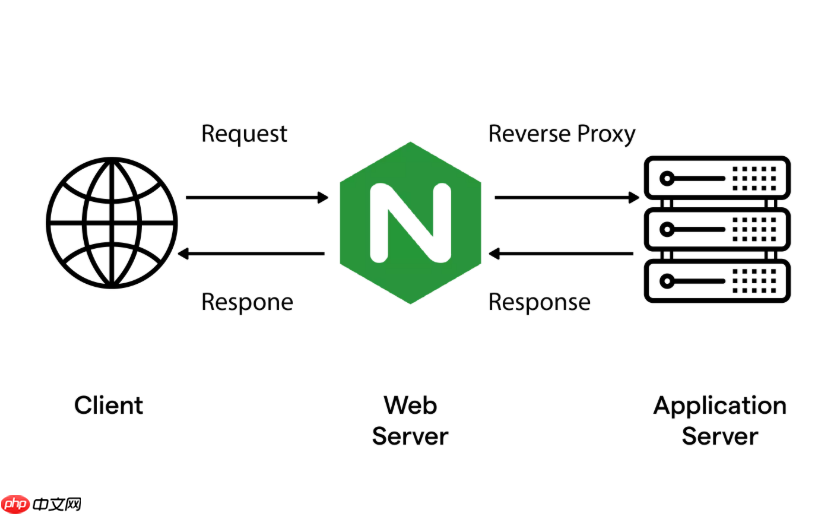
直接看 Nginx 进程本身的实际占用,而不是只盯系统整体指标——因为 Nginx 是多进程模型,主进程轻量、worker 进程才真正干活。监控重点是所有 worker 进程的 CPU 和内存总和,同时结合其连接与请求行为,才能判断是否真有瓶颈。
CPU 占用:聚焦 worker 进程,别被主进程带偏
Nginx 主进程几乎不消耗 CPU,真正干活的是 worker 进程。用以下命令快速定位:
-
实时动态观察:运行
htop,按F4输入nginx过滤,注意区分master(低占用)和多个worker(可能高占用); -
批量统计汇总:执行
ps -C nginx -o pid,comm,%cpu,%mem,rss --no-headers | awk '$2 ~ /worker/ {sum_cpu += $3; sum_mem += $4; sum_rss += $5} END {printf "CPU: %.1f%%, MEM: %.1f%%, RSS: %d KB\n", sum_cpu, sum_mem, sum_rss}',直接输出所有 worker 进程的合计值; -
持续采样记录:用
top -b -n 60 -p $(pgrep -f 'nginx: worker') | grep 'nginx: worker' >> cpu_log.txt每秒抓一次,适合排查瞬时毛刺。
内存占用:关注 RSS 与共享内存,警惕泄漏迹象
Nginx 内存主要分三块:worker 进程私有内存(RSS)、共享内存(如 limit_req_zone、ssl_session_cache)、以及缓存(proxy_cache)。重点关注:

-
RSS 总和:同上条命令中的
sum_rss值,单位 KB。若随时间持续上涨且不回落,可能是配置不当(如open_file_cache过大)或模块内存泄漏; -
共享内存使用:通过
nginx -T 2>/dev/null | grep -E 'limit_conn|limit_req|ssl_session_cache|proxy_cache_path'查看声明大小,再用cat /proc/$(pgrep nginx | head -1)/maps | awk '/nginx.shm/ {sum += $3} END {print sum/1024 " MB"}'估算实际占用; -
对比系统内存压力:运行
free -h和cat /sys/fs/cgroup/system.slice/nginx.service/memory.current(如果用了 systemd 资源限制),确认 Nginx 是否真的触发了内存回收或 OOM。
联动状态模块,把资源占用和业务压力挂上钩
光看 CPU 和内存数字没意义,得知道“它忙什么”。启用 stub_status 后,每秒 curl 一次:
-
curl http://127.0.0.1/nginx_status返回类似Active connections: 1287<br/>server accepts handled requests<br/>123456 123456 2345678
; - 把
Active connections和worker CPU%放在同一张图里(比如用 Grafana),若连接数翻倍而 CPU 只涨 20%,说明效率高;若连接涨 20%、CPU 翻倍,就该查是不是正则匹配太重、日志未缓冲或 SSL 握手开销异常; - 配合
log_format在 access.log 中加入$request_time和$upstream_response_time,再用脚本统计慢请求占比,能快速定位是 CPU 密集型还是 IO 等待型问题。
用 systemd 做硬性兜底,防失控蔓延
即使不依赖外部监控工具,systemd 本身就能约束 Nginx 的资源边界:
- 编辑服务配置:
sudo systemctl edit nginx,写入:
[Service]
MemoryMax=1G
MemoryHigh=768M
CPUQuota=60%
TasksMax=128
- 生效后,用
systemctl show nginx --property=MemoryMax,CPUQuota验证; - 当内存接近
MemoryHigh,内核会主动回收 page cache,不影响服务;超过MemoryMax则直接 kill,避免拖垮整台机器; - 这个配置和 Nginx 自身的
worker_processes和worker_connections必须协同——比如设了TasksMax=128,就别再配worker_processes auto在 64 核机器上起 64 个 worker。










