


stub_status是定位Nginx连接瓶颈的仪表盘,只反映客户端到Nginx的TCP连接状态,通过Active、Reading、Writing、Waiting四类数值比例与趋势判断瓶颈所在环节。
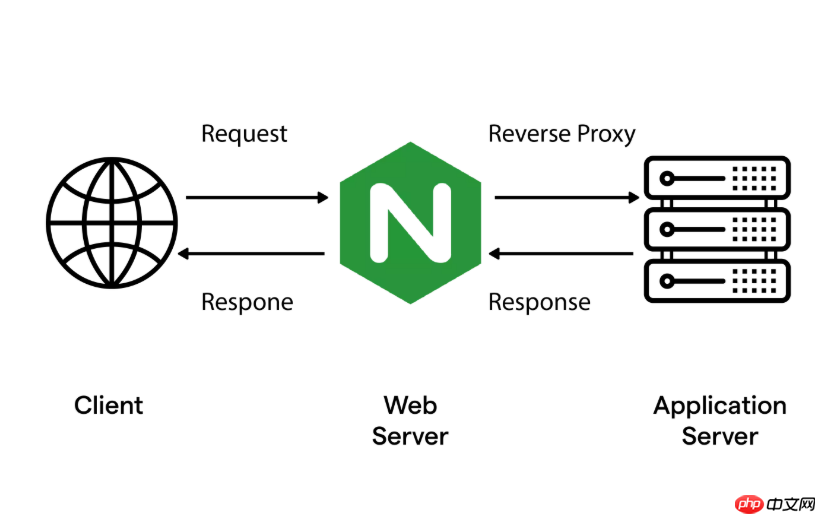
stub_status 不是用来查“哪里慢”的万能探针,而是帮你判断“压力卡在哪一环”的连接状态仪表盘。它不看后端响应时间,也不统计错误码,只忠实反映客户端到 Nginx 这一段 TCP 连接的实时分布。精准定位瓶颈的关键,在于读懂 Active、Reading、Writing、Waiting 四个数字之间的比例关系和变化趋势。
确认模块已启用且接口安全可用
一切监控的前提是接口真实存在且可稳定访问:
- 运行 nginx -V 2>&1 | grep -o with-http_stub_status_module,有输出才说明编译时已包含该模块
- 配置必须写在 server 块内(不能放在 http 或 location 外层),推荐用独立端口隔离,例如 listen 127.0.0.1:8081
- 路径避开 /status 等通用名,用类似 /_nxs 这样的自定义路径,并严格限制 IP(如只允许 Prometheus 采集机或本地运维地址)
- 务必关闭 access_log,避免高频轮询压垮磁盘 I/O
从三行返回值中识别四类瓶颈信号
访问接口得到类似以下纯文本:
Active connections: 142
server accepts handled requests
156890 156890 423156
Reading: 1 Writing: 28 Waiting: 113

重点不是单次数值,而是组合逻辑:
- Reading 持续偏高(如 >5% Active):客户端发包慢、网络延迟大,或存在慢速 HTTP 攻击(如 Slowloris)
- Writing 长期高位且波动小(如 >30% Active):后端响应迟缓、网卡打满、或正传输大文件阻塞 worker
- Waiting 占比异常低(如 :accepts 显著大于 handled,说明 worker 接收了连接但无法及时处理,常见于 worker_connections 设置过小或系统级 file descriptor 耗尽
- Active 连接数持续逼近 worker_connections 上限:连接堆积,需检查是否被恶意扫描、爬虫泛滥,或上游未正确复用连接
用轻量脚本实现趋势化预警
stub_status 输出无结构,但字段位置固定,适合用 shell + curl + awk 快速提取关键值:
- 每 10 秒采集一次,提取 Active、Reading、Writing、Waiting 数值
- 计算各状态占比(如 Writing / Active * 100),当 Writing 占比连续 5 次超过 35% 时触发告警
- 对比 accepts 和 handled 差值,若差值 > 100 并持续 3 分钟,提示连接积压风险
- 将结果写入 Prometheus 文本文件格式(.prom),供 node_exporter 自动采集
结合其他指标交叉验证瓶颈归属
stub_status 只管“连接入口”,要确认问题是否出在 Nginx 自身,还需联动观察:
- 若 Writing 高,同时 PHP-FPM 的 active processes 接近 pm.max_children,说明瓶颈在应用层
- 若 Waiting 低且系统 load average 飙升、CPU idle 极低,可能是 worker 进程被 CPU 密集型任务拖住
- 若 Reading 高,但 tcpdump 抓包显示客户端发包间隔长,大概率是终端网络质量差或攻击行为
- 配合 access_log 统计 499(客户端主动断连)和 504(网关超时)比例,辅助判断是前端甩锅还是后端真慢











