




必须依赖插件或增强方案才能实现后端节点智能监控,核心是主动探测/health接口、语义化判断状态(如200且含"status":"UP")、设置rise/fall阈值,并通过nginx-upstream-check-module、vts模块、OpenResty+Lua或Prometheus闭环实现动态反馈与可视化。
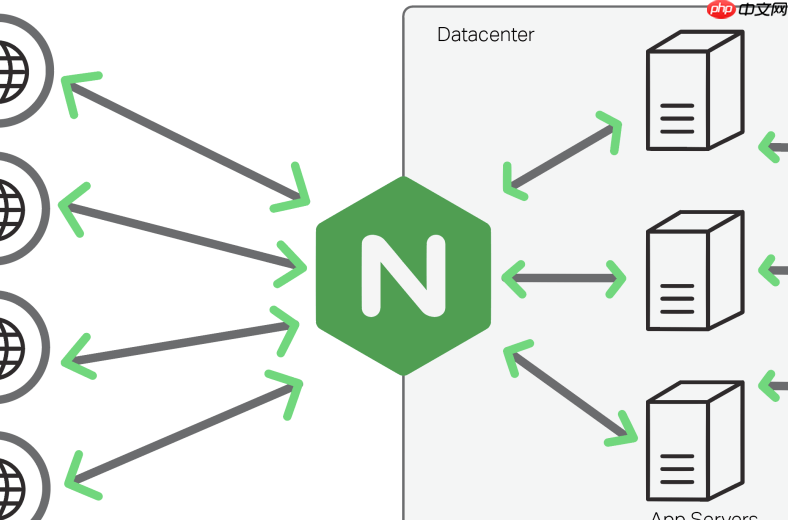
直接用 Nginx 自带模块无法实现后端节点的“智能监控”,必须依赖插件或增强方案。核心目标不是看节点通不通,而是判断它是否真能稳定处理业务请求——这需要主动探测、状态解析和动态反馈闭环。
用 nginx-upstream-check-module 主动探活
这是最常用、最轻量的开源插件,需重新编译 Nginx 或使用已集成该模块的 OpenResty:
- 配置检查路径与语义规则:指定探测 /health 接口,只把返回 200 且响应体含 "status":"UP" 的视为健康(需配合
check_http_expect_alive http_2xx和自定义 Lua 解析) - 设置灵敏度参数:例如
rise=3 fall=5 interval=5 timeout=2,避免因单次 GC 或网络抖动误判 - 失败时自动记录日志:在 error_log 中留下
check failed by http, status: 503等线索,便于后续关联分析
用 nginx-module-vts 可视化集群实时状态
vts(Virtual Host Traffic Status)不参与决策,但提供运维友好的聚合视图:

- 暴露 /status 页面,可直观看到每个 upstream server 的 active、fails、down、response time 和最近一次响应码
- 支持 JSON 格式输出(
/status/format/json),方便 Prometheus 抓取或脚本定时采集 - 结合 Grafana,可绘制“各节点失败率趋势”“平均响应时间热力图”,快速定位异常时段与节点
用 OpenResty + lua-resty-upstream-healthcheck 实现闭环控制
当需要根据监控结果自动干预时,OpenResty 是更灵活的选择:
- 利用
lua-resty-upstream-healthcheck模块,不仅做 HTTP 探测,还能解析 JSON 响应中的 load、memory_usage 等业务指标 - 将健康得分写入
lua_shared_dict,再在access_by_lua_block中按分值动态调整权重或跳过低分节点 - 触发异常时,自动调用 webhook 上报至钉钉/企业微信,或写入 Redis 触发告警工作流
搭配 Prometheus + nginx-lua-prometheus 做指标归一化
单一插件数据难复用,统一接入 Prometheus 才能对齐告警、容量和故障分析体系:
- 通过
log_by_lua_block提取$upstream_addr、$upstream_response_time、$upstream_status,打标后上报为直方图或计数器 - 定义关键 SLO 指标:如
rate(nginx_upstream_errors_total{upstream="api", status=~"5.."}[5m])超阈值即告警 - 与后端服务的 JVM 指标、K8s Pod Ready 状态等横向比对,确认是 Nginx 层问题还是下游真实故障














