


缓存失效策略评估需围绕命中率、回源压力、一致性延迟和资源开销四维度:命中率分整体(HIT/(HIT+MISS+EXPIRED+STALE),理想≥70%)与状态(EXPIRED多说明proxy_cache_valid过短,STALE高则proxy_cache_use_stale过度);回源压力看proxy_pass转发量、后端QPS/响应时间变化及雪崩风险(滑动窗口统计集中失效);一致性延迟关注关键接口更新到全量刷新最长时间、proxy_cache_bypass与purge组合使用、高敏感内容用版本号KEY;资源开销监控磁盘占用(>85%触发频繁淘汰)与keys_zone内存(近上限致KEY冲突);所有评估必须基于真实流量日志分析。
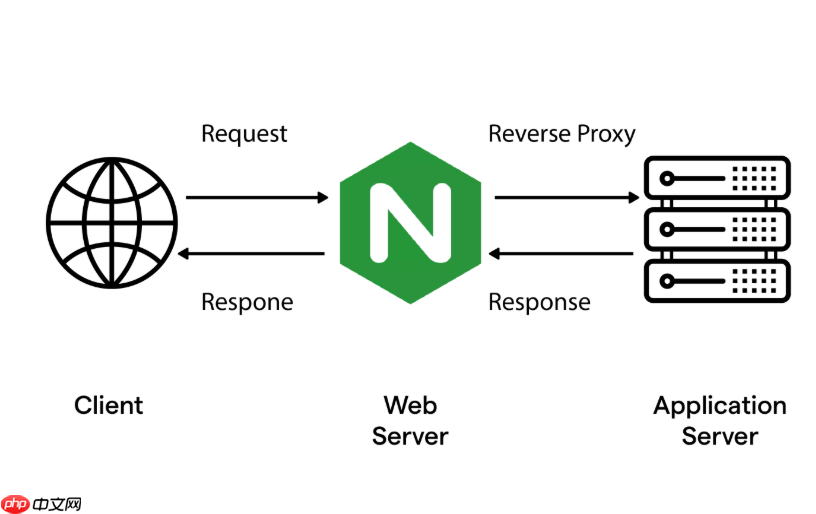
缓存失效策略直接影响Nginx反向代理的响应质量与后端稳定性,性能评估不能只看“是否过期”,而要围绕命中率、回源压力、一致性延迟和资源开销四个维度展开。
缓存命中率是核心观测指标
命中率反映缓存是否真正“用得上”。需区分两种统计:
-
整体命中率:用
$upstream_cache_status日志字段统计 HIT / (HIT + MISS + EXPIRED + STALE) 的比值,理想值应稳定在70%以上(静态资源可超95%,动态接口视业务而定) -
分状态命中率:单独分析 EXPIRED 和 STALE 比例。若 EXPIRED 频发,说明
proxy_cache_valid设置偏短;若 STALE 占比较高,可能proxy_cache_use_stale覆盖了过多异常场景,掩盖了真实问题
回源请求量决定后端负载压力
缓存失效最终体现为对后端的重复请求。评估时重点关注:

- 单位时间内
proxy_pass实际转发请求数(可通过 access_log 中 upstream_addr 字段聚合) - 对比缓存启用前后同一时段的后端 QPS 和平均响应时间变化
- 特别检查缓存雪崩风险:是否大量 KEY 在同一分钟内因
inactive或 TTL 到期集中失效?可通过日志中$request_uri+ 时间戳做滑动窗口统计验证
内容一致性延迟影响用户体验
缓存未及时失效会导致用户看到陈旧数据。评估方法包括:
- 对关键更新接口(如商品价格、公告页),人工触发变更后,记录从更新完成到全量缓存刷新所需的最长时间
- 检查是否合理使用
proxy_cache_bypass(如绕过带特定 cookie 或 header 的请求)与proxy_cache_purge(配合主动清理)组合,缩短强一致性场景下的延迟 - 避免仅依赖被动过期——对高敏感内容,应设计带版本号或时间戳的
proxy_cache_key,让变更天然生成新 KEY
磁盘与内存资源消耗不可忽视
缓存策略越激进,资源占用越高,需平衡性能与成本:
- 监控
/var/cache/nginx(或自定义路径)实际占用与max_size的比值,持续高于85%可能触发频繁淘汰,降低有效命中率 - 观察
keys_zone内存使用(通过nginx -s stats或stub_status模块),若接近 10m 配置上限,KEY 冲突上升,会导致误失效或覆盖 -
inactive=60m不代表“60分钟必删”,而是“60分钟未被访问才删”。高频但长尾的请求容易堆积无效缓存,建议结合业务访问热图调整该值
不复杂但容易忽略:所有评估必须基于真实流量日志,而非压测模拟。线上开启 log_format 包含 $upstream_cache_status $request_time $upstream_response_time,再用 ELK 或 Prometheus+Grafana 做趋势分析,才能看清策略的真实效果。












