


核心是用 $request_id 全链路透传并关联日志:Nginx 生成并记录 $request_id,通过 X-Request-ID 头透传至下游;各层服务需读取、复用并继续传递该 ID;借助日志平台按 request_id 聚合检索全链路日志,缺失时以时间戳辅助定位。
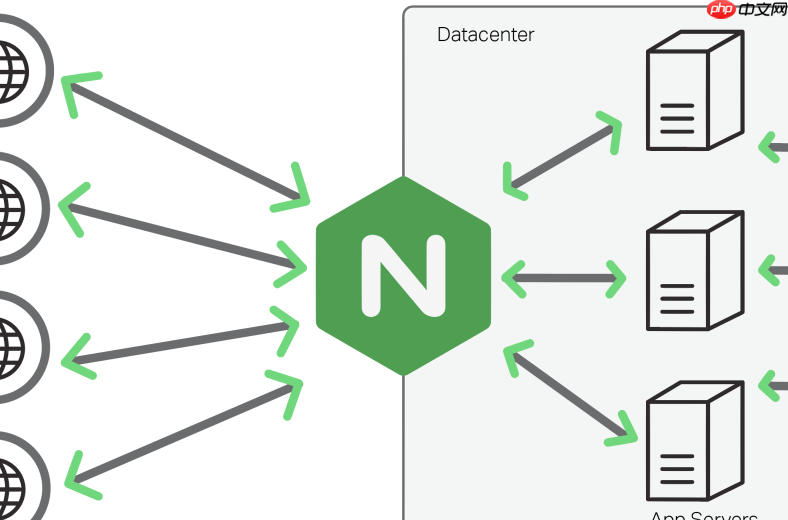
要追踪用户一次请求的完整访问路径,核心不是拼凑零散日志,而是用一个贯穿全程的唯一标识把所有环节串起来。最直接有效的方式,就是利用 $request_id 实现全链路对齐。
确保 $request_id 从入口开始就存在并透传
这个 ID 必须在 Nginx 接收请求时生成,并写入 access_log;同时通过 X-Request-ID 请求头原样传递给后端服务。Nginx 默认支持 $request_id 变量(需启用 ngx_http_core_module),但必须显式配置:
- 在 log_format 中包含 $request_id,例如:
log_format main '$request_id - $remote_addr ...'; - 在 server 或 location 块中启用该格式:
access_log /var/log/nginx/access.log main; - 确认下游服务(网关、API 服务、中间件)都从 X-Request-ID 头读取该值,并在自身日志和调用下游时继续透传,不生成新 ID
- 用 curl 或浏览器开发者工具检查响应头,确认返回的 X-Request-ID 与 access.log 中对应行的 $request_id 完全一致
在各层日志中并行检索同一 request_id
拿到用户投诉对应的 $request_id 后,不要只看某一个服务的日志。应在所有相关组件中同步搜索:

- Nginx access/error log:确认请求是否到达、状态码、耗时、客户端 IP、上游地址
- 网关层(如 Kong、Spring Cloud Gateway):查路由匹配、鉴权失败、限流拦截等拦截点
- 业务服务日志:定位参数解析异常、DB 查询超时、第三方接口错误等具体逻辑问题
- 中间件日志(Redis、MySQL 慢日志、MQ):结合时间戳 + request_id 关联上下文(部分需自定义埋点)
借助日志平台提升关联效率
手动 grep 多个文件效率低且易遗漏。推荐使用 ELK、Loki 或阿里云 SLS 等平台:
- 将 $request_id 设为结构化字段(如 Loki 的 label 或 ES 的 keyword 类型)
- 在 Kibana 或 Loki Explore 中输入
{job="nginx"} |~ "abc123",再叠加{job="api-service"}切换查看 - 可配置告警规则:当同一 request_id 在多个服务中连续出现 ERROR 日志,自动聚合推送
- 若系统已用 OpenTelemetry trace_id,建议让 $request_id 与 trace_id 相同或建立映射,避免两套 ID 增加理解成本
应对日志缺失环节的补救方法
老服务未接入、异步任务、定时脚本或 DB 层可能没打 request_id。这时以时间为锚点辅助定位:
- 记下该 request_id 在 Nginx 日志中出现的精确时间(如
2024-06-15T14:23:08.123+08:00) - 在缺失日志的服务中,按秒级范围搜索前后 3–5 秒内的日志
- 重点检查异步消费逻辑:比如下单后发 MQ,消费者是否丢失了 request_id 的传递










