





近日,腾讯混元团队携手中国人民大学高瓴人工智能学院等多家科研单位,联合发布并开源了 planningbench。该框架是一个面向大语言模型规划能力评估与训练的、具备可扩展性与可验证性的数据生成平台。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
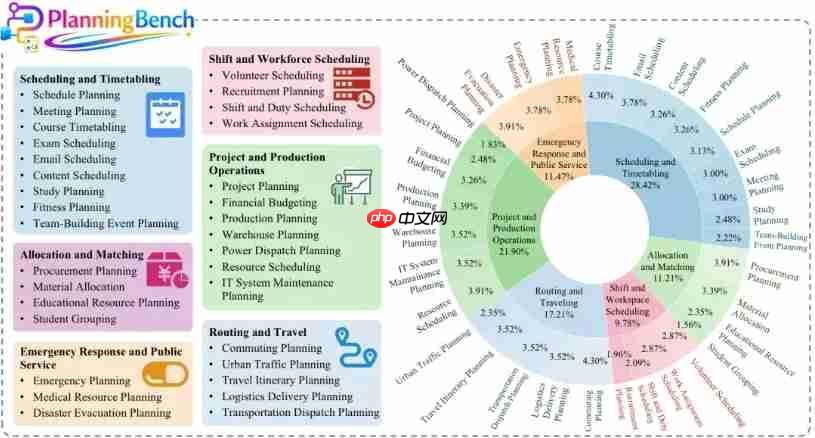
PlanningBench 紧密围绕现实中的规划需求展开设计,系统性地提炼出任务类型、约束条件及复杂度等多个核心维度,构建起覆盖逾 30 类规划任务的数据生成与验证体系。该框架不仅能科学衡量模型是否真正具备规划推理能力,还能为其规划能力的持续训练提供稳定、鲁棒且具备跨任务迁移价值的奖励反馈机制。
在任务覆盖范围上,PlanningBench 涵盖日程安排、资源调配、人员排班、路径规划、生产调度以及应急响应等六大典型应用场景。如此多元化的任务结构,有效防止模型陷入单一领域“应试式学习”的局限,从而推动其在真实世界复杂问题中展现出更强的泛化与适应能力。
值得一提的是,PlanningBench 的难度调控机制并非依赖于简单延长输入提示,而是通过对任务结构分解、约束层级嵌套、资源稀缺程度等关键因素进行精细化建模,实现对真实瓶颈环节的靶向生成。每条生成样本均附带结构化 checklist,用于严格校验模型输出是否满足原始输入要求、是否遵守各类资源限制、以及是否达成最优目标。
尤为关键的是,该框架采用兼顾局部合理性与全局可行性的双重评估视角,能够精准识别出“局部看似合规、整体却无法落地执行”的伪合理计划。这一特性对于深入剖析大语言模型在强约束、多目标场景下的真实规划水平具有不可替代的价值。
实证表明,借助 PlanningBench 提供的可验证数据开展训练后,模型在未参与训练的新规划基准测试及通用推理任务中均取得显著性能提升,印证了其所提供学习信号的高度通用性与泛化潜力。总体而言,PlanningBench 构建了一个以真实场景为牵引、涵盖数据生成—能力评测—模型训练—效果迁移的完整闭环体系,为下一代人工智能规划能力的研究与实践开辟了全新路径。













