


共享内存块本身同步正常,问题在于未正确配置原子操作或保护机制;必须在http块顶层唯一声明shared缓存、禁用none/off、对统计变量加锁,并按QPS×超时×0.5KB公式扩容。
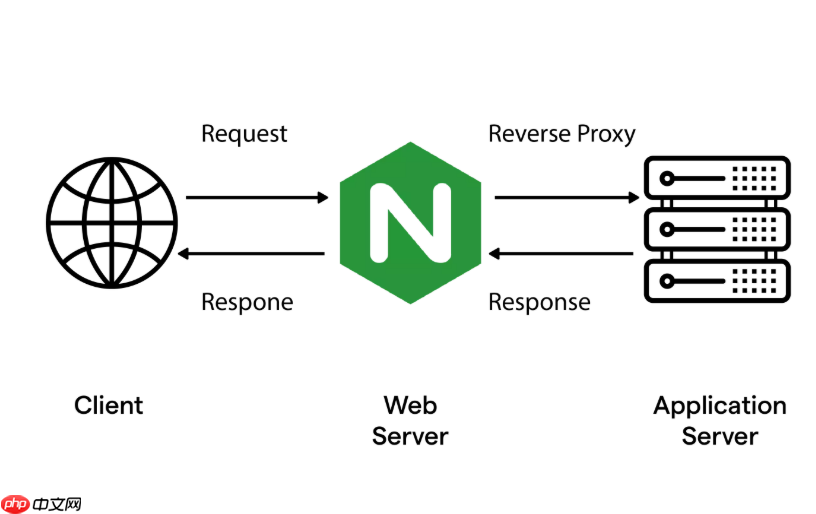
共享内存块本身不“不同步”,问题出在没用对机制或没配好保护。多进程间缓存状态统计失准,90%以上是因缺少原子操作保障,而非共享内存失效。
必须启用 shared 类型并统一声明
Nginx、Redis 模块或自研服务中,若只在多个 server 块里各自写 ssl_session_cache builtin:10m 或重复定义 shared:SSL:10m,系统会尝试合并但参数冲突时行为不可控。正确做法是:
- 把
ssl_session_cache shared:SSL:50m(或其他名称)严格写在http块顶层,且仅出现一次 - 确保所有 worker 进程都通过同一 shm 区域读写,master 进程启动时已分配并 mmap 映射
- 禁用
none或off,避免退化为各进程私有缓存
缓存条目不是问题,统计变量才是关键风险点
共享内存里存会话数据是安全的,但如果你额外维护一个全局计数器(比如 total_handshakes 或 reused_count),它极大概率被多个 worker 同时修改而丢失更新。例如:
- C 语言中直接
counter++是“读-改-写”三步,非原子 - Python 中用
multiprocessing.Value时未加.get_lock(),结果累加值远小于预期 - 解决方案:所有统计变量必须配合同步原语——POSIX 信号量、命名互斥锁或
Value自带锁
验证是否真生效,别信日志信行为
缓存命中不会打日志,$ssl_session_reused 变量才是金标准:
- 值为
.(英文点)→ 成功复用已有会话 - 值为
0或空 → 新建会话,此时要排查客户端兼容性或中间设备干扰 - 用
openssl s_client -connect host:443 -reconnect -no_ticket连续请求,看输出是否稳定出现Reused, SSL handshake has read 0 bytes
容量不足比同步问题更常见
看似“不同步”,实则是缓存满后新会话挤掉旧条目,导致复用率暴跌。按公式粗算所需大小:
每秒新建会话数 × 平均存活秒数 × 0.5KB ≈ 所需字节数
- 例:2000 QPS、session_timeout 设为 10 分钟(600 秒)→ 2000 × 600 × 512 ≈ 614MB
- 默认 10m 完全不够,建议起步设为
50m,再根据ssl_session_cache_size监控指标逐步调优











