





要让 proxy_next_upstream 优雅处理 503,需对齐错误识别、重试控制、节点规避和业务安全:显式配置 http_503;避免混入 404/403;慎用 500;设 tries≤3、timeout≈8s;配 max_fails=3/fail_timeout=30s 做健康检查;GET/HEAD 可重试,POST/PUT/DELETE 需后端幂等支持。
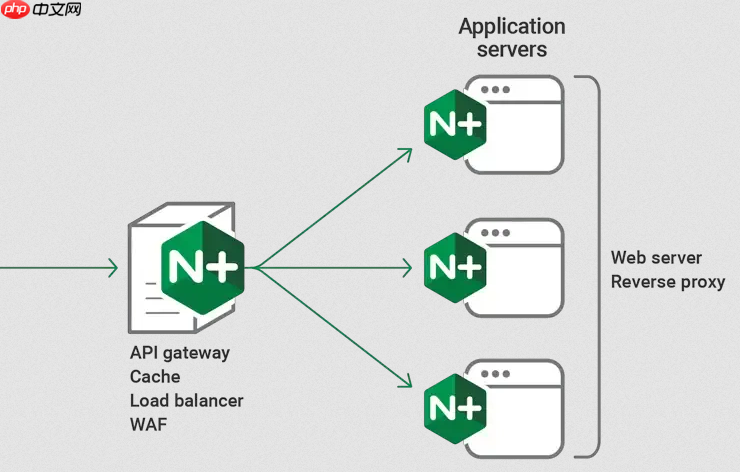
要让 proxy_next_upstream 真正优雅处理后端偶发的 503,关键不是简单加个 http_503,而是把错误识别、重试控制、节点规避和业务安全四者对齐。
只对真正“可恢复”的503重试
503 Service Unavailable 多数源于瞬时过载、熔断或依赖服务不可用,这类问题换节点大概率能成功。但需注意:
- 必须显式写入:
proxy_next_upstream ... http_503—— 默认不包含,不加就不会触发 - 避免混入
http_404或http_403:它们是确定性业务结果,重试只会放大无效流量 - 慎加
http_500:若 500 来自数据库死锁或代码异常,换节点通常无效,应快速失败而非重试
用 tries 和 timeout 把重试“框住”
无约束的重试会让延迟翻倍甚至引发雪崩。两个参数必须协同设置:

FastAPI Flask Proxy
下载
FastAPI + Flask 混合部署最佳实践,解决路由定义、API 代理等常见问题,适用于同时运行 FastAPI API 与 Flask 前端的场景。
-
proxy_next_upstream_tries 3:最多尝试 3 个不同节点(含首次),设为 3 是较稳妥的生产值;若 upstream 只有 2 台主节点,该值不宜超过 2 -
proxy_next_upstream_timeout 8s:从第一次请求发出开始计时,总耗时超 8 秒就终止并返回错误;它应略大于单次proxy_read_timeout(如设为 5s),但不能过大——否则用户可能等满 15 秒才看到失败
靠被动健康检查让“失败”变成“规避”
仅靠重试无法解决根本问题。若不配健康检查,Nginx 仍会轮询到刚返回 503 的节点,导致每次请求都先失败再重试:
- 在
upstream块中为每个节点加上:max_fails=3 fail_timeout=30s - 这样连续 3 次因 503(或其他配置的错误)触发重试后,该节点会被自动剔除 30 秒,期间不参与任何调度
- 可选加
backup节点:仅当所有主节点都被标记为不可用时启用,适合部署降级服务或灾备实例
区分请求方法,守住幂等性底线
503 重试是否安全,取决于请求本身是否可重复执行:
- GET / HEAD 请求天然幂等,可放心开启
http_503重试 - POST / PUT / DELETE 等非幂等请求默认不重试;若业务确需重试(如订单创建),后端必须实现幂等控制(如基于 request_id 去重),且 Nginx 需启用
proxy_request_buffering off(Nginx ≥ 1.7.11) - 不建议为写操作盲目开启重试,重复扣款、重复下单等风险远高于可用性收益











