


大模型所表现出的“幻觉”——即以高度确信的语气输出明显违背事实的内容——始终是ai领域难以绕开的关键挑战,尤其在医疗、司法等容错率极低的垂直场景中,此类错误可能带来严重后果。
过去,行业主要依赖两种策略应对幻觉:其一,持续扩充训练语料,寄望于让模型覆盖更广的知识边界;其二,部署保守型响应机制,要求模型在置信度不足时主动拒答。但二者均存在根本性瓶颈:前者受限于数据获取与标注的现实约束,注定无法填满所有知识空洞;后者则常引发“可用性折损”——为规避少量错误,模型频繁回避本可正确作答的问题,显著削弱交互效率与用户信任。
近日,谷歌研究院携手特拉维夫大学发布一项突破性研究,提出一条迥异于传统范式的解决路径:引入元认知能力(Metacognition)。该工作指出,遏制幻觉的本质,并非苛求模型永不失误,而在于赋予其“自知之明”——即清晰识别自身认知边界,并据此调整表达方式。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
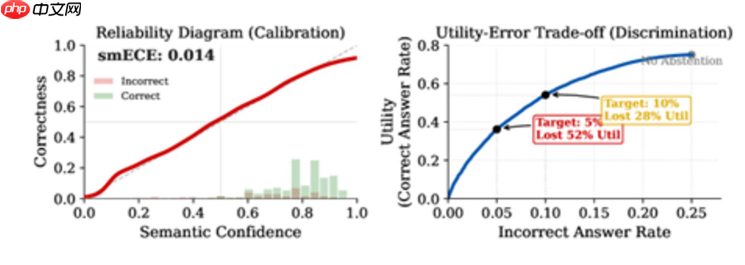
图:校准性(Calibration)与判别力(Discrimination)的差异。左图呈现理想校准状态(红色曲线紧贴对角线),右图则揭示一个尖锐矛盾:即便校准已达最优,若想将错误率从25%压缩至5%,将不得不舍弃52%原本可正确回应的查询。
研究团队对“幻觉”作出重新界定:问题症结不单在于答案错误,更在于模型在缺乏足够依据时,仍以不容置疑的口吻传递误导性信息。因此,真正关键的能力是“忠实于不确定性”——当内部推理过程呈现模糊、冲突或低置信度信号时,其最终输出应同步体现审慎、保留甚至存疑的语义特征,而非强行包装为确定结论。

所谓元认知,即模型对其自身推理状态的感知与反思能力。它要求大模型不仅能实时监测内部激活模式、注意力分布、token概率熵值等隐含信号,更能将这些信号转化为对外表达中可被用户感知的语义强度调节。在AI智能体(Agent)架构日益普及的当下,这一能力愈发不可或缺。一个缺失元认知的AI系统,犹如驾驶舱仪表失灵的飞行员:既无法判断何时该调用外部工具或检索模块,也难以评估检索结果的可信层级,极易陷入工具误用乃至“无导航飞行”的失控风险。
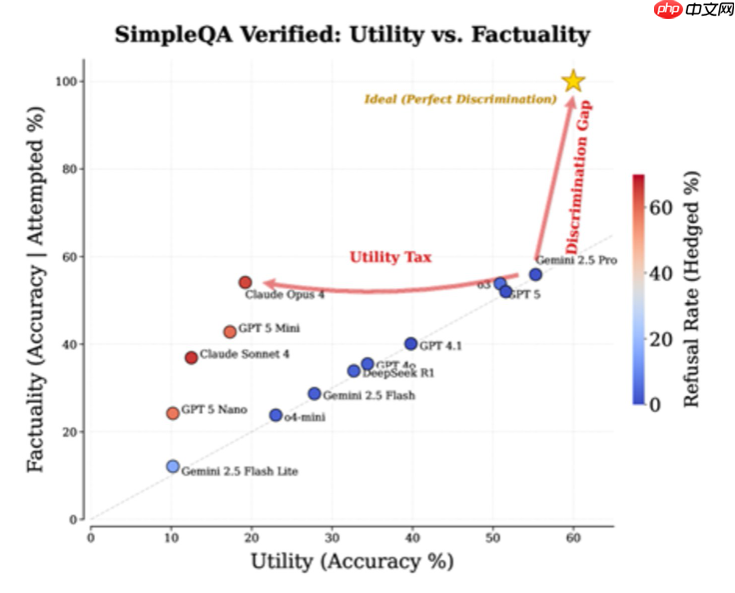
图:主流大模型在SimpleQA Verified基准上的实测对比。“★”标示理论最优解位置,“Discrimination Gap”量化当前模型与理想判别能力之间的落差,“Utility Tax”则直观呈现Claude Opus4为换取高准确率所牺牲的响应覆盖率。
当然,通向元认知之路并非坦途。技术难点包括:如何甄别模型是真实具备不确定性感知,还是仅在模仿人类偏好的“表演式迟疑”;以及如何规避RLHF(基于人类反馈的强化学习)带来的反向激励——由于多数用户天然倾向肯定、果断的回答,该机制反而可能助推模型习得“伪装自信”的策略。
面向未来,该研究呼吁建立更科学的评估框架:衡量反幻觉能力不应再拘泥于单一准确率指标,而应绘制“实用性-错误率权衡曲线”,综合考察模型在不同置信阈值下的响应广度与质量稳定性。AI无需成为零瑕疵的神谕,但它必须拥有专业从业者最基础的职业自觉:能坦然区分“我确信”与“我推测”。唯有对自身知识疆域保持清醒的自我意识,才是构建可信、可用、可托付AI系统的根本支点。














