


核心是让weight真实反映每台机器稳态承载能力,需按CPU核数、内存、IO及实测QPS设定初始权重,并通过CPU使用率、P95响应时间等监控信号动态调权,配合max_fails、slow_start、keepalive等参数协同优化。
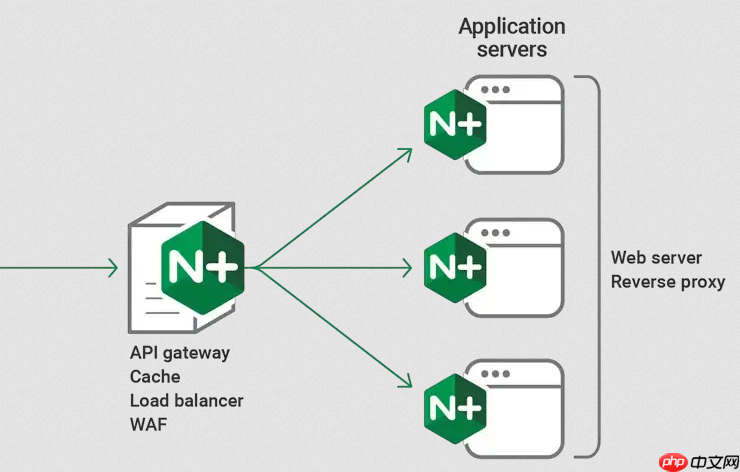
调优 weight 参数实现异构服务器集群的算力精准配比,核心不是“设个数”,而是让权重真实反映每台机器此刻能稳稳扛住多少请求——它得跟着硬件能力走,也得跟着实时负载变。
按硬件指标定初始权重
权重起点必须可量化、可对齐。不能凭感觉,要抓关键瓶颈维度:
- CPU 核数是基础:16 核 → weight=4,8 核 → weight=2,4 核 → weight=1(保持整数比,方便后续调整)
- 内存容量若成瓶颈(如 Java 应用堆大),64GB 对 16GB 可按 4:1 比例设权
- IO 能力差异明显时加权:NVMe 机器比 SATA SSD 延迟低 40%,可在原权重基础上 +0.5~1(如从 4 调到 4.5)
- 实测 QPS 更可靠:压测得出 A 机稳态 1200 QPS、B 机 400 QPS,直接按 3:1 设 weight(如 9 和 3),留 20% 余量防波动
用动态反馈防权重失准
静态 weight 会过期。一台 weight=5 的机器 CPU 持续超 85%,它实际吞吐已断崖下跌,但流量还在猛灌——这就需要闭环调节:

- 监控信号选真正卡点:CPU 使用率、P95 响应时间、5xx 错误率、连接排队长度(iowait 单独采,磁盘忙时不能只看 CPU)
- 自动降权策略示例:某节点 CPU > 80% 持续 2 分钟,weight 临时砍半;恢复至 60% 并稳定 5 分钟后,再逐步回填
- Nginx 原生不支持运行时改 weight,需配合 nginx-upstream-check-module 或外部控制器(如 Consul Template + reload)落地
验证是否真配准了
别信配置文件,要看后端真实水位:
- 查 Nginx 实际分发比例:用 nginx-exporter + Prometheus 抓取各 upstream server 的 requests 计数,算出 RPS 实际占比 —— 若 weight=4/2/1,RPS 应接近 4:2:1
- 交叉验证响应质量:高权重点平均响应时间若显著高于低权重点,说明它已隐性过载,权重设高了
- 观察错误率和延迟拐点:某台旧机 P95 RT 突然从 120ms 拉到 450ms,即使 CPU 还不到 70%,也该主动降权
配合其他参数协同发力
weight 单打独斗效果有限,必须组合使用:
- 加 max_fails=2 fail_timeout=30s,避免故障节点持续吸流
- 新节点上线必配 slow_start=60s,防止冷启动瞬间压垮
- 高配机建议启用 upstream keepalive 32,提升连接复用率,放大其并发优势
- weight=0 是运维杠杆:灰度发布时先给新服务 weight=1,老服务 weight=10;验证稳定后再阶梯上调













