





要让负载均衡器真正感知TTFB并动态分流,必须依赖后端主动上报的P90/P95 TTFB值(如通过/health/ttfb接口或Prometheus),而非NGINX的upstream_response_time或原生least_time;NGINX需用Lua模块动态调整weight,HAProxy则通过Runtime API结合Prometheus实现;须禁用CDN缓存X-TTFB头、关闭proxy_buffering以防测量失真,并为新节点设初始权重避免冷启动误判。
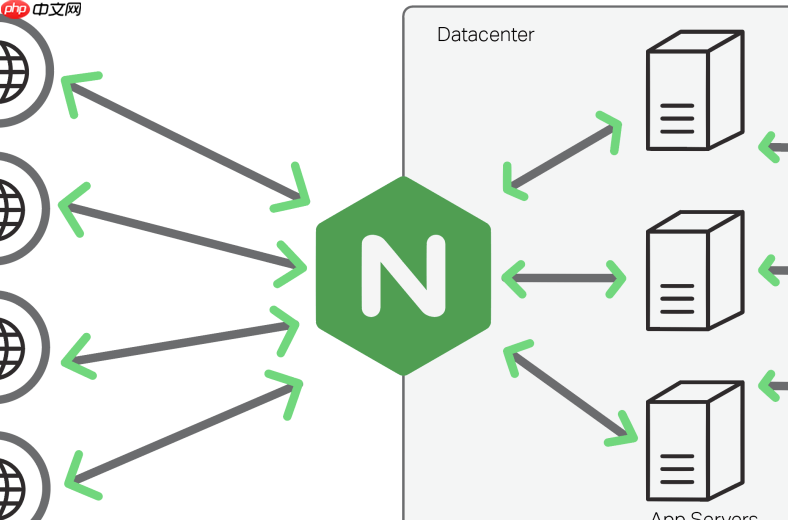
要让负载均衡器真正“感知”首字节延迟(TTFB),并据此动态分流,不能只靠传统 least_time 的简单实现——它必须与后端服务的实时 TTFB 上报机制深度耦合,否则就是纸上谈兵。
核心前提:后端主动上报真实 TTFB
NGINX 或 HAProxy 自身无法准确测量用户侧的 TTFB(受客户端网络、DNS、TLS 等影响)。真正可信赖的 TTFB 必须由应用层埋点采集,并通过轻量通道回传给负载均衡器。常见做法:
- 在 FastAPI / Django 等框架响应头中注入自定义字段,如
X-TTFB: 87(单位毫秒),该值由responseStart - fetchStart在服务端精确计算(利用request.state.start_time+ ASGI 生命周期钩子) - 后端启动独立健康探针服务(如
/health/ttfb),每 5 秒返回当前实例近 1 分钟滑动窗口的 P90 TTFB 值,格式为 JSON:{"ttfb_p90": 92.4, "uptime": 12480} - 禁止依赖
upstream_response_time变量——它测的是从反向代理发请求到收到第一个字节的时间,不包含客户端网络耗时,无法反映真实用户体验
NGINX 配置:启用 least_time + 动态权重更新
NGINX 官方 least_time 仅支持 last_byte 和 first_byte 两种模式,但它的 first_byte 实际测量的是 upstream 连接建立+首包返回时间,仍非用户侧 TTFB。因此需绕过原生逻辑,改用 least_conn + weight 动态调整组合:

- 启用
upstream_hash或sticky保证会话亲和,避免单次对话被切到不同节点导致上下文丢失 - 用
lua-resty-upstream-healthcheck模块定期调用各节点的/health/ttfb接口,解析 JSON 并按公式重算权重:weight = max(1, floor(200 / ttbf_p90))(即 TTFB 越低,权重越高,最大权重设为 200) - 配合
ip_hash或hash $remote_addr consistent;避免权重突变引发连接抖动
HAProxy 进阶方案:基于 Prometheus + API 实时调度
HAProxy 2.6+ 支持通过 Runtime API 动态修改服务器权重,配合外部指标系统可实现更精细的 TTFB 感知分流:
- 所有后端服务将 TTFB 指标(
http_server_ttfb_seconds_bucket{le="0.2"}等)上报至统一 Prometheus - 部署一个轻量 Python 服务,定时查询 Prometheus 获取各实例近 2 分钟的 TTFB P95 值,并调用 HAProxy Runtime API 更新权重:
set server be_ai/streaming/srv-01 weight 150 - 在 HAProxy 配置中启用
balance leastconn作为兜底策略,同时开启option httpchk GET /health保障基础可用性
关键避坑点
很多团队卡在“明明配置了 least_time 却没效果”,问题往往出在链路断点上:
-
Cloudflare / CDN 层拦截了 TTFB 上报:确保自定义响应头(如
X-TTFB)未被 CDN 缓存或剥离;若用 SSE 流式接口,需关闭 Cloudflare 的“Always Online”和“Rocket Loader” -
反向代理缓冲干扰流式首字节:Nginx 必须设置
proxy_buffering off; proxy_cache off; proxy_http_version 1.1;,否则 TTFB 测量值完全失真 - TTFB 数据冷热不均:新上线节点无历史数据,易被误判为“最优”。建议初始权重设为 50,待采集满 60 秒有效样本后再参与调度











