





秒级灾备切换需整套容灾控制链:健康探测设max_fails=1/fail_timeout=2s,重试仅1次且总超时1.5s,连接层启用keepalive复用并收紧超时,兜底配置error_page指向独立降级服务。
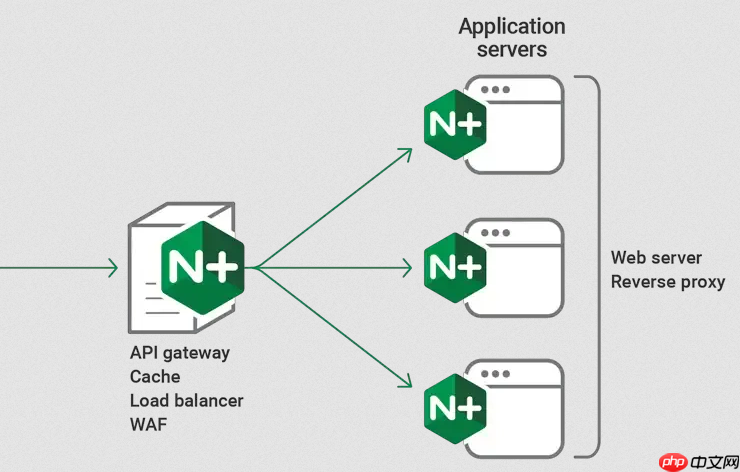
仅靠 upstream 里加个 backup 标记,无法实现秒级灾备切换。真正起作用的是围绕 backup 节点构建的一整套激进、精准、协同的容灾控制链——健康探测要快、重试要稳、连接要省、兜底要牢。
健康探测必须“零容忍”:max_fails=1 & fail_timeout=2s
默认配置(如 max_fails=3 fail_timeout=30s)在高压下形同虚设:节点已开始超时或返回 503,Nginx 却还在持续发请求,backup 始终不激活。
- 主节点和 backup 节点都应统一设置
max_fails=1 fail_timeout=2s - 只要一次失败(连接超时、502/503/504),立即标记为 down
- 2 秒后自动试探恢复,避免永久摘除误判
- 该配置直击电商大促中“毫秒级抖动”的本质,把故障感知压缩到秒内
重试策略必须“只试一次”:tries=1 & timeout=1.5s
盲目重试是高压下的放大器:一次重试可能拖慢 300ms+,引发长尾、级联超时甚至雪崩。
- 开启安全重试:
proxy_next_upstream error timeout http_502 http_503 http_504(慎加 500,除非业务幂等) - 严格限定重试次数:
proxy_next_upstream_tries 1(含首请求共最多 2 次) - 全局封顶耗时:
proxy_next_upstream_timeout 1.5s,超时即放弃,不卡住请求 - 这样既保障了单次失败的容错性,又杜绝了重试引发的延迟恶化
连接层必须复用:keepalive + HTTP/1.1 + 精准超时
短连接下 TCP 握手失败易被误判为服务故障;长连接复用才能真实反映后端健康状态,加速故障暴露。
- upstream 中启用连接池:
keepalive 64 - location 中复用连接:
proxy_http_version 1.1; proxy_set_header Connection ''; - 调低传输超时:
proxy_connect_timeout 500ms; proxy_send_timeout 1s; proxy_read_timeout 1s(按业务 SLA 微调) - 建连与读写超时大幅收窄,配合激进健康检查,形成“快探-快切-快传”闭环
兜底不能只靠 backup:error_page + 独立 fallback location
当所有 upstream(含 backup)均不可达,或 backup 自身也抖动时,仅依赖 backup 会直接返回 502,用户侧体验断崖式下跌。
- 必须配置
error_page 502 503 504 /fallback - 定义独立的
location /fallback,指向降级服务(如静态页、缓存兜底、轻量熔断接口) - 该 fallback 可进一步对接 Apollo 配置中心,实现降级策略热更新(如 AB 测试开关、只读模式切换)
- 这是压舱石级设计,确保“切不动”时仍有确定性响应,守住用户体验底线










