


Nginx upstream负载均衡算法不控制worker间分发,真正影响分布的是事件模型、连接机制与upstream配置协同;优化核心是避免单worker瓶颈,需独立维护连接池、合理启用keepalive、开启accept_mutex或reuseport、选用无状态算法(如轮询/least_conn)、限制worker_connections并监控连接分布。
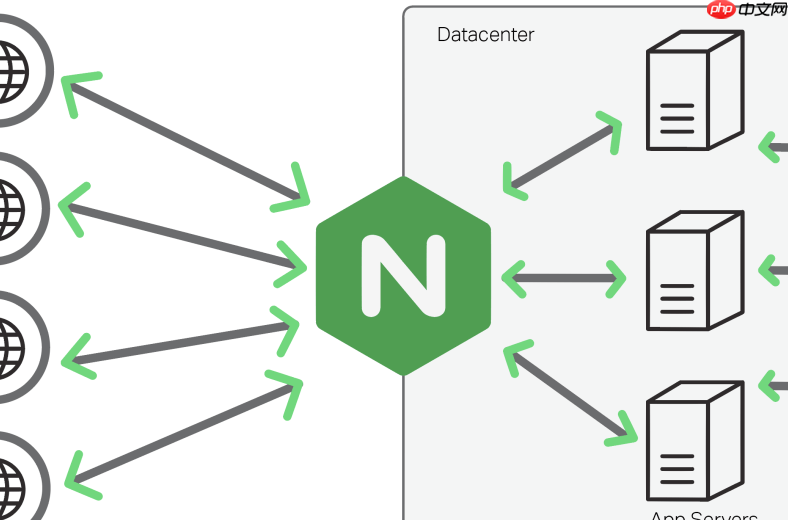
确保每个 Worker 独立维护 upstream 连接池
默认情况下,Nginx 各 worker 进程各自维护独立的 upstream 连接缓存(如 keepalive 连接),这是合理的设计。但若配置不当,容易导致连接集中在少数 worker 上:
- 必须显式启用 keepalive 并设合理值(如
keepalive 200;),否则每个请求都新建 TCP 连接,大量短连接会加剧 worker 调度不均和 TIME_WAIT 压力; - 配合设置
proxy_http_version 1.1;和proxy_set_header Connection "";,确保复用长连接; - 避免全局共享连接池——Nginx 原生不支持跨 worker 共享 upstream 连接,强行共享反而引发锁竞争,降低并发性能。
启用 accept_mutex 与多路复用平衡连接接入
Worker 间初始请求分布不均,常源于新连接被某个 worker “抢走”过多。这由 accept 机制决定:

- 开启
accept_mutex on;(默认已启用)可防止“惊群”,让 worker 轮流获取新连接; - 使用
epoll(Linux)或kqueue(BSD)等高效事件模型,提升单 worker 处理能力,间接缓解负载倾斜; - 若使用
reuseport(需 Linux 3.9+ 且编译时启用),可在内核层将新连接哈希分发到不同 worker,比 accept_mutex 更彻底——在 http 块外添加:events { use epoll; multi_accept on; },并在启动命令中加-g "worker_processes auto; worker_cpu_affinity auto;"配合 CPU 绑定效果更佳。
选择适合的 upstream 调度算法,减少状态依赖
某些算法会隐式引入“亲和性”,放大 worker 差异的影响:
- 轮询(round-robin)和 least_conn 是无状态的,各 worker 独立计算,天然利于均匀分布;
-
ip_hash 在单机部署下,所有 worker 计算结果一致,但若上游有 LVS 或 CDN,真实客户端 IP 可能被覆盖,导致 hash 结果失真,反而集中请求;建议搭配
$http_x_forwarded_for或$binary_remote_addr提升一致性; - hash $request_uri 同理,URL 分布不均(如首页访问远多于详情页)会直接导致后端节点冷热不均,进而让部分 worker 因频繁 fallback 而过载。
限制单 worker 连接数并监控实际分布
防止单个 worker 过载是最直接的兜底手段:
- 通过
worker_connections 4096;控制每个 worker 最大并发连接数,结合events { use epoll; }提升效率; - 在 upstream 中为 server 设置
max_fails=3 fail_timeout=30s,及时剔除故障节点,避免 worker 持续重试失败连接; - 利用
stub_status或 OpenResty 的nginx-module-vts实时查看各 worker 的 active connection 数、request 数,验证是否均匀;异常偏高说明存在连接复用不足或后端响应慢拖累 worker。











