








Nginx backup配置是主集群全线宕机时维持核心链路可用的底线保障,需满足功能裁剪、资源隔离、路径可控三前提,并配合健康检查、本地缓存、静态化页及监控演练。
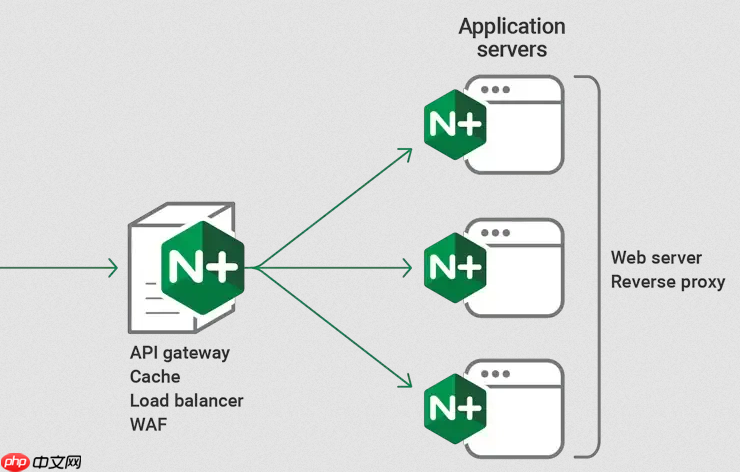
当秒杀流量突破主集群承载极限,或突发节点大规模故障时,backup备用配置不是“备选方案”,而是系统不崩溃的底线保障。它不追求日常性能,而专注在极端压力下维持核心链路可用——比如允许用户能刷新页面、看到“库存已抢完”提示,而不是直接502或白屏。
backup配置的本质是降级通道,不是简单复制主集群
直接镜像主服务节点做backup,往往起不到作用。真正有效的backup配置需满足三个前提:
- 功能裁剪:只保留最简交互能力,例如关闭下单、支付等写操作,仅开放商品详情页、倒计时、结果通知等只读接口;
- 资源隔离:使用独立的轻量级实例(如t5系列低配云主机或容器组),避免与主集群争抢CPU、带宽、Redis连接池等共用资源;
- 路径可控:通过Nginx或LVS的backup指令显式声明,而非靠健康检查被动剔除后才启用,确保切换时机可预期、可测试。
在Nginx中启用backup的真实配置逻辑
Nginx的backup参数不是“备用开关”,而是“兜底路由开关”。它只在所有非backup节点全部失败(或主动标记为unavailable)时才生效。典型配置如下:
upstream seckill_backend {
    server 192.168.1.10:8080 weight=5;
    server 192.168.1.11:8080 weight=5;
    server 192.168.1.12:8080 backup;  # 仅当前两台全不可用时才启用
}
注意两点关键细节:
- backup节点不参与常规轮询,即使它健康、空闲,也不会分到任何正常流量;
- 若希望它在主节点过载(而非宕机)时也介入,需配合max_fails和fail_timeout调低健康检查阈值,或用OpenResty+Lua实现基于RT(响应时间)的动态权重切换。
backup节点必须自带缓存与静态化能力
一旦切到backup,后端应用服务大概率已失联或严重延迟,此时backup节点若仍依赖远程Redis或数据库,就会变成“假备用”。因此它应具备:
- 本地只读缓存:预加载商品基础信息、活动状态、通用文案等,用LRU内存缓存(如Nginx内置的shared memory zone);
- 静态化兜底页:将“活动已结束”“系统繁忙请稍后再试”等高频提示页编译为纯HTML文件,由Nginx直接返回,零后端依赖;
- 轻量API网关逻辑:用OpenResty内置Lua校验用户Token有效性、拦截明显异常UA,避免无效请求穿透到下游。
必须配套的监控与演练机制
backup配置上线却不验证,等于没配。每次大促前需完成三项动作:
- 模拟主集群全节点主动摘除,确认backup节点能否在3秒内接管并返回有效响应;
- 压测backup节点自身极限——它可能只能扛住1/10主集群QPS,要明确标注其容量水位(如“最高支撑5000只读QPS”);
- 在Prometheus中设置专项告警:当upstream_backup_requests_total指标非零且持续超过30秒,立即触发SRE人工介入核查原因。
backup不是万能解药,但它让系统从“要么全好、要么全崩”变成“部分可用、体验可控”。这正是大促稳定性最关键的分水岭。
















