


软中断(NET_RX)单核瓶颈是根本原因,需通过启用网卡多队列、绑定硬中断、配置RPS、对齐Nginx worker亲和性并调优配套参数来协同解决。
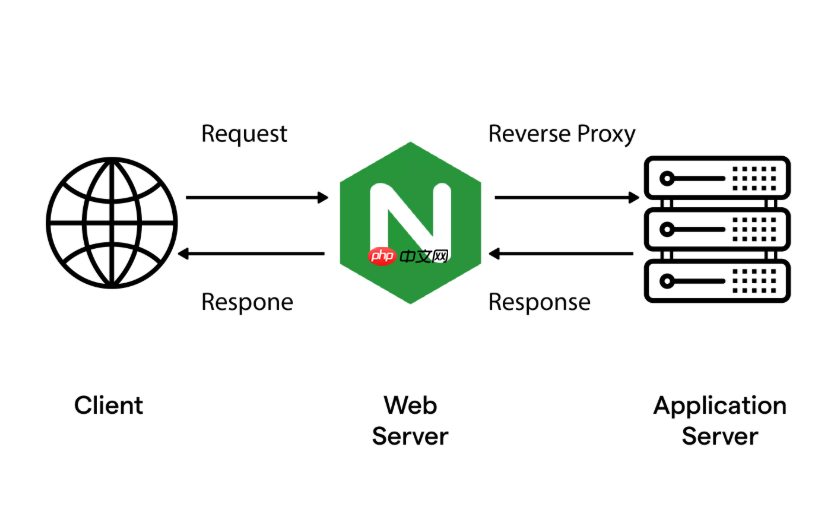
问题核心不在 Nginx Worker 本身“扛不住”,而在于网络数据从网卡进来的第一关——软中断(NET_RX)就卡死在单个 CPU 上。Worker 再多,也得等内核把包从网卡收进来、放进 socket 缓冲区,才能开始处理。如果 NET_RX 全挤在 CPU0,那所有 Worker 都在干等,连接堆积、延迟飙升、recv-q 持续积压,就是典型表现。
确认是否真被软中断拖垮
别猜,先看数据:
- 运行 watch -n 1 'cat /proc/softirqs | grep NET_RX',观察各 CPU 列数值增长速度。若 CPU0 的值是 CPU1–CPU7 的 3–5 倍以上,就是明显偏斜
- 同时跑 top -H,找 ksoftirqd/0 这类线程,看它是否长期占满一个核(si% > 25%)
- 查 cat /proc/interrupts | grep eth0,确认硬中断(如 IRQ 45、46)是否也全落在同一 CPU —— 若是,说明底层没开多队列,软中断无从分散
- 检查 /proc/net/softnet_stat 第二列(dropped)是否持续上涨,这是 backlog 队列溢出的直接证据
打开网卡多队列并绑定硬中断
单队列网卡天生只能打一个 CPU,必须升级为多队列模式:
- 查支持能力:ethtool -l eth0,看 Combined 最大值(如显示 8,代表最多支持 8 队列)
- 启用接收队列:ethtool -L eth0 rx 8 tx 8(部分虚拟网卡需额外开启 virtio-net multiqueue)
- 验证队列生成:ls /sys/class/net/eth0/device/msi_irqs/ 应出现 8 个 IRQ 目录
- 手动绑定每个 RX 队列中断到不同 CPU:
例如将 IRQ 45 绑 CPU0、IRQ 46 绑 CPU1……执行:
echo 0 > /proc/irq/45/smp_affinity_list
echo 1 > /proc/irq/46/smp_affinity_list
(注意:生产环境建议关闭 irqbalance,避免自动漂移)
用 RPS 均衡软中断负载
即使开了多队列,某些场景(如单队列网卡或 RSS 不生效时)仍需 RPS 补位:
- 对每条 RX 队列启用 RPS:echo ffff > /sys/class/net/eth0/queues/rx-0/rps_cpus(16 核用 ffff;8 核用 ff;按实际逻辑 CPU 数转十六进制)
- RPS 是纯软件分发机制,不依赖硬件 RSS,适合云环境或虚拟网卡
- 配合 RFS(Receive Flow Steering)可提升 cache 局部性,但非必需,先确保 RPS 生效即可
让 Nginx Worker 与网络处理核对齐
光分散软中断不够,Worker 必须和收包 CPU 同核运行,减少跨核搬运和缓存失效:
- 设 worker_processes auto; 或显式为逻辑 CPU 总数(如 8 核就写 8)
- 配置 worker_cpu_affinity,严格一一对应:
8 核服务器示例:
worker_cpu_affinity 00000001 00000010 00000100 00001000 00010000 00100000 01000000 10000000; - 加 worker_priority -20 提升调度权重,确保高负载时不被抢占
- 同步关闭 accept_mutex off;(Nginx ≥ 1.11.3 默认已关),避免 worker 争抢 accept 锁
配套调优不能少
这些动作要一起做,缺一不可:
- 提高文件描述符上限:worker_rlimit_nofile 65535;,并确保启动前执行 ulimit -n 65535,系统级调大 fs.file-max
- 增大单次事件处理量:multi_accept on;
- 调高连接并发数:worker_connections 65535;
- 验证是否生效:ps -eo pid,args,psr | grep 'nginx: worker' 看每个 worker 是否真跑在预期 CPU 上;taskset -cp <PID> 查亲和掩码是否匹配










