


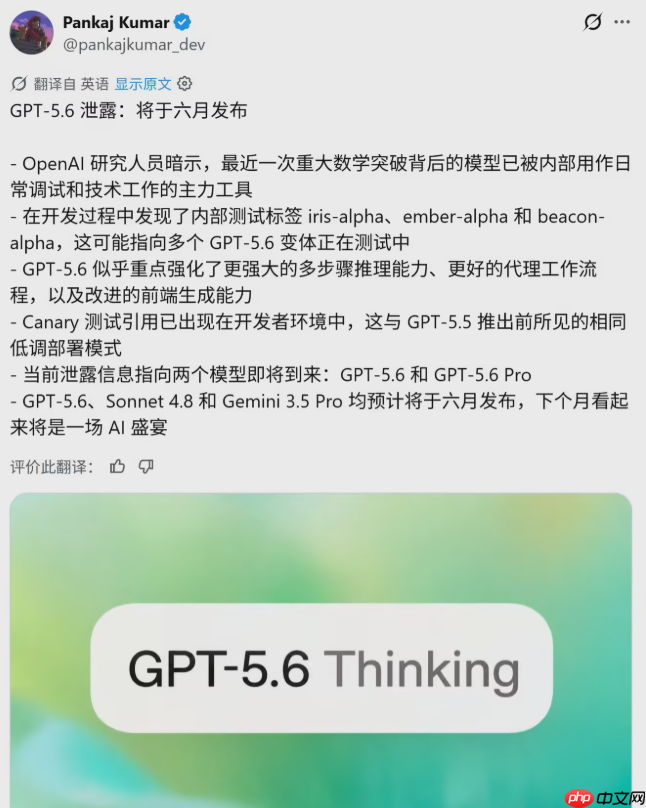
近日,多位开发者在 openai codex 后端日志中发现了若干尚未正式发布的模型线索,其中代号为 "iris-alpha" 的 gpt-5.6 模型以高达 150万 token 的上下文窗口引发广泛关注。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
技术跃迁:150万 Token 的“超长记忆”新纪元
依据被披露的日志数据,GPT-5.6 系列在上下文建模能力方面实现了质的飞跃:
- 容量跃升: 其上下文窗口扩展至 150万 Token,相较当前公开的 GPT-5.5 API(105万 Token)提升约43%;
- 极限稳定性: 在基于 OpenCode 框架的压力测试中,该模型于输入达90万 Token 时仍保持响应流畅;即便输入突破105万 Token,任务完成准确率依旧维持在高位;
- 工程价值凸显: 此类能力使模型可高效支撑整套法律协议的逐条比对、百万行级代码库的跨模块分析,以及覆盖多日甚至数周的项目全周期追踪,显著缓解开发者在复杂协作场景中因上下文截断导致的“语义遗忘”。
除 iris-alpha 外,日志中还浮现了代号 "ember-alpha" 与 "beacon-alpha" 的其他模型标识。业界普遍认为,这可能是 GPT-5.6 系列面向差异化应用场景(如低延迟轻量任务或视觉增强型推理)所构建的专项变体。
效能升维:从“写代码”到“造界面”
GPT-5.6 的另一项关键演进体现在前端界面生成能力上。泄露的交互截图显示,在极为简洁的指令驱动下,模型即可直接产出名为“Lumen Notes”的完整记事类应用 UI 结构。

将小说章节转换为电影分镜剧本。用户上传txt/md/docx文本,AI分析场景、角色、情绪、镜头语言,输出专业分镜脚本。适用于用户提及“分镜”“storyboard”“小说转分镜”“影视改编”“镜头脚本”或需要将小说改编为分镜的场景。
与过往多数 AI 所生成界面常出现布局松散、层级模糊等问题不同,GPT-5.6 展现出高度统一的设计语言:
- 架构严谨: 采用标准化栅格系统,导航逻辑清晰、功能分区明确;
- 视觉审慎: 配色方案贴合主流设计系统规范,留白合理、对比克制;
- 落地就绪: 实现从底层代码片段输出到可交付 UI 界面的闭环,标志着大模型正加速攻克前端开发链条中最难自动化的环节。
6月:全球头部AI厂商的“临界点之战”
GPT-5.6 的提前曝光并非偶然事件,整个AI产业正悄然集结于2026年6月这一关键节点,酝酿一场集中式技术爆发:
- OpenAI: GPT-5.6(iris-alpha)
- Anthropic: Claude Sonnet 4.8
- Google: Gemini 3.5 Pro
- xAI: Grok 5
随着150万 Token 上下文成为新一代模型标配,AI领域的竞争重心已悄然转移——不再局限于参数规模的数字竞赛,而是聚焦于长程任务理解深度与真实工程场景交付效率的双重较量。对一线开发者而言,这场发生在六月的模型混战,或将真正重塑AI赋能软件开发的核心范式。














