




proxy_next_upstream http_502 是应对后端瞬时崩溃的关键配置,需配合 error/timeout、max_fails 健康检查及 proxy_next_upstream_tries/timeout 控制重试,且仅在后端真实返回502时生效。
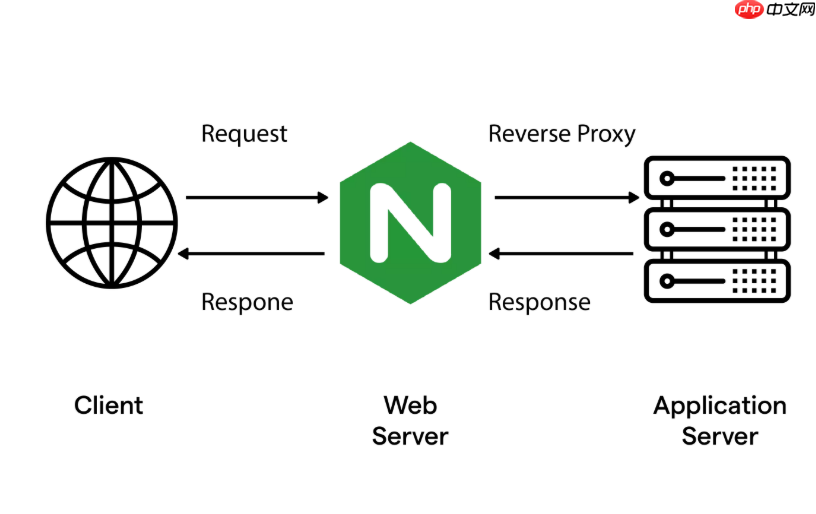
在 Nginx 中启用 proxy_next_upstream http_502 是应对后端节点瞬时崩溃(如进程闪退、连接重置、空响应)的关键配置,但它本身不“自动规避”,必须配合健康检查、合理超时和上游分组策略才能真正生效。
基础配置:启用 502 触发重试
该指令告诉 Nginx:当从某个 upstream 节点收到 HTTP 502 响应时,不要立即返回错误,而是尝试下一个可用节点。需搭配 proxy_next_upstream_tries 和 proxy_next_upstream_timeout 控制重试行为:
- 在
location或server块中添加:proxy_next_upstream error timeout http_502;
(error覆盖连接失败,timeout覆盖超时,http_502显式捕获网关错误) - 限制最多重试次数,避免雪崩:
proxy_next_upstream_tries 3; - 限制整个重试过程总耗时(含首次请求):
proxy_next_upstream_timeout 10s;
必须配套:定义带健康探测的 upstream
仅靠 http_502 重试不够——若节点已持续崩溃,每次请求仍会先打过去再失败,浪费资源并延长延迟。应启用主动健康检查:

WebChat Voice Proxy
下载
⚠️ 已弃用 — 该技能已拆分为两个独立技能,以提升模块化程度:**webchat-https-proxy**(HTTPS/WSS 反向代理)和 **webchat-voi...**
- 使用 Nginx Plus 或开源版 +
nginx-upstream-check-module编译模块; - 或采用更轻量的被动健康检查(推荐初阶部署):
upstream backend {<br> server 10.0.1.10:8080 max_fails=3 fail_timeout=30s;<br> server 10.0.1.11:8080 max_fails=3 fail_timeout=30s;<br>}
其中max_fails统计连续失败(含 502、超时、连接拒绝),达到阈值后该节点被临时摘除fail_timeout秒。
关键细节:确保 502 真由后端产生,而非 Nginx 自身
Nginx 只有在明确收到上游返回的 502 状态码时才触发该逻辑。常见误区:
- 如果后端进程崩溃导致连接被拒绝(Connection refused),Nginx 默认归为
error,需显式写入proxy_next_upstream error才重试; - 如果后端返回空响应或提前关闭连接(如 “upstream prematurely closed connection”),这属于协议异常,Nginx 不视为 HTTP 502,需靠
error或timeout捕获; - 确认后端应用确实返回了
502(而非 500/503),否则该指令无效。
增强容错:结合 proxy\_intercept\_errors 与自定义错误页
避免用户看到原始 502 页面,同时保留日志可追溯性:
-
proxy_intercept_errors on;—— 让 Nginx 拦截后端返回的 4xx/5xx 并交由error_page处理; -
error_page 502 = @fallback;—— 将拦截到的 502 转向备用逻辑(如静态降级页、兜底 API); - 但注意:
proxy_intercept_errors会屏蔽真实状态码,不利于监控,生产环境建议仅用于用户体验兜底,核心容错仍依赖proxy_next_upstream。














