


NUMA架构下Nginx调优核心是绑定worker进程至本地CPU与内存:需用lscpu、numactl --hardware等命令确认拓扑,worker_processes设为单节点物理核数(非auto或总数),worker_cpu_affinity按节点分段配置,并通过numactl --cpunodebind --membind启动,确保numastat中本地内存占比>95%、numa_foreign≈0。
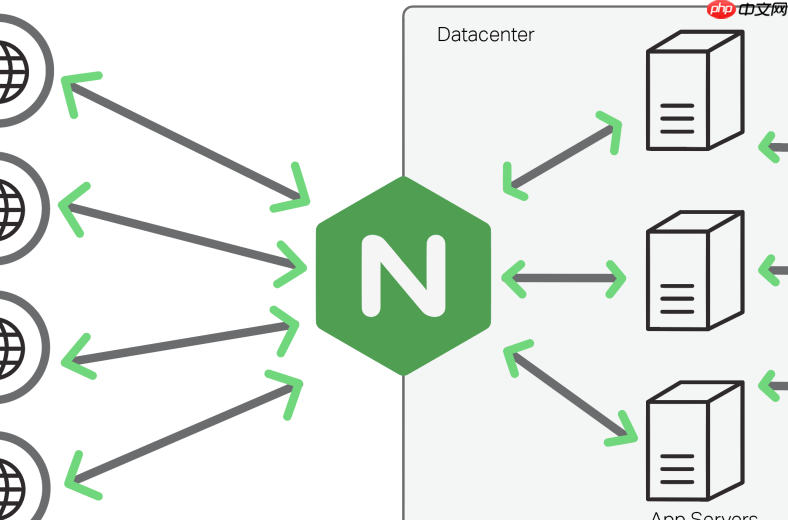
在多路 CPU 的 NUMA 架构服务器上,Nginx 性能瓶颈往往不来自 CPU 算力,而是跨节点内存访问带来的延迟飙升。真正有效的调优,是让每个 worker 进程只用本地 CPU + 本地内存,切断 QPI/UPI 总线上的争抢。
确认真实 NUMA 拓扑再动手
别凭逻辑核数猜配置。先执行三组命令看清硬件布局:
- lscpu | grep -E "(Socket|Core|NUMA)" → 查清插槽数、每槽物理核数、NUMA 节点总数
- numactl --hardware → 看每个 node 的 CPU 编号范围和本地内存容量(例如 node 0: CPUs 0–31, 64GB)
- cat /sys/devices/system/node/node*/cpulist → 精确到每个核心归属,避免掩码错位
若 BIOS 中启用了 Node Interleaving,numactl 输出会显示单个大节点,实际已失去 NUMA 局部性——必须进 BIOS 关闭该选项。

worker_processes 必须匹配单节点物理核心数
设为 auto 或总逻辑核数是常见错误。比如双路 32 核(每路 16 物理核),应设:
- worker_processes 16(每节点 16 个 worker),或更保守地设为 8~12 留出资源余量
- 禁用 worker_processes auto:它只读 /proc/cpuinfo 总数,不感知 NUMA 边界,实测易导致一半 worker 跑在远端节点,numa_foreign 指标翻倍
- 不要设为 32(总物理核)或 64(超线程总数):前者可能触发跨节点调度,后者让 worker 争抢 L3 缓存带宽
CPU 与内存绑定必须同步生效
仅靠 worker_cpu_affinity 绑定 CPU 不够,Nginx 自身无法控制内存分配位置:
-
worker_cpu_affinity 要按节点分段写:双路 16 核/插槽示例:
worker_cpu_affinity 0000000000000001 0000000000000010 ... ; # node 0 的 16 个核心
worker_cpu_affinity 00000000000000010000000000000000 ... ; # node 1 的 16 个核心 -
必须用 numactl 启动:修改 systemd 服务文件,ExecStart 改为:
/usr/bin/numactl --cpunodebind=0 --membind=0 /usr/sbin/nginx -g 'daemon on; master_process on;' - 若需双节点负载,改用 --cpunodebind=0,1 --membind=0,1,但更推荐单节点部署 + 外部负载分发,避免共享内存区跨节点访问
验证是否真正落地
不能只看 taskset 或 ps 输出的 CPU ID。关键指标是内存访问路径:
- 查 Nginx worker 进程 PID:ps -eo pid,comm,args | grep 'nginx: worker'
- 运行 numastat -p PID:理想情况下,Total 和 Huge Total 行中本地 node 占比应 >95%,numa_foreign 应接近 0
- 配合 perf 验证:perf stat -e mem-loads,mem-stores,cycles,instructions -p PID,观察 mem-loads 的平均 cycle latency 是否回落至本地内存水平(通常












