


worker_connections是配置参数而非可观测指标,其与系统资源共同决定可支撑连接数上限;理论最大值=worker_processes×worker_connections,但须满足ulimit、worker_rlimit_nofile和fs.file-max三条件,并需排查端口、监听队列、内存等真实瓶颈。
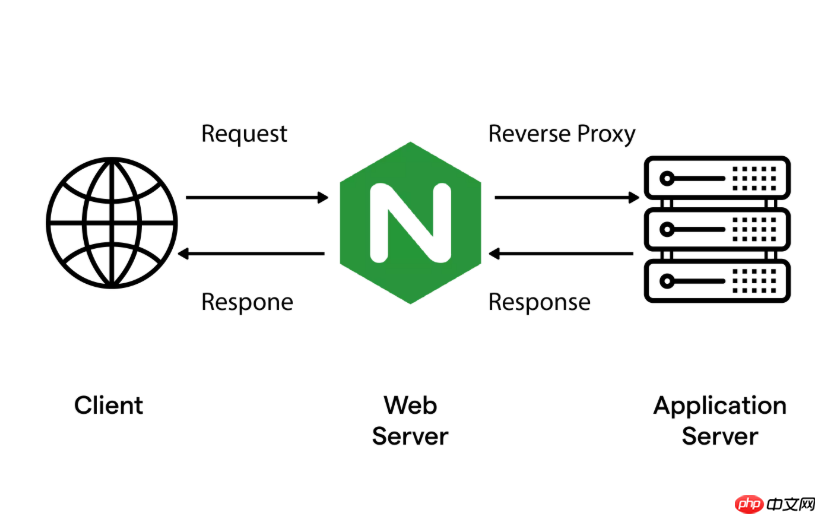
worker_connections 本身不是可观测指标,而是配置参数;真正能用于预测并发极限的,是它与系统资源限制共同构成的“可支撑连接数上限”,以及运行时实际占用情况。预测的关键不在于单看这个数字,而在于验证它是否在各层级真实生效、是否被其他瓶颈卡住。
明确理论上限:先算出最大可能值
理论最大并发连接数 = worker_processes × worker_connections。例如配置了 worker_processes auto;(8 核机器即为 8)和 worker_connections 16384,理论值就是 131072。
但这个数字只是起点——它必须同时满足三个硬性条件才能成立:
- 当前 nginx worker 进程的 ulimit -n ≥ 该乘积(用 cat /proc/$(pgrep nginx)/limits | grep "Max open files" 查)
- Nginx 主配置中设置了 worker_rlimit_nofile ≥ 该乘积(推荐设为相同值或略高)
- 系统全局句柄上限 /proc/sys/fs/file-max ≥ 该乘积 × 1.2~1.5(预留 TIME_WAIT、日志、缓存等开销)
识别真实瓶颈:不止是文件描述符
即使上述三项都达标,系统仍可能提前达到极限。需同步检查:
- 临时端口耗尽:反向代理场景下,每个 upstream 连接要占一个本地端口。检查 net.ipv4.ip_local_port_range(默认 32768–65535,仅约 32K 可用),高并发时建议扩至 1024 65000
- 监听队列溢出:net.core.somaxconn 过低(默认常为 128)会导致新连接在内核层就被丢弃,表现为请求无响应而非 502/503
- 内存压力:每个空闲 keepalive 连接约占用 128–256 KB 内存。8GB 服务器若全用于 Nginx,实际支撑的空闲连接数可能仅 3 万左右,远低于文件句柄理论值
用运行时数据反推剩余容量
不要只依赖配置,要结合实时状态做判断:
- 启用 stub_status 模块,访问 /nginx_status 查看 Active connections 实时值。持续接近理论上限(如达 90% 以上)就说明逼近瓶颈
- 用 ss -s | grep "tcp:" 观察 inuse 和 orphans 数量,大量 orphaned sockets 常意味着 TIME_WAIT 回收慢或连接异常中断
- 监控 error.log 中是否频繁出现 accept() failed (24: Too many open files) —— 这是文件描述符真正耗尽的直接证据
结合业务特征做动态预估
静态数字无法反映真实负载,需按流量类型加权估算:
- 纯静态资源(图片、JS):连接生命周期短,worker_connections × worker_processes 接近实际吞吐能力
- HTTP/2 或 WebSocket 长连接:1 个连接承载多请求,但连接长期驻留,更吃内存和总连接数上限
- 反向代理后端响应慢:1 个客户端连接会锁住 1 个上游连接,实际并发能力≈理论值 ÷ 2(甚至更低)











