








直接看$upstream_addr字段最可靠,它记录请求实际转发的后端地址(IP:Port),结合时间窗口聚合统计可快速识别请求倾斜;需过滤“-”“*”异常值,并联动$status和$upstream_response_time交叉验证根因,再通过stub_status与upstream状态确认健康检查是否生效。
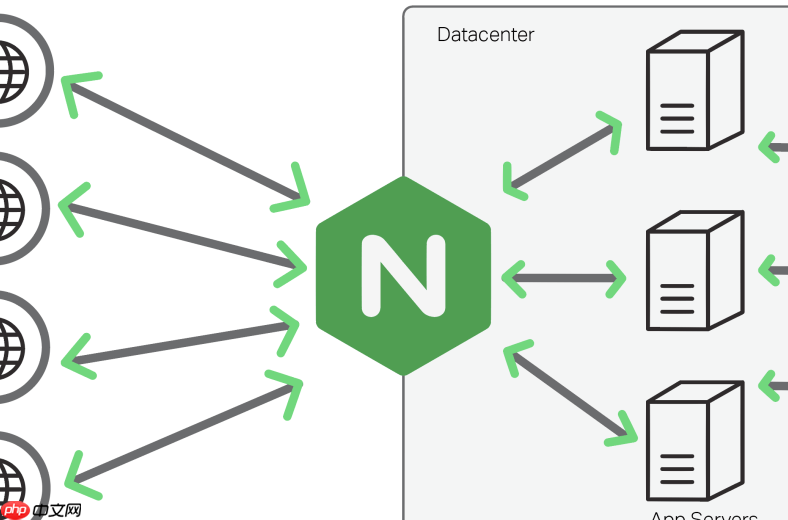
直接看 $upstream_addr 字段,就能确认每个请求真实落到哪台后端——它不是配置里的“理论列表”,而是 Nginx 实际建立连接的节点地址(IP:Port)。Worker 负载不均往往表现为某些后端请求数远超其他机器,而 $upstream_addr 正是验证这种倾斜最直接的依据。
用日志快速识别请求分配倾斜
在 access.log 中按时间窗口聚合统计各后端出现频次,是发现不均的第一步。确保 log_format 已包含 $upstream_addr 和 $time_local:
- 提取最近 5 分钟内各后端请求数:
awk '$4 > "['$(date -d '5 minutes ago' +[%d/%b/%Y:%H:%M)']" {print $NF}' /var/log/nginx/access.log | cut -d',' -f1 | grep -v '[-*]' | sort | uniq -c | sort -nr - 结果中若某 IP:Port 出现次数是其余节点的 2 倍以上,且持续数分钟,基本可判定分配异常
- 注意过滤掉 “-”(未转发)和 “*”(重试失败标记),避免干扰统计
结合状态码与响应时间交叉验证根因
单纯请求数多不等于有问题,需联动 $status 和 $upstream_response_time 判断是否真存在隐性瓶颈:

- 查高频出错的后端:
awk '$4 ~ /^5[0-9]{2}$/ {print $NF}' access.log | grep -v '[-*]' | sort | uniq -c | sort -nr - 查响应慢的主力节点(>2s):
awk '$5 > 2 {print $NF}' access.log | grep -v '[-*]' | sort | uniq -c | sort -nr - 两个结果取交集:既高频报错又长期慢响应的地址,大概率是健康检查未生效、连接未释放或资源过载的真实故障点
区分算法特性,排除误判场景
不同负载策略下 $upstream_addr 的分布逻辑不同,不能一概而论“不均=配置错”:
-
ip_hash 场景下,大量请求集中在同一后端很常见——检查 $remote_addr 前缀分布:
awk '{print substr($1,1,index($1,".")-1)}' access.log | sort | uniq -c | sort -nr | head -5
若频繁出现 10.128、192.168 等私有网段前缀,说明 NAT 网关用户被哈希到同一节点,属算法固有局限 - least_conn 在长连接场景可能“失灵”:连接未及时关闭,导致新请求仍倾向已建连节点;此时 $upstream_addr 高频出现某地址,但 $upstream_response_time 并不长,需检查 keepalive timeout 和后端连接回收逻辑
- 启用 proxy_next_upstream 时,$upstream_addr 可能含多个地址(如 192.168.1.10:8080, 192.168.1.11:8080),说明发生重试——若重试集中于特定路径,反映该链路稳定性差,非 Worker 分配问题
配合 stub_status 与 upstream 状态做最终确认
日志分析只是起点,还需通过运行时指标佐证:
- 访问 /nginx_status 查看全局连接数、接受请求数,确认是否整体过载
- 检查 upstream 模块状态:是否有 server 显示 down 或 unavail,却仍在 $upstream_addr 中高频出现?说明健康检查失效或配置未生效
- 若后端主动返回 X-Backend-ID 等标识头,可在日志中加 $upstream_http_x_backend_id 字段,比对是否与 $upstream_addr 一致,排除代理链路错位

















