


$request_time 是客户端到 Nginx 全链路耗时,$upstream_response_time 仅是 Nginx 与后端交互耗时;前者总≥后者,差值反映客户端网络或 Nginx 处理开销,组合分析可定位后端、网络或配置问题。
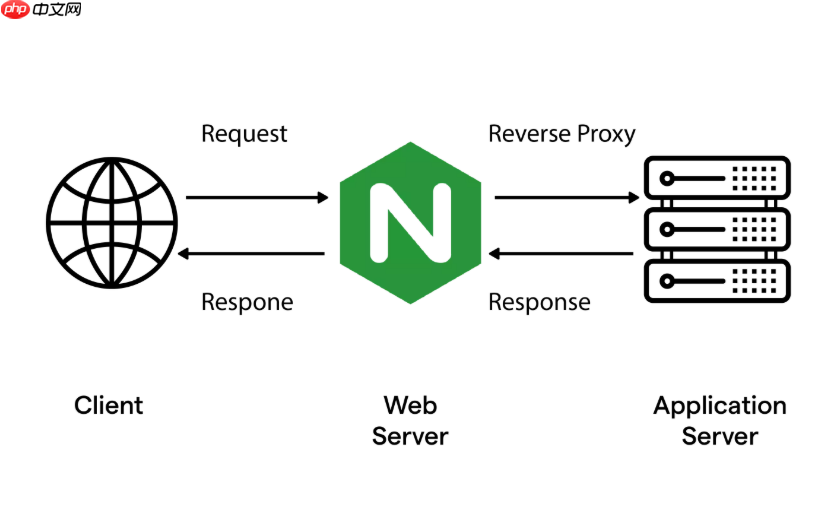
$request_time 和 $upstream_response_time 看似都是“耗时”,但它们记录的不是同一段过程,而是 HTTP 请求生命周期中两个不同角色的时间切片。
各自定义:起点和终点完全不同
$request_time 是从客户端发来第一个字节开始,到 Nginx 把最后一个响应字节发给客户端结束。它覆盖整条链路:接收请求 → 转发给后端 → 等待后端响应 → 发送响应回客户端。
$upstream_response_time 仅聚焦于 Nginx 和后端服务之间的交互:从 Nginx 向后端发起连接(或复用连接)开始,到收完后端返回的全部响应数据为止。它不关心客户端网络多慢、也不管 Nginx 自己有没有做 gzip 或大文件缓存。
数值关系:$request_time 总是 ≥ $upstream_response_time
正常情况下,$request_time 明显大于 $upstream_response_time,尤其在以下场景:

- 客户端上传大文件或 POST 大 body:Nginx 需要先完整接收再转发,这部分时间只计入 $request_time
- 响应体很大(如下载 5MB 文件):Nginx 发送响应给客户端耗时长,这部分也只算在 $request_time 里
- 客户端网络差、带宽低或频繁丢包:传输阶段拉长,但后端早已返回,$upstream_response_time 不受影响
当两者非常接近(例如差值
精度与误差:不能直接相减做毫秒级归因
Nginx 内部对这两个字段使用了不同的时钟源:
- $upstream_response_time 默认基于 CLOCK_MONOTONIC_COARSE,精度约 4ms,适合高频日志,但存在舍入偏差
- $request_time 使用更高精度时钟,更贴近真实耗时
因此可能出现 $upstream_response_time > $request_time 的反直觉现象(比如记录为 0.004s vs 0.002s),这不是数据错误,而是低精度计时器的固有抖动。分析时应关注 >100ms 的请求,忽略毫秒级微小倒挂。
实战定位:靠对比,而不是单看
单独看任一字段意义有限,关键在组合判断:
- 高 $upstream_response_time + 高 $request_time → 后端瓶颈(查慢 SQL、应用线程阻塞)
- 低 $upstream_response_time + 高 $request_time → 客户端侧或 Nginx 层问题(弱网、大响应体、proxy_buffering off、gzip 压缩耗 CPU)
- 高 $upstream_response_time + 低 $request_time → 几乎不可能,需检查日志格式是否错位或字段解析异常
- 大量请求 $upstream_response_time 为 “-” → 后端连接失败(超时、拒绝、DNS 解析失败)










