




“排队深度”指请求在Nginx upstream中因后端繁忙而等待分发的积压程度,可通过stub_status监控Waiting连接、upstream queue参数控制、nginx-lua-exporter采集排队时长、健康检查动态调权四类方法实现可观测与防控。
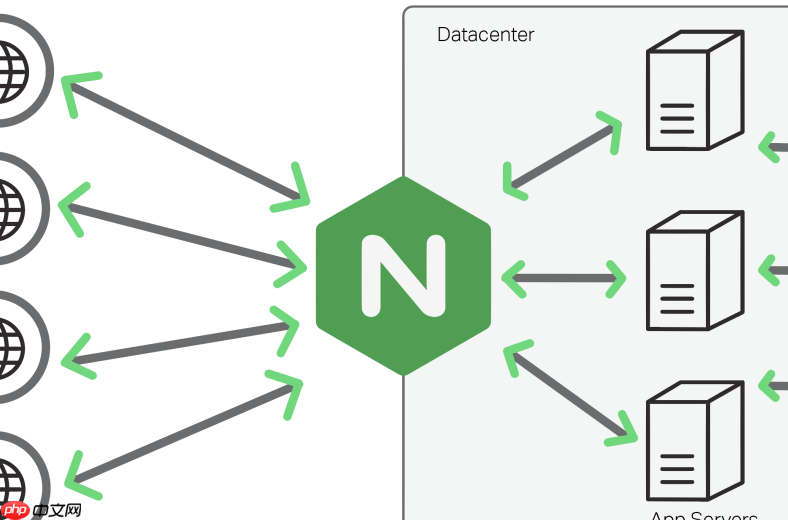
“排队深度”不是 Nginx 原生指标,它实际反映的是后端请求在 upstream 中的等待积压程度——即请求到达 Nginx 后,因所有 upstream 节点繁忙(连接池满、健康检查失败、超时未响应等),被迫在 Nginx 内部队列中等待分发的状态。Nginx 本身不暴露“当前排队请求数”,但可通过组合配置与可观测性手段实现等效监控和预警。
一、用 stub_status + 自定义日志识别排队迹象
Nginx 的 ngx_http_stub_status_module 可暴露活跃连接数、等待连接数(Reading/Writing/Waiting),其中 Waiting 表示已建立连接但尚未被 worker 处理的请求数,是排队压力的第一层信号:
- 启用状态页:
location /nginx_status { stub_status; allow 127.0.0.1; deny all; } - 定期采集
Active connections: X和Waiting: Y,当Y持续 > 50 或占X比例超 30%,说明请求开始积压 - 配合
log_format记录$upstream_addr和$upstream_response_time,异常时可发现大量请求集中打向少数节点(隐含排队)
二、通过 upstream 模块参数控制并暴露排队行为
真正影响排队的关键是 upstream 连接管理策略。以下配置能主动限制并暴露排队风险:

-
keepalive 32;:限制每个 worker 到单个后端的长连接数,超出则新建连接;若后端连接池小(如 Tomcat maxConnections=200),该值设太高反而加剧排队 -
queue 100 timeout=5s;(需 Nginx Plus 或开源版编译含ngx_http_upstream_queue_module):显式声明最多允许 100 个请求排队,超 5 秒未分配则返回 503 —— 此时即可将upstream_queue_time记入日志用于告警 - 若无 queue 模块,可用
max_conns=50+least_conn策略替代:当某节点已达最大并发连接,新请求自动转向负载更轻节点,间接缓解单点排队
三、用 Prometheus + nginx-lua-exporter 实现精准排队延迟监控
开源方案中,nginx-lua-exporter 可在 Lua 阶段捕获请求进入 upstream 前的等待时间:
- 在
upstream块前插入 Lua 代码,记录ngx.now()作为“入队时间” - 在
log_by_lua中读取ngx.var.upstream_connect_time与入队时间差,即为真实排队时长 - 暴露为 Prometheus 指标
nginx_upstream_queue_seconds,设置告警规则:rate(nginx_upstream_queue_seconds_sum[5m]) / rate(nginx_upstream_queue_seconds_count[5m]) > 0.8(平均排队超 800ms)
四、结合健康检查与动态权重预防排队恶化
排队常源于个别后端性能劣化却未及时剔除。应启用主动探测并联动权重调整:
- 使用
health_check interval=3 fails=3 passes=2(Nginx Plus)或upstream_check_module(开源版),每 3 秒探测/health - 探测失败时,不仅摘除节点,还可通过 Lua 动态降低其
weight(如从 10 降至 1),让流量缓慢回切,避免恢复瞬间涌入引发二次排队 - 配合
slow_start=30s,新恢复节点逐步承接流量,防止雪崩

















