


worker_connections 是 Nginx 并发能力的底层阀门,对 gRPC 流式传输尤为关键——因每个 gRPC 流持续占用一个连接,单 HTTP/2 连接无论含多少 stream 均占 1 个配额;需结合 ulimit、worker_processes、proxy_buffering off 等协同调优,推荐值 8192,总并发=worker_processes×worker_connections。
理解 gRPC 流与连接的真实开销
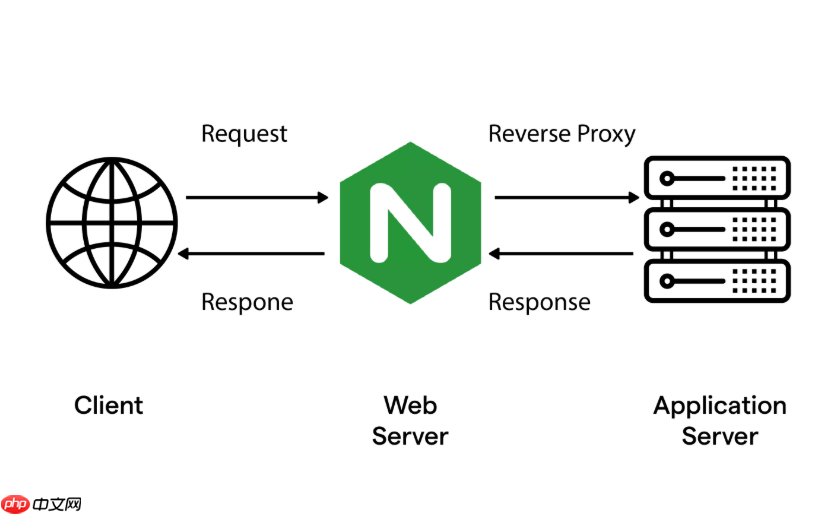
gRPC 基于 HTTP/2,单个 TCP 连接可复用多个并发流(stream),但 Nginx 作为反向代理时,默认按“连接粒度”而非“流粒度”做资源调度。也就是说:一个客户端建立的 HTTP/2 连接,只要还活着,就持续占用 1 个 worker_connections 配额,无论它里面开了 1 个还是 100 个 gRPC stream。所以不能只看 stream 数,更要看活跃连接数峰值。
合理设置 worker_connections 数值
这个值不是越大越好,需兼顾系统限制与实际负载:

- 先查系统级上限:
ulimit -n,确保不低于你计划配置的值(建议设为 65535 或更高) - 单 worker 进程推荐值:Linux 生产环境常见设为 4096~16384;若后端是高吞吐 gRPC 服务(如 LLM 推理流),建议起步用 8192
- 总并发能力 =
worker_processes × worker_connections;例如 4 核服务器配worker_processes auto(即 4)+worker_connections 8192→ 理论支持约 32768 个活跃连接 - 注意:若开启
http2_max_requests(默认 1000),连接会被主动断开重建,反而增加连接抖动——gRPC 流场景建议设为 0(不限制)或大幅提高
必须配套的关键配置项
单独调大 worker_connections 不起作用,必须协同优化:
-
关闭代理缓冲:
proxy_buffering off;—— 否则流式响应会被攒满缓冲才发,破坏实时性 -
精控缓冲区大小:
proxy_buffer_size 4k;+proxy_busy_buffers_size 16k;—— 够存响应头即可,避免内存滞留 -
启用 HTTP/2 和 keepalive:
http2 on;+keepalive_timeout 300s;—— 让客户端能稳定复用连接发多个 stream -
禁用 request body 缓存:
client_body_buffer_size 0;+client_max_body_size 0;—— gRPC 请求体由 Protobuf 编码,不走常规 body 解析路径,缓存反而拖慢
验证与压测要点
调完不能只看配置生效,要观察真实行为:
- 用
ss -tn state established | wc -l查当前 ESTAB 连接数,对比worker_connections × worker_processes - 检查错误日志是否有
"accept() failed (24: Too many open files)"—— 说明系统 ulimit 不足 - 用 grpcurl 或自研压测工具模拟多 client + 多 stream 场景,观测
Active connections和Reading/Writing/Waiting指标(通过stub_status模块) - 特别关注
Writing值是否长期高位:可能是后端响应慢或缓冲未及时刷出,需结合proxy_buffering和tcp_nodelay on;调整











