





Nginx可通过“实时请求监控+外部标记文件+map判断”实现自动维护模式:每分钟脚本分析日志请求量,超阈值写入标记文件,Nginx用map映射该文件状态,触发503并返回静态维护页,支持连续多分钟判定、手动退出及Retry-After头。
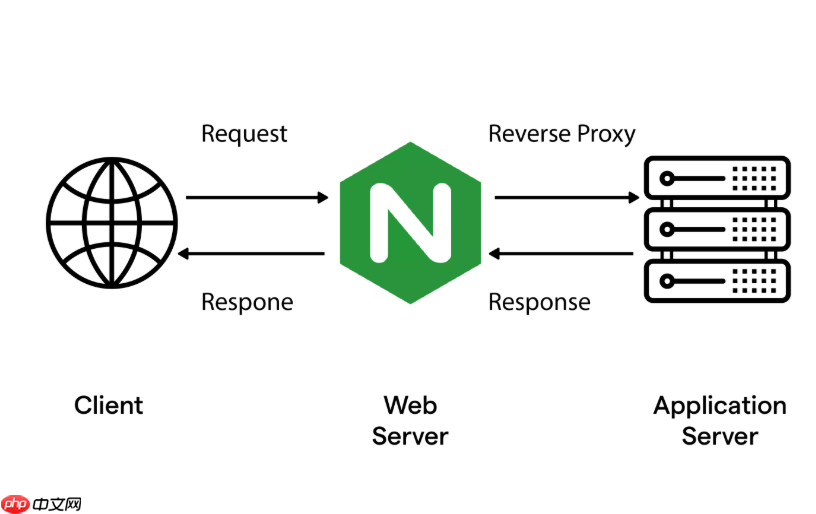
当网站遭遇突发大流量(如 CC 攻击、爬虫洪峰或误配定时任务刷量),Nginx 本身不内置“自动触发维护模式”的逻辑,但可通过轻量组合:实时请求速率监控 + 外部状态标记 + map 判断,实现无需人工干预的自动降级。核心是让 Nginx 快速识别异常负载,并把用户导向静态维护页,同时保护后端不被压垮。
用 limit_req 控制入口流量并标记异常
在 http 或 server 块中配置限流规则,同时用 $limit 配合 map 映射出是否超载:
- 定义一个限流区(按 IP 或 key):
limit_req_zone $binary_remote_addr zone=attack:10m rate=10r/s; - 在 location 中启用限流并捕获拒绝状态:
limit_req zone=attack burst=20 nodelay; - 利用 $limit_rate 变量(被限流时为 0)或自定义变量间接反映压力 —— 更推荐用外部脚本监听 nginx 日志中的 503/429 频次来判断是否持续过载
用日志频次 + cron 脚本生成维护标记文件
比单纯依赖限流更可靠的方式是:每分钟分析 access.log 中最近 60 秒的请求量,超阈值即写入维护标记:

- 写一个检查脚本(如
/usr/local/bin/check-attack.sh):#!/bin/bash<br>count=$(awk -v t=$(date -d '1 minute ago' +%s) '$4 > "["t" " {print}' /var/log/nginx/access.log | wc -l)<br>if [ "$count" -gt 500 ]; then<br> touch /var/run/nginx-under-attack<br>else<br> rm -f /var/run/nginx-under-attack<br>fi - 加入 crontab(每分钟执行):
* * * * * /usr/local/bin/check-attack.sh - 确保日志格式含时间字段(如
log_format main '$remote_addr - $remote_user [$time_local] ...';)
在 Nginx 中用 map 判断并统一返回维护页
在 http{} 块中添加状态映射,再在 server 块中生效:
map $document_root $under_attack {<br> default off;<br> ~*\/var\/run\/nginx-under-attack on;<br>}- 在对应 server 中加入:
if ($under_attack = on) {<br> return 503;<br>}<br>error_page 503 @maintenance;<br>location @maintenance {<br> root /usr/share/nginx/html;<br> try_files /maintenance.html =503;<br>} - 确保
/usr/share/nginx/html/maintenance.html存在且 Nginx 进程可读
补充建议:避免误判与快速恢复
自动切换要兼顾准确性和可控性:
- 不要仅靠单次高请求量触发,建议连续 3 分钟超阈值才写入标记,减少毛刺干扰
- 维护页内加一个手动关闭开关(如特定 URL 参数或 header),方便运维紧急退出:
if ($args ~ "force=live") { set $under_attack off; } - 开启
add_header Retry-After "300";告诉爬虫/客户端 5 分钟后再试,降低重试压力 - 记录触发日志:
access_log /var/log/nginx/attack-trigger.log if=$under_attack;














