


$upstream_connect_time可精准区分连接建立慢与后端处理慢,自Nginx 1.9.1原生支持,记录TCP三次握手耗时,配合日志分析能定位网络层或连接池问题。
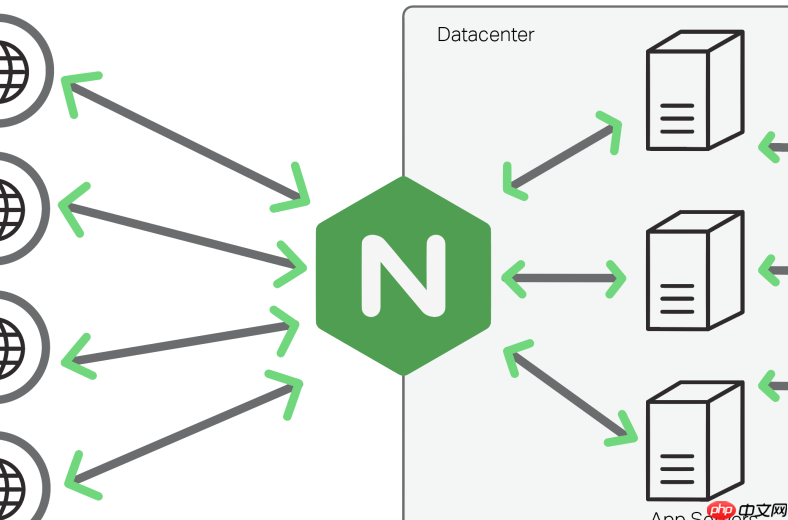
在 Nginx 网关场景中,仅靠 $upstream_response_time 无法区分“连接建立慢”还是“后端处理慢”。$upstream_connect_time 是关键突破口——它精确记录从 Nginx 尝试发起 TCP 连接到完成三次握手的时间(单位:秒,支持毫秒级精度),能直接暴露网关与后端之间网络层或服务端连接池的瞬时抖动。
确认 Nginx 版本与模块支持
该变量自 Nginx 1.9.1 起原生支持,但需确保:
- 使用的是官方主线版或主流发行版(如 Tengine、OpenResty 也兼容);
- 未禁用 http_upstream_module(默认启用,一般无需额外配置);
- 若使用旧版本(如 1.6.x),需升级或改用 $upstream_header_time 间接估算(不推荐)。
在 log_format 中安全引入变量
直接添加即可,无需额外指令。建议搭配其他 upstream 时间字段对比分析:

log_format main '$remote_addr - $remote_user [$time_local] "$request" '
' $status $body_bytes_sent "$http_referer" "$http_user_agent" '
' $upstream_addr $upstream_connect_time $upstream_header_time $upstream_response_time $request_time';
注意:
- $upstream_connect_time 在连接失败时为“-”,成功时格式如 0.002(2ms)或 0.125(125ms);
- 若后端是多实例(如 upstream backend { server a:80; server b:80; }),该值对应实际选中的上游地址;
- 不要与 $upstream_response_time 混淆:后者 = connect_time + header_time + response_body_time。
通过日志定位典型毛刺模式
采集足够量日志(建议至少 1 小时,高 QPS 场景可采样)后,用如下方式快速识别问题:
-
孤立高 connect_time:某次请求
$upstream_connect_time=0.320,但$upstream_header_time=0.003、$upstream_response_time=0.323→ 说明 99% 耗时花在建连,大概率是后端连接池满、SYN 队列溢出或中间网络设备限速; - 周期性 connect_time 抬升:每 60 秒出现一批 >100ms 的 connect_time → 检查后端是否在定时 reload、JVM Full GC 或容器平台执行滚动更新;
-
特定 upstream_addr 持续偏高:仅
10.10.2.5:8080的 connect_time 明显高于其他实例 → 定位该节点的系统负载、TCP 参数(如net.ipv4.tcp_tw_reuse)、防火墙策略或宿主机资源争抢。
联动排查与验证建议
单靠日志只能发现问题方向,需配合以下动作闭环:
- 用
tcpdump在网关侧抓包,过滤目标后端 IP,检查 SYN 重传、SYN+ACK 延迟(确认是否网络层丢包或延迟); - 在后端机器执行
ss -s查看tw(TIME_WAIT)数量、synrecv队列长度; - 检查 Nginx upstream 配置是否启用了
keepalive,未启用时高频短连接必然放大 connect_time 波动; - 对怀疑节点做
curl -w "@format.txt" -o /dev/null -s http://target/health(format.txt 含time_namelookup、time_connect),绕过 Nginx 直连比对。











