





nginx的worker_processes auto在容器中失效,因其通过sysconf(_SC_NPROCESSORS_ONLN)读取宿主机CPU核数,而非cgroup限制的可用vCPU;正确做法是解析/sys/fs/cgroup/cpu.cfs_quota_us等文件动态计算worker数。
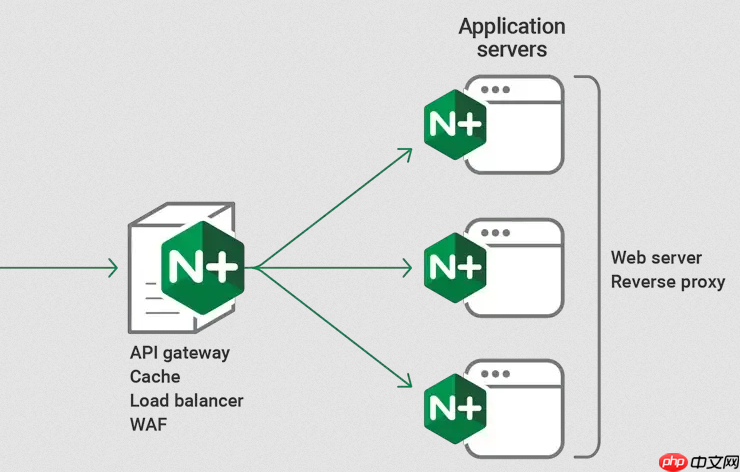
在云原生容器环境下,worker_processes auto 本身不会自动适配容器的 CPU 限制,它默认读取的是宿主机的逻辑 CPU 核心数,而非容器 cgroup 中实际可用的 CPU 资源。直接使用 auto 可能导致进程数远超容器分配的 CPU 配额,引发调度争抢、CPU 节流甚至 OOM 风险。
为什么 auto 在容器里容易失效
Nginx 启动时通过 sysconf(_SC_NPROCESSORS_ONLN) 获取在线 CPU 数,该系统调用返回的是宿主机总核心数,不感知容器的 cpu.shares、cpu.cfs_quota_us 或 cpusets 限制。例如:宿主机有 32 核,但容器仅被分配 2 个 vCPU,worker_processes auto 仍会启动 32 个 worker,严重过载。
正确识别容器可用 CPU 的方法
需主动从 cgroup 文件中读取容器实际可用的 CPU 资源,并据此设置 worker 数量:
-
读取 cgroup v1(常见于 Docker/K8s 旧版本):检查
/sys/fs/cgroup/cpu/cpu.cfs_quota_us和/sys/fs/cgroup/cpu/cpu.cfs_period_us。若quota > 0,则可用 CPU 数 ≈quota / period(向下取整,最小为 1) -
读取 cgroup v2(K8s 1.25+ 默认启用):检查
/sys/fs/cgroup/cpu.max,格式为"max [period]",如"200000 100000"表示 2 个 vCPU -
回退到
runtime.NumCPU()或nproc命令不可靠:Go 运行时或 shell 命令同样返回宿主机核数,不能替代 cgroup 解析
推荐配置方式(K8s 场景)
在容器启动前动态生成 nginx.conf:
- 用 initContainer 或 entrypoint 脚本解析 cgroup,计算出合理 worker 数(例如:取 cgroup CPU 上限与 Pod
resources.limits.cpu的较小值,再向上取整为 1、2、4、8 等常用值) - 将结果写入 nginx 配置模板,例如:
worker_processes {{ .CalculatedWorkers }}; - 确保容器内
/sys/fs/cgroup挂载可读(K8s 默认已挂载,无需额外设置)
简单安全的兜底策略
若无法修改启动流程,可手动设为固定值并匹配资源限制:
- Pod 中设置
resources.limits.cpu: "2"→ 配置worker_processes 2; - 避免使用
auto,也不建议设为大于 CPU limit 的值 - 配合
worker_cpu_affinity auto(Nginx 1.19.10+)可进一步减少跨核调度开销,但前提是 worker 数 ≤ 可用 CPU 数














