


proxy_cache_lock_timeout 控制缓存锁等待时长,需与 proxy_cache_lock on 及被动健康检查协同:超时后释放锁并推进等待队列,配合 max_fails/fail_timeout 和 proxy_next_upstream 实现故障转移与降级。
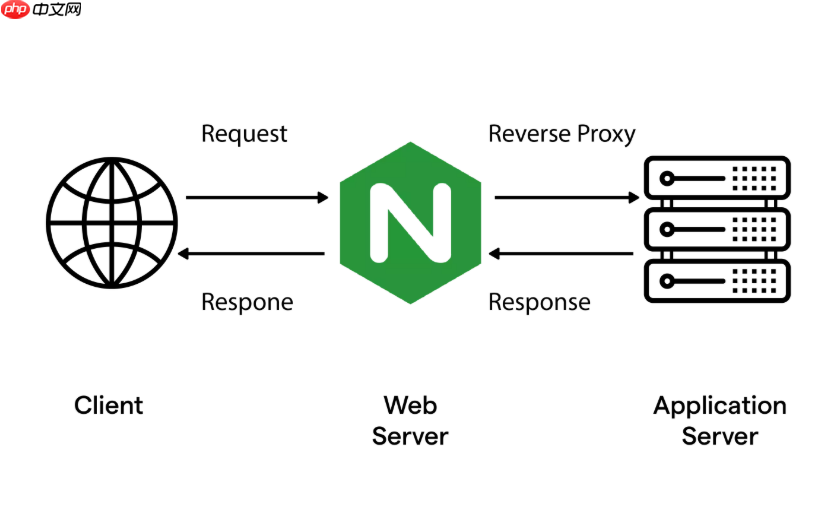
配置 proxy_cache_lock_timeout 本身不直接“实现缓存锁失效”,而是控制缓存锁的等待时长;它需与 proxy_cache_lock on 配合使用,并结合后端健康检查机制,才能在上游异常时避免请求长时间阻塞、加速失败判定与回退。关键在于:锁不是“失效”,而是“超时释放 + 故障转移协同”。
理解 proxy_cache_lock_timeout 的真实作用
当启用 proxy_cache_lock on 后,多个并发 MISS 请求中仅第一个被放行回源,其余请求进入等待队列。此时 proxy_cache_lock_timeout 定义的是:等待队列中的请求最多愿意等多久——若超时,Nginx 会释放当前锁,并允许下一个等待请求尝试获取锁、发起新回源。
- 默认值为 5 秒,建议根据上游平均响应时间设置,通常设为 2–3 倍的 proxy_read_timeout(例如 upstream 响应通常 1s 内完成,则设为 3s)
- 该超时 不触发自动重试或错误返回,只是让等待链“向前推进一格”
- 若上游持续无响应,可能引发多轮“一个接一个”的串行回源,而非并发爆发——这仍是可控的降级,不是崩溃
配合被动健康检查缩短故障感知延迟
单靠 proxy_cache_lock_timeout 无法解决上游卡死问题;必须让 Nginx 尽快将异常节点标记为不可用,从而把后续请求导向健康节点。这依赖 upstream 中的被动健康检查参数:

Bailian Usage Proxy
下载
阿里百炼大模型平台多人共享账号用量统计代理服务。解决公司共用账号时无法区分个人用量的问题。适用场景:1)部署用量统计代理;2)统计多人Token用量和调用次数;3)管理大模型API调用配额。
-
max_fails=2:连续 2 次失败即标记为不可用(比默认 1 更稳妥,避免偶发抖动误判) -
fail_timeout=10s:在 10 秒内累计失败达max_fails次,就禁用该节点;且此禁用期也为 10 秒 - 需确保
proxy_next_upstream包含error timeout(默认已有),这样当锁等待期间上游连接失败或读超时,Nginx 才会尝试换节点
实际生效的关键组合配置示例
以下片段放在 location 或 server 块中,体现协同逻辑:
proxy_cache_lock on;
proxy_cache_lock_timeout 3s;
proxy_cache_lock_age 6s;  # 允许每 6s 最多一次“补位回源”,防长尾
<p>proxy_next_upstream error timeout http_500 http_502 http_503 http_504;
proxy_connect_timeout 2s;
proxy_send_timeout 3s;
proxy_read_timeout 3s;</p><p>upstream backend {
server 10.0.1.10:8080 max_fails=2 fail_timeout=10s;
server 10.0.1.11:8080 max_fails=2 fail_timeout=10s;
}</p>- 当第一个请求因网络中断卡在
proxy_connect_timeout(2s)上,Nginx 立即标记该节点失败,并通过proxy_next_upstream转向另一台 - 若两台都失败,
proxy_cache_lock_timeout 3s到期后,第二个等待请求会尝试连接——但此时已无可用 upstream,直接返回 502 或走proxy_cache_use_stale(如已配置) -
proxy_cache_lock_age 6s防止“第一个请求挂起太久导致全队列饿死”,6 秒后允许再发一个请求探活,提升恢复灵敏度
避免常见误区
这个机制不是“自动熔断”或“智能降级”,它依赖明确的超时和失败信号:
- 不要依赖
proxy_cache_lock_timeout单独解决上游宕机问题——它只管锁等待,不管节点是否存活 - 如果 upstream 中没配
max_fails和fail_timeout,即使锁超时释放,后续请求仍会不断打向已瘫痪的服务器 -
proxy_cache_use_stale可作为补充(例如updating error timeout http_500),让锁等待期间能返回过期缓存,进一步缓解压力














